Self-Harness 是什么
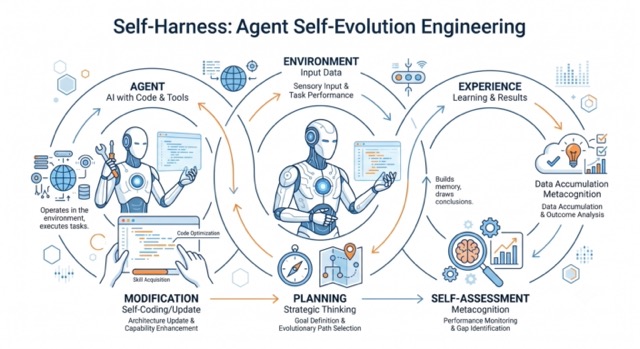
Self-Harness(论文:Self-Harness: Harnesses That Improve Themselves,arXiv 2606.09498)是一种让 LLM Agent 自动改进自身运行框架的范式。核心思想是:Agent 不需要人类工程师来调优它的 Harness,它可以自己发现自己的弱点、生成修改方案、验证修改是否安全,然后采纳有效的修改。
论文选择基于 DeepAgents(LangChain 的开源 Agent Harness)构建,但不是必须依赖 DeepAgents——任何以文本形式定义 Harness 的框架都可以应用这一范式。
三步迭代循环
1. 弱点挖掘(Weakness Mining)
从 Agent 的历史执行轨迹中自动识别模型特定的失败模式。这一步不是人类拍脑袋说"哪里有问题",而是系统性地分析大量执行日志,找出当前 Harness 在哪些场景下导致 Agent 表现不佳。
输出是一组具体的失败模式描述。例如:
- "模型在需要分步推理的工具调用中经常跳过中间步骤"
- "模型在遇到 API 错误时不会重试,直接放弃任务"
这三个例子并非论文原文,而是对 Weakness Mining 输出类型的合理说明。关键在于:失败模式的提取是自动、可重复的,不依赖人的直觉判断。
2. 框架提案(Harness Proposal)
基于识别出的失败模式,自动生成对 Harness 的具体修改方案。论文强调两条原则:
- 多样化(Diverse):同一种失败模式可以生成多个不同的修改方案,避免陷入局部最优
- 最小化(Minimal):每个提案只做最小的必要改动,不引入无关变更
修改的目标可以是 Harness 层中的任何文本组件:系统提示词模板、工具描述、错误处理规则、验证逻辑、配置文件等。
3. 提案验证(Proposal Validation)
这是 Self-Harness 最核心的安全机制。 每个候选修改必须通过回归测试(Regression Testing)才能被采纳。回归测试覆盖已有的全部能力场景,确保新修改不会"为了修一个 bug 而引入三个新 bug"。
只有通过全部回归测试的提案才会被正式采纳,然后进入下一轮迭代。
实验结果
论文在 Terminal-Bench-2.0 上,用一个极简初始 Harness,覆盖三个不同系列的基座模型:
三个模型一致提升,说明不是模型特化的运气,而是可复现的范式。
三种范式的全景对比
目前我们讨论了三种不同的"Agent 自我改进"方式,它们有本质的区别。
范式 A:传统自进化(Self-Evolution)
改什么:模型参数(weights)。
通过强化学习(RL、self-play、PPO/GRPO 等)迭代优化模型的参数。Agent 在与环境或自身交互的过程中产生训练信号,更新权重,提升下一次表现。
典型代表: AlphaGo 式 self-play、SPIN(Self-Play Fine-Tuning)、各种 RLHF/RL 后训练。
特性:
| |
|---|
| |
| |
| 通常无严格的门禁——训练完成后通过评估集确认效果,但无法逐轮验证"这次修改无害" |
| 高——需要保留旧 checkpoint,重训不可行 |
| |
| |
范式 B:Skill 进化(Hermes 技能系统)
改什么:知识库(技能文件)。
Agent 在执行任务后,将成功的经验提炼为可复用的 Markdown 技能文件。技能是对"怎么做某类任务"的程序化封装,下次遇到类似任务时自动加载。
特性:
| |
|---|
| |
| |
| 无内置验证门禁——技能生成后直接入库,有效性依赖后验。如果不好用,后续任务中自动调整或覆盖 |
| |
| |
| |
范式 C:Self-Harness
改什么:框架配置(Harness 层,包括 prompts、rules、tools 描述等)。
Agent 通过分析自己的执行轨迹,发现失败模式,对运行时框架进行文本级修改,并通过回归测试验证修改安全后采纳。
典型代表: Self-Harness 论文 + DeepAgents。
特性:
| |
|---|
| |
| |
| 强制回归测试——全部通过才采纳,这是三种范式中唯一内置验证门禁的方案 |
| |
| |
| 过度特化(在特定 benchmark 上过拟合)、通用能力下降 |
三者的关键差异
1. 修改对象
这是最根本的区别。
传统自进化改的是模型参数——模型"知道什么"、"擅长什么"——这是一个黑箱操作。你无法逐行 diff 一个 checkpoint,无法精确定位"这次训练改了哪部分能力"。
Skill 进化改的是知识——Agent 知道怎么做某事——操作对象是人类可读的 Markdown,完全透明、可控。
Self-Harness 改的是运行环境——Agent 怎么调用工具、怎么处理错误、怎么遵循规则——操作对象是框架配置文本,同样透明、可 diff、可测试。
- Skill 进化:改食谱(透明,可人工审阅,安全)
- Self-Harness:改工具箱(透明,有测试兜底,安全且系统化)
2. 验证机制
这是衡量"自我改进是否可控"的关键维度。
传统自进化没有逐轮的验证门禁——你训练完一个 epoch,跑一下评估集,看分数涨了还是跌了。但无法保证每一轮更新都是正向的,更无法断言"这次更新没有在提升 A 能力的同时暗地里损害 B 能力"。
Skill 进化完全没有验证门禁——技能生成后立即可用。如果技能写错了,Ag ent 只有在后续任务中失败时才会发现。
Self-Harness 是三者中唯一强制回归测试的。每轮提案必须通过全部已有 benchmark 的验证才能被采纳。这意味着它从设计上就内置了对"改进不可逆地损害已有能力"的防御。
3. 触发条件
传统自进化通常由数据触发——收集一批新数据,跑一轮训练。
Skill 进化由经验触发——完成一个任务后提炼技能,无论成功还是失败。
Self-Harness 由失败触发——Weakness Mining 从执行轨迹中找失败模式,没有失败就没有修改。这是一个"修复式"而非"积累式"的改进机制。
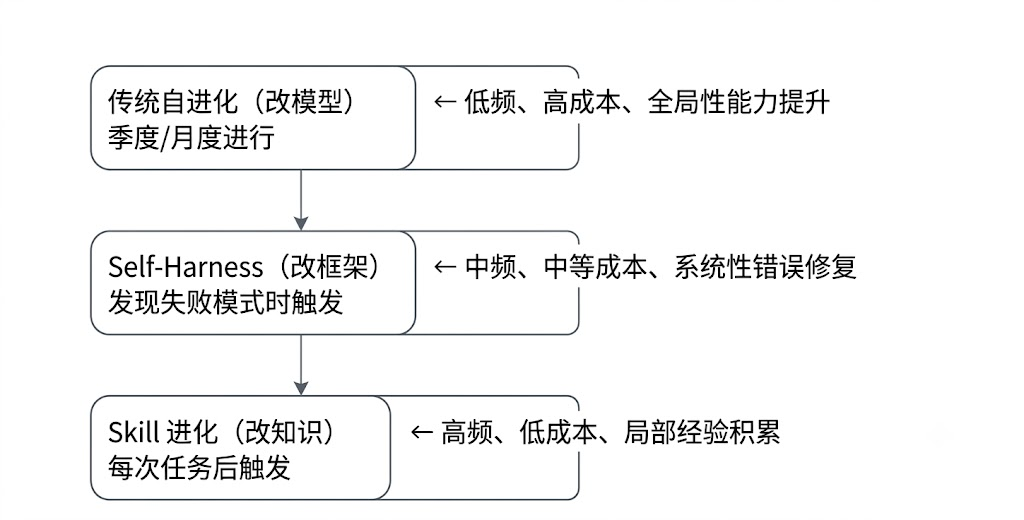
4. 成本与频率
传统自进化最贵、最慢:一次迭代小时到天,GPU 成本高,适合离线批量进行。
Skill 进化最便宜、最快:一次迭代秒级,几乎零计算成本,适合在线持续进行。
Self-Harness 介于两者之间:一次迭代秒到分钟,推理成本(分析轨迹、生成提案、运行回归测试)比 Skill 进化高,但远低于训练。适合按需进行——发现系统性失败模式时就跑一轮。
三者能否叠用
可以,而且理想情况下应该叠用。 三者不冲突,各自解决不同层次的问题。
举例一个理想的三层叠用场景:
- 传统自进化(月度):模型更新后,在目标场景上的基础能力从 60% 提升到 70%
- Self-Harness(按需):新模型在 Terminal-Bench 上在某些工具调用模式下存在系统性失败 -> Self-Harness 自动修改 Harness 配置,消除这些失败模式,让通过率从 70% 提升到 85%
- Skill 进化(每次任务):每次成功完成一个特定的复杂工作流后自动提炼为技能文件,持续积累专属场景的操作性知识
三层叠加后,Agent 的改进不是加法,而是乘法——各自优化不同层次,互不干扰。
总结一句话
三个范式对应三个层次的"自我改进",Self-Harness 填补了"改框架"这个之前被忽视的层次——比改模型安全可控,比改知识系统化可验证。
 AI 速览