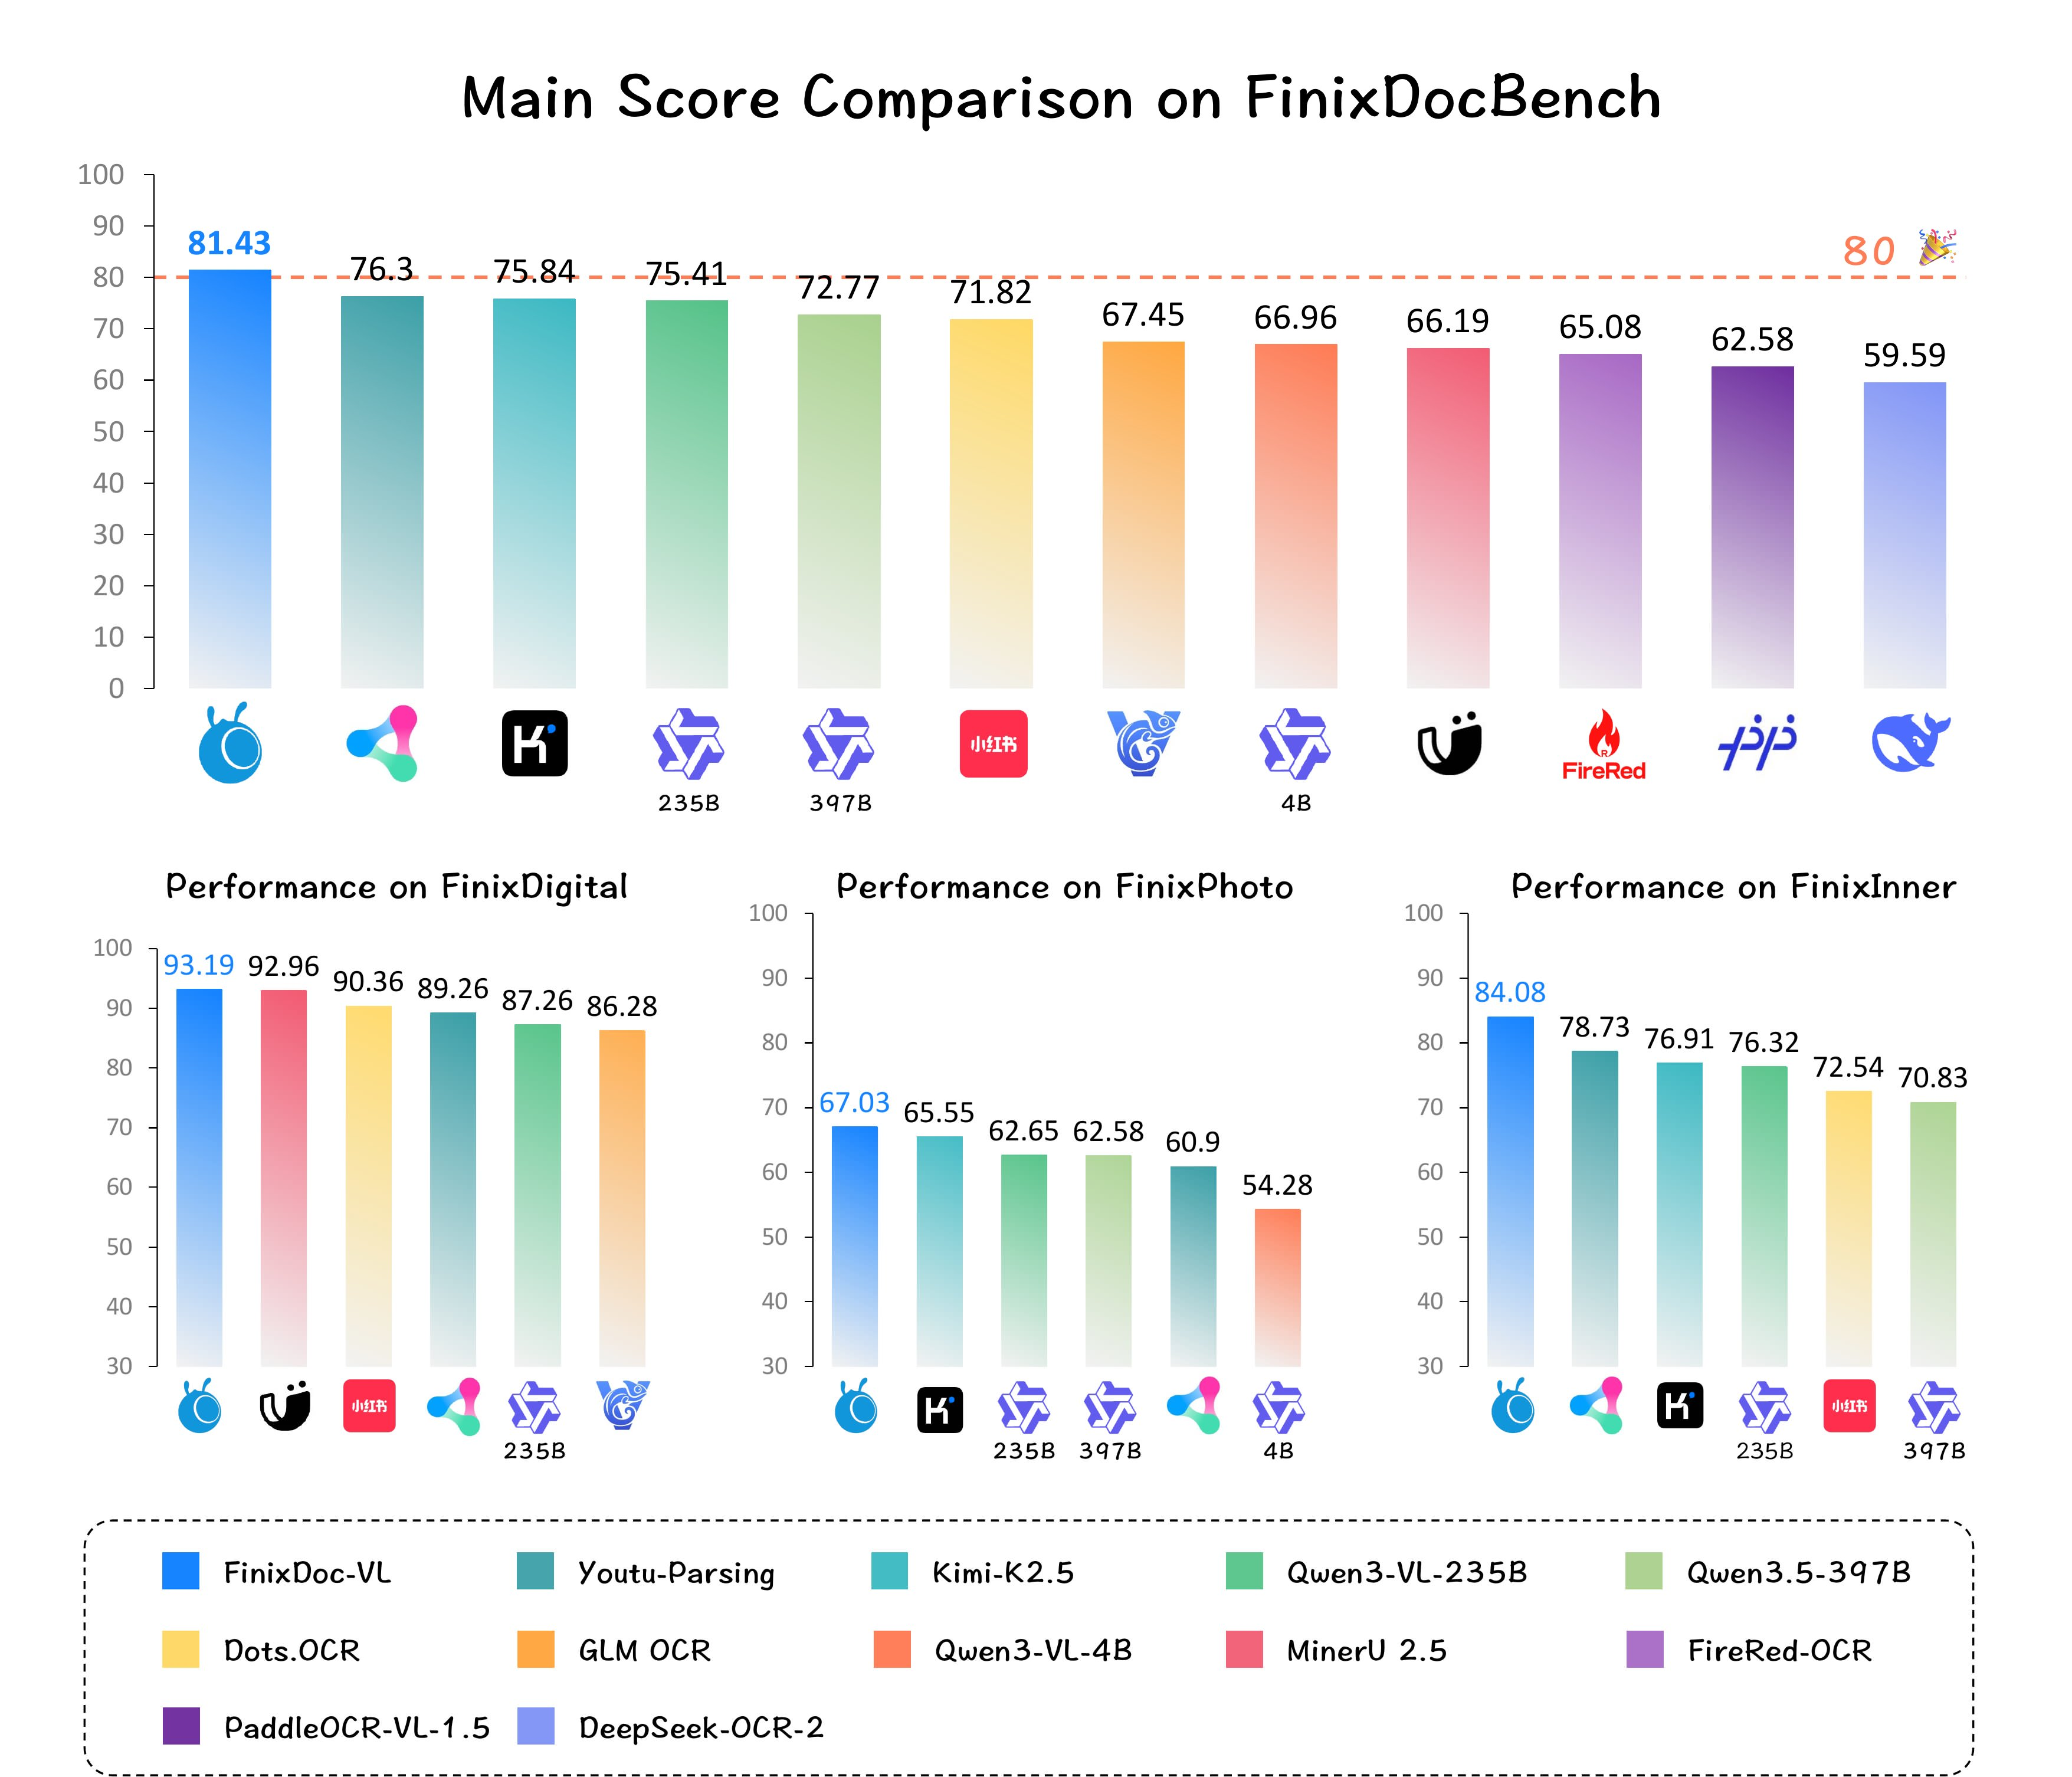
6月30日消息,蚂蚁集团旗下 InclusionAI 实验室发布 FinixDoc,一套面向真实金融文档场景的端到端解析系统。该系统的核心模型 FinixDoc-VL 仅有 4B 参数,基于 Qwen3-VL 架构微调,在自建基准 FinixDocBench 上取得 81.43 的综合得分,超过 Kimi-K2.5 和多个参数量远大于自身的通用模型。蚂蚁同步开源了 FinixDocBench 的部分子集,供外部团队评估自身文档解析能力。 这项工作值得关注的原因在于,它将金融文档解析的评估标准从"干净扫描件"推向了真实业务条件——手机拍照票据、超长保单条款、跨页密集表格。但需要注意的是,FinixDocBench 由蚂蚁自建,目前仅开源了部分子集,完整基准的难度分布和标注一致性尚未经过第三方审计。
4B 模型为何能打赢大参数选手
FinixDoc-VL 的策略不是堆参数,而是针对金融文档的特有难点做定向优化。蚂蚁此前发布的 Agentar-Fin-OCR 已展示过跨页内容合并算法和文档级标题层次重建(DHR)模块,用于恢复被分页打断的表格和目录结构。FinixDoc-VL 延续了这一思路,在 Qwen3-VL-4B 基础上通过难度自适应课程学习训练表格解析能力,并使用结构锚点标记实现无需外部检测器的单元格定位。
在 FinixDocBench 的 FinixDigital 子集(数字原生保险条款)上,FinixDoc-VL 综合得分 93.19,Kimi-K2.5 为 85.05,Qwen3-VL-235B-A22B 为 87.26。换句话说,一个 4B 模型在垂直场景的结构化解析上领先参数量是自身近 60 倍的通用模型。在更具挑战性的 FinixPhoto 子集(手机拍照医疗票据)上,FinixDoc-VL 得分 67.03,仍小幅领先 Kimi-K2.5 的 65.55。
在大幅面和密集表格页面上,FinixDoc-VL 的有效输出成功率达到 92%。这一指标衡量的是模型能否对超长页面和复杂表格返回语法合法的结构化 Markdown,而非传统 OCR 的逐字符准确率。
金融文档解析为何需要专用基准
蚂蚁推出 FinixDocBench 的背景是:现有公开基准(如 OmniDocBench)主要覆盖清晰扫描件和标准版式,多数模型在这些基准上已接近饱和。但金融业务中的真实文档远比基准条件复杂——保险合同动辄数十页、医疗费用单据由手机翻拍、年报表格跨越多页且单元格合并关系嵌套。
FinixDocBench 设立了四个评测维度:FinixDigital(数字原生条款)、FinixPhoto(拍照票据)、FinixHuge-Long(超长页面)和 FinixHuge-Table(超大密集表格)。前两者评估完整的 Markdown 重建和结构化标注,后两者仅评估"能否成功返回有效结果"的通过率,筛掉在超长输入面前直接崩溃的模型。
蚂蚁目前仅开源了经过合规审查的部分子集,包含保险条款和医疗票据样本,完整数据集未公开。
垂直模型的效率优势与可复用性边界
FinixDoc 对金融行业的直接意义在成本端。4B 参数模型的推理成本约为 235B MoE 模型的数十分之一,在文档密集型业务(如保单录入、票据核验、年报数据提取)中,这一差距会被业务量进一步放大。如果 FinixDoc-VL 的精度确实能在生产环境中维持基准测试的水平,那么金融机构可以用远低于调用通用大模型的成本完成文档结构化。
但垂直模型的代价是通用性。FinixDoc-VL 的训练数据和优化目标高度对齐金融文档,它在非金融场景(如法律合同、学术论文、工程图纸)上的表现未经测试。对于多文档类型混合的业务流,可能仍需搭配通用模型使用。
需要等完整基准公开后再下结论
FinixDocBench 的设计思路是合理的——把评测锚定在真实业务条件上,而不是继续在已饱和的干净扫描件基准上刷分。但当前存在一个判断约束:基准由模型开发方自建,完整数据集未公开,外部团队只能在开源子集上验证。在完整基准的标注方法、样本分布和难度梯度经过独立审计之前,榜单排名的绝对意义有限。
接下来需要关注的节点包括:蚂蚁是否会开源 FinixDoc-VL 的模型权重或仅以 API 形式提供,完整 FinixDocBench 是否会在学术社区推动下全量公开,以及其他文档解析团队(MinerU、Dots.OCR、腾讯 Youtu-Parsing)在该基准上的独立复现结果。
 AI 速览