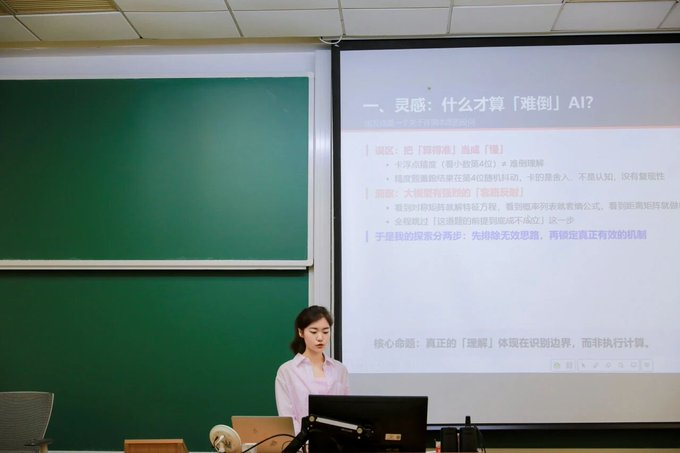
7月1日消息,复旦大学计算与智能创新学院教授肖仰华在其"数据挖掘技术"课程中采用了一种特殊的期末考核方式:学生不再答题,而是每人出 10 道题去"考"AI。三个不同能力等级的大模型作为"考生"作答,AI 答错越多、被难倒的模型越强,学生得分越高。51 名学生参与考核后,全班平均分 85.7 分,50 人至少让某个 AI 答错过一题,但没有任何学生能让最强模型 Claude Sonnet 4.6 在整张卷子上得零分。这一结果指向一个清晰的结论:让 AI 偶尔出错不难,让前沿模型系统性失败非常难。 考核规则:出 10 道题,难倒 AI 才能加分
考核的核心机制是角色反转。学生从答题者变为出题者,每人设计 10 道基于课程知识或教材内容的题目,每道题必须有唯一正确答案并附完整推导或计算过程,出题者自己必须从头到尾算对。题目提交后由三个 AI 模型分别作答,按模型能力等级分配不同的加分权重:DeepSeek V4-Flash 为较易模型,答错一题加 1.5 分;MiniMax M2.7 为中等模型,答错一题加 2 分;Claude Sonnet 4.6 为最强模型,答错一题加 3 分。基底分为 60 分——认真出满 10 道合规题即可获得,加分上限封顶至 100 分。全流程为学生出题、AI 作答、自动判分、助教复核。 这套机制的设计逻辑是:学生要获得高分,必须深入理解课程知识到足以找到 AI 的盲区,而不是简单地记忆或复述。出一道能让 Claude 答错的题目,价值是让 DeepSeek 答错的两倍,这迫使学生去研究不同模型的能力边界差异。
51 名学生的结果:偶发错误容易制造,系统性失败极难达成
51 名学生参与考核后,全班平均分 85.7 分,中位数 88 分。50 人至少成功让某个 AI 答错过一题,仅 1 人完全没有难倒任何模型。但在另一端,仅 4 人能让任一模型在整张卷子上得零分(即 AI 全部答错),且没有任何学生能让最强模型 Claude Sonnet 4.6 得零分。
这组数据的含义比表面更丰富。大多数学生能找到 AI 的局部弱点——某个特定计算步骤、某个边界条件、某个容易混淆的概念。但要设计出一整套 10 道题让前沿模型全部答错,需要对模型的推理模式有系统性的理解,这是绝大多数学生尚未达到的能力层级。
高分学生的出题策略
几位高分学生公开分享了自己的出题思路,这些策略本身展示了不同的"攻击面"。
得分最高的谢锦树(24 级本科,97 分)选择了计算密集型路线,题目涉及 SHAP 值、HITS 算法、HMM、ChiMerge 和 CART 结合贝叶斯网络等方向。他使用多智能体框架配合 GPT 辅助生成初始题目,再通过人工严格审查确保答案正确,防止 AI 在出题阶段就"作弊"。他的核心发现是 AI 在专业知识的精确计算上容易产生幻觉。
巫瀚东(23 级)采用了"规模碾压"策略,将数据量拉至数万条记录,要求精确到小数点后四位,直接超出 AI 的有效记忆和计算极限。温嘉宸(23 级,经济学院跨专业选课)则设计了一种元认知测试:所有正确答案都是"E(以上都不是)",故意省略关键假设,考察 AI 是否会在缺少必要条件时仍然给出看似合理的答案。李雨佳(24 级,新闻学院跨专业)从教材习题出发,先找出 AI 容易混淆的知识点,再利用嵌套推理增加题目难度。
这些策略有一个共同点:它们都不依赖提示词技巧或对抗性注入,而是从学科知识本身出发,利用 AI 在精确计算、长链推理、隐含假设识别和大规模数据处理上的结构性弱点。
AI 时代的考核设计:测试的不是知识记忆,而是对 AI 能力边界的判断
肖仰华设计这套考核的出发点是一个已经无法回避的现实:传统"学生答题"的考核方式在 AI 时代正在失效。当学生可以用大模型直接生成答案时,闭卷考试考察的不再是学生的知识掌握程度,而是学生是否知道如何使用 AI。肖仰华在课程中同步大量使用 AI 工具辅助练习,将作业频次从 1 至 2 次提升至 9 次,目的是让学生把 AI 当工具而不是依赖。期末考核的角色反转则进一步要求学生具备"指挥和评判 AI"的能力——不是会用 AI,而是知道 AI 在哪里会出错、为什么会出错。
肖仰华在朋友圈写道:"人类的智慧终将战胜人工智能。"但他给这句话加了一个前提:"你得比 AI 更了解 AI 的运作方式。"他还指出,AI 正在放大教育中的马太效应——真正理解知识的学生能借助 AI 变得更强,而仅靠记忆和模仿的学生则可能被 AI 替代掉原本的竞争力。
考核方式本身是否可复制,取决于学科特性
这套考核机制能够成立,依赖几个前提条件:课程内容包含大量可精确验证的计算和推导(数据挖掘的算法题天然适合自动判分);AI 模型在该领域存在可被利用的系统性弱点(精确数值计算、长链推理);以及出题-判分-复核的流程可以半自动化运行。对于偏定性分析、开放式论述或创意产出的课程,同样的机制可能需要大幅改造。
这一案例更值得关注的不是具体的评分规则,而是它背后的教育理念转变:在 AI 能力持续提升的环境下,"出好题"比"答对题"更能体现对知识的深度掌握,"判断 AI 在哪里出错"比"自己算出正确答案"更接近未来工作中的真实技能需求。这门 51 人的课程是否能成为更广泛的教育实践参考,取决于其他学科能否找到各自领域中"让学生考 AI"的等价形式。
 AI 速览