- 通义实验室(阿里)发布 LOGOS,一个基于统一科学语法的多领域科学生成基础模型,用单一自回归框架统一蛋白质、分子、材料、化学反应等领域任务
- 核心创新是设计了一套「科学语法」——通过 、、 等特殊 token 序列表示任意科学对象及其空间关系,无需 3D 坐标或图神经网络
- 在分子生成(蛋白口袋结合)、结合口袋识别、MOF 材料生成、逆合成反应等任务上,LOGOS 一致匹配或超越领域专用模型
- 提供 1B、3B、8B 三档模型规模,实验证实模型越大效果越好(scaling law 在科学领域同样成立),且多领域联合训练优于单领域训练
- 以 Qwen 大模型初始化训练的 LOGOS 显著优于随机初始化,表明 LLM 与科学基础模型的深度融合是可行方向
- 模型权重、训练框架和数据处理管线已在 GitHub(Apache-2.0)和 HuggingFace 全量开源
一个问题:科学领域为什么不能有一个通用语言?
做 AI for Science 的人都有一个体感:每个新任务都要建一套新系统。
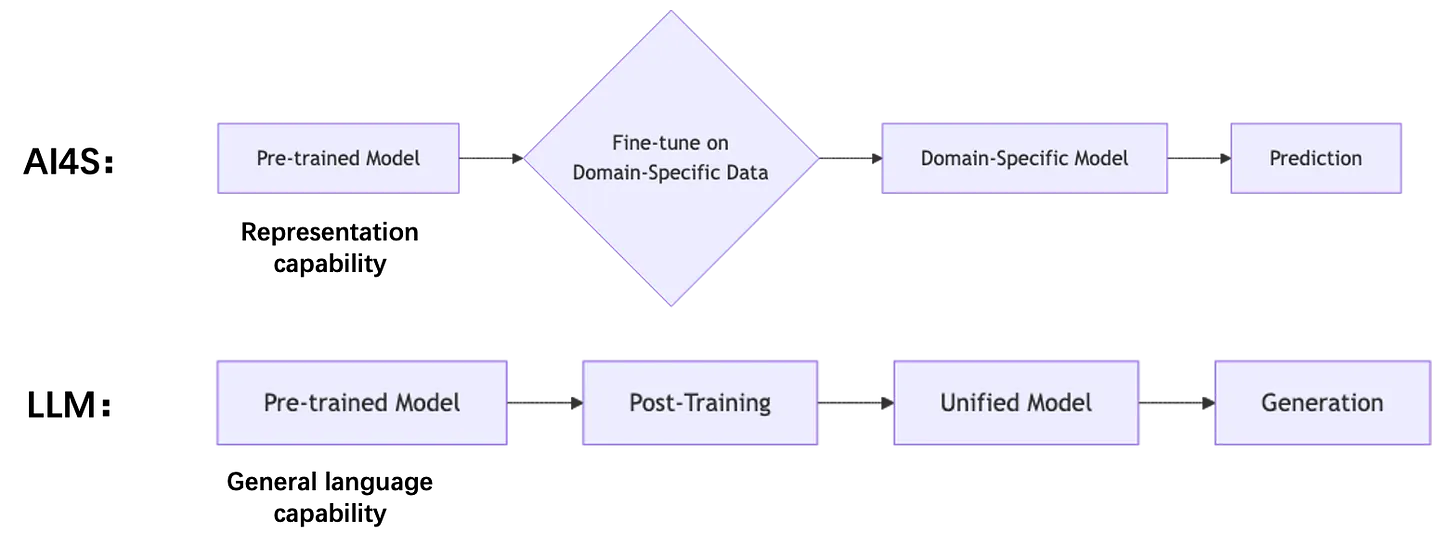
蛋白质折叠有自己的模型,分子生成要另一个架构,材料筛选再来一套管线。数据集、训练目标、推理流程都不同,换一个领域等于从零开始。这种碎片化的现状,和 LLM 的「一个架构通吃所有语言任务」形成鲜明对比。
通义实验室的研究者在播客中坦言,他们最早也试过「简单方案」——直接把科学数据塞进常规 LLM 训练流程,用 next-token prediction 统一训练。结果提升非常有限。
转折点发生在他们换了一个思考方式:不把科学数据当成要被模型「吸收」的信息,而是把它变成一种有自洽语法的语言。
这就是 LOGOS 的起点——能不能给蛋白、分子、材料、化学反应一个共用的语法系统,让 next-token prediction 这个最简单的训练目标自然跨域工作?
核心方法:用 token 序列表达科学对象的「语法」
LOGOS 的答案出奇简洁。
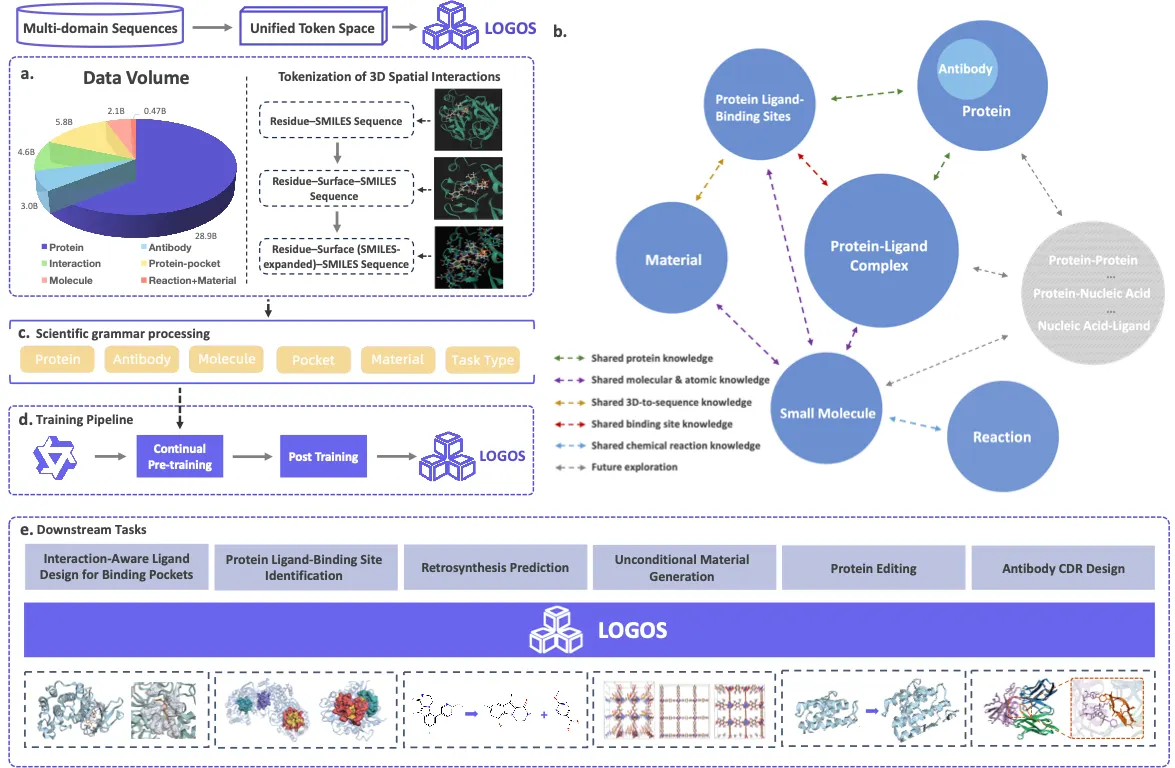
研究者定义了一套专门的 token 体系,用来描述科学对象的三大要素:
- 实体标记:每个科学对象(蛋白质、分子、材料等)用起始标记和结束标记包裹,类似自然语言中的「句子边界」
- 位置标记:用离散 token 表示对象内原子/残基的空间位置,不依赖浮点坐标
- 交互标记:用特定 token 序列描述对象之间的相互作用方式和位点
把这三层 token 组合起来,蛋白质的氨基酸序列、药物小分子的原子连接、MOF 材料的多孔结构、化学反应中的反应物与产物关系——所有这些异构数据——都被表示为同一套 token 空间中的序列。
这意味着一个模型、一个训练目标(next-token prediction)同时覆盖多个科学域。论文中的示意图显示,LOGOS 使用的 pipeline 与传统 LLM 训练流程几乎一致:统一 tokenization → 多领域联合预训练 → 下游任务 fine-tuning。
实验对比还发现一个重要结论:以 Qwen 大模型参数初始化后继续预训练的 LOGOS,效果显著优于从零随机训练。说明 LLM 中已经具备的基础知识(序列建模、结构推理)对科学任务有正向迁移——这是 LOGOS 最关键的突破信号之一。
成绩单:四个任务维度 vs 领域专用模型
正面看,LOGOS 在所有已验证任务上至少持平甚至超出领域专用模型。侧面看,这些任务覆盖了从微观(分子生成)到介观(材料结构)再到过程(化学反应)的跨度——一个模型同时站住这四个赛道的例子在此之前不存在。
一个未经验证的信号
在口袋识别任务中,LOGOS 还指出了若干数据库未标注的候选结合位点。团队已公开寻求湿实验合作验证。这部分结果目前是预测性而非结论性的,但如果验证成立,将证明统一语法对「零样本发现」的价值。
两个关键发现与一个未解问题
发现 1:Scaling law 在科学领域成立。 0.6B → 3B → 8B,参数每增加一档,下游任务效果持续提升。这意味着更大的 LOGOS 模型(16B+)很可能带来可预期的收益,和 LLM 的发展路径一致。
发现 2:多领域联合训练正面互益。 把 6-7 个科学域的数据放进同一个模型训练,效果优于在单一领域上训练同样大小的模型。这为「科学通用模型」的核心假设提供了定量证据——不同科学域之间存在可迁移的底层结构知识。
未解问题:自然语言 vs 科学语言的跷跷板。 团队发现,当在训练中增加自然语言数据比例时,模型在科学任务上的能力会下降。这可能是模型容量和数据规模的限制,也可能是两种「语言」的表达空间确实存在固有冲突。目前机制尚不明确,是 LOGOS 后续研究的核心课题之一。
作者、代码与资源
LOGOS 由阿里通义实验室(Tongyi Lab)团队完成,论文作者包括李明洋、刘雨柔、叶杰平、苏冰、文继荣、汪铮。
- 论文:arXiv:2606.16905(2026-06-15)
对于研究者和开发者:LOGOS 的推理代码已放入 GitHub 仓库,提供了分子生成、口袋识别、材料生成和逆合成反应的独立脚本,可直接在自有数据上运行推理。建议从 3B 模型开始尝试,在效果和算力之间取得平衡。
 AI 速览