腾讯混元(Tencent Hunyuan)与新南威尔士大学(UNSW)发现大语言模型中的不完整学习(Incomplete Learning)现象。即使模型训练损失已完全收敛,Qwen、LLaMA2、OLMo2 平均仍有 15.3% 的训练样本处于未学习状态。 这些样本被模型反复见过,但并未被真正内化——传统收敛指标掩盖了这一系统性盲区。修复框架包含三项技术:CPT(MedQA +12.5%)、数据冲突处理(+2–2.8%)、训练调度(ROUGE-L 最高 +29%)。揭示了「收敛 ≠ 学会」的核心教训,对预训练数据策略和评估体系有重要影响。
一句话说清楚:大模型训练中的「伪收敛」问题是什么
想象一个学生参加考试,卷面总分看着不错——但仔细一看,有大约 15% 的题目他从来没真正理解过,只是碰巧蒙对了或者靠上下文混过去了。这就是不完整学习现象的直观写照。
当前大语言模型的训练流程中,判断「模型学好了没有」最常用的指标是 训练损失(Training Loss)。当损失曲线趋于平稳、不再下降时,工程团队通常会认为模型已经收敛,训练可以结束了。
但腾讯混元和 UNSW 的研究发现,这个判断假设是错误的。
即使在损失完全收敛之后,模型内部仍有相当比例的样本处于「未被学习」的状态。平均而言,这个比例高达 15.3%,而且在 Qwen 系列、LLaMA2、OLMo2 等多个主流开源模型上普遍存在——说明这不是某个特定架构的特例,而是当前预训练范式的一个系统性缺陷。
核心发现:不完整学习究竟是怎么回事
如何检测「未学习」样本
研究团队的核心贡献之一是提出了一套细粒度的样本级学习状态检测方法。传统上,我们通过整体损失来评估训练进度,但这种方法抹平了样本之间的差异——一些样本被过度学习(模型已经滚瓜烂熟),一些样本被勉强学会(刚好能答对),还有一些样本从未被真正内化。
论文中的检测方法从以下几个维度判断一个样本是否「被学会」:
- 稳定性:模型对该样本的预测是否在训练后期保持稳定正确
- 泛化一致性:模型在类似样本上的表现是否一致,而不是靠随机猜测命中
- 梯度信号:该样本在训练后期是否仍能产生有效的梯度信号(如果梯度长时间趋近于零但预测仍不正确,说明模型陷入了对这类样本的「无视」状态)
通过这套方法,团队在多个模型上完成了大规模扫描,得出了一个稳定的结论:无论模型大小,都有约 15% 的训练数据在传统训练流程中被浪费了。
为什么损失收敛了但样本没学会
这不是一个「训练不够久」的问题。研究团队验证了即使延长训练轮次,这些未学习样本的比例也不会显著下降。深层原因来自几个方面:
数据冲突是主要元凶之一。训练集中存在相互矛盾的数据——同一个问题不同的标注答案、相似的上下文不同的输出模式——模型在学习过程中陷入了「不知道该听谁的」状态。在矛盾样本上,模型选择「取平均」或「忽略两者」,最终哪一边都没真正学会。
学习难度的不均匀分布也在起作用。简单样本会早早被学会,然后产生持续的梯度信号掩盖那些困难样本的存在。训练调度(Scheduling)如果对所有样本一视同仁,困难样本就会在训练后期被「熟视无睹」。
修复框架:三项技术如何补齐模型的「知识缺口」
研究团队不仅发现了问题,还提出了一个完整的修复框架,包含三个互补的技术方向。
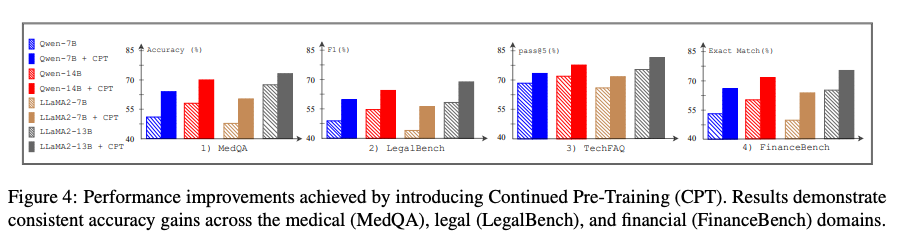
CPT(Continued Pre-Training):定向补课,MedQA +12.5%
CPT 的核心思路不是重新从头训练,而是在训练完成后识别出未学习的样本,对它们进行有针对性的继续预训练。与「再训几轮数据」不同,CPT 只聚焦于那些被确认尚未学会的样本,以及在数据空间中与它们邻近的相关样本。
效果非常直观:在 MedQA(医学问答基准) 上,CPT 带来了 +12.5% 的显著提升。医学问答是一个对知识覆盖完整性要求极高的领域——如果训练数据中恰好有 15% 的医学样本没被学会,模型在诊断或药理问题上的失误率就会不成比例地高。
数据冲突处理:净收益 +2–2.8%
这一步聚焦于消除训练数据中的矛盾信号。研究团队开发了一套自动化的冲突检测与消解管线:
虽然 +2–2.8% 的提升幅度看起来不如其他两项大,但它的价值在于不需要额外的训练步骤——单纯的数据清洗就能带来稳定的性能收益,且对训练资源没有任何额外消耗。
训练调度优化:ROUGE-L 最高 +29%
最引人注目的结果是训练调度优化。研究团队设计了一套基于样本学习状态的动态调度策略:在训练过程中实时追踪每个样本的学习进度,根据「是否已被学会」动态调整样本的呈现顺序和权重。
效果最为显著的任务是文本生成:在 ROUGE-L 指标上实现了最高 +29% 的提升。这并不令人意外,因为生成类任务比判别类任务更依赖模型对训练数据中模式完整性的掌握——如果某些句法模式或表达方式的样本没有被完整学会,模型在生成时的流畅性和准确性就会直接受损。
意义与局限
为什么值得关注
这个发现的意义不在于「又发现了一个 BUG」,而在于它挑战了当前 LLM 训练中的一个基本假设:损失收敛 = 模型学会了。
对整个行业来说,它意味着:
- 评估体系需要升级。单纯看训练损失和验证集准确率已经不够了——需要引入样本级的学习状态检测。如果一个 15.3% 的样本缺口可以隐蔽在传统指标之下,那么我们对许多大模型「真实能力」的理解可能都有偏差。
- 数据质量 > 数据数量又多了一个证据。训练调度优化的 +29% ROUGE-L 提升间接表明,很多模型的生成能力瓶颈可能不是模型容量不足,而是数据在学习管道中的分配效率太低。
- 对垂直领域的影响尤其大。MedQA +12.5% 是一个强烈的信号:在医疗、法律、金融等知识密集型领域,不完整学习的累积效应可能会在核心任务上造成不成比例的性能损失。
当前局限
- 论文(或报道)中未明确披露 CPT 的具体架构——是直接在预训练阶段做增量训练,还是采用类似 LoRA 的参数高效方式?修复所需的额外计算成本尚不清楚。
- 修复框架的通用性还有待验证:15.3% 这个数字来自 Qwen/LLaMA2/OLMo2,在更大规模的模型(如 100B+ 级 MoE 架构)上,这个比例是会下降还是上升?MoE 的专家路由机制是否会加剧或缓解不完整学习?
- 数据冲突处理的 +2–2.8% 提升看似稳定,但冲突检测管线本身的精度如何?误删有效样本带来的负效应是否被充分评估?
- 训练调度优化的 +29% ROUGE-L 提升是否仅在特定评测集上成立?ROUGE-L 本身存在一定的天花板效应和模式化倾向,真实生成质量的提升需要更多评测维度的验证。
作者与资源
该研究由 腾讯混元(Tencent Hunyuan) 团队与 新南威尔士大学(University of New South Wales, UNSW) 的研究者共同完成。研究成果于 2026 年 7 月初首次公开披露。完整论文预计将在 arXiv 上线。
对于从事大模型训练的团队,这篇工作的实践价值很直接:在训练管线中加入样本级学习状态监控,考虑引入 CPT 或动态调度策略来提升数据利用效率,可以从小投入中获得显著回报——尤其是在知识密集型垂直领域。
 AI 速览