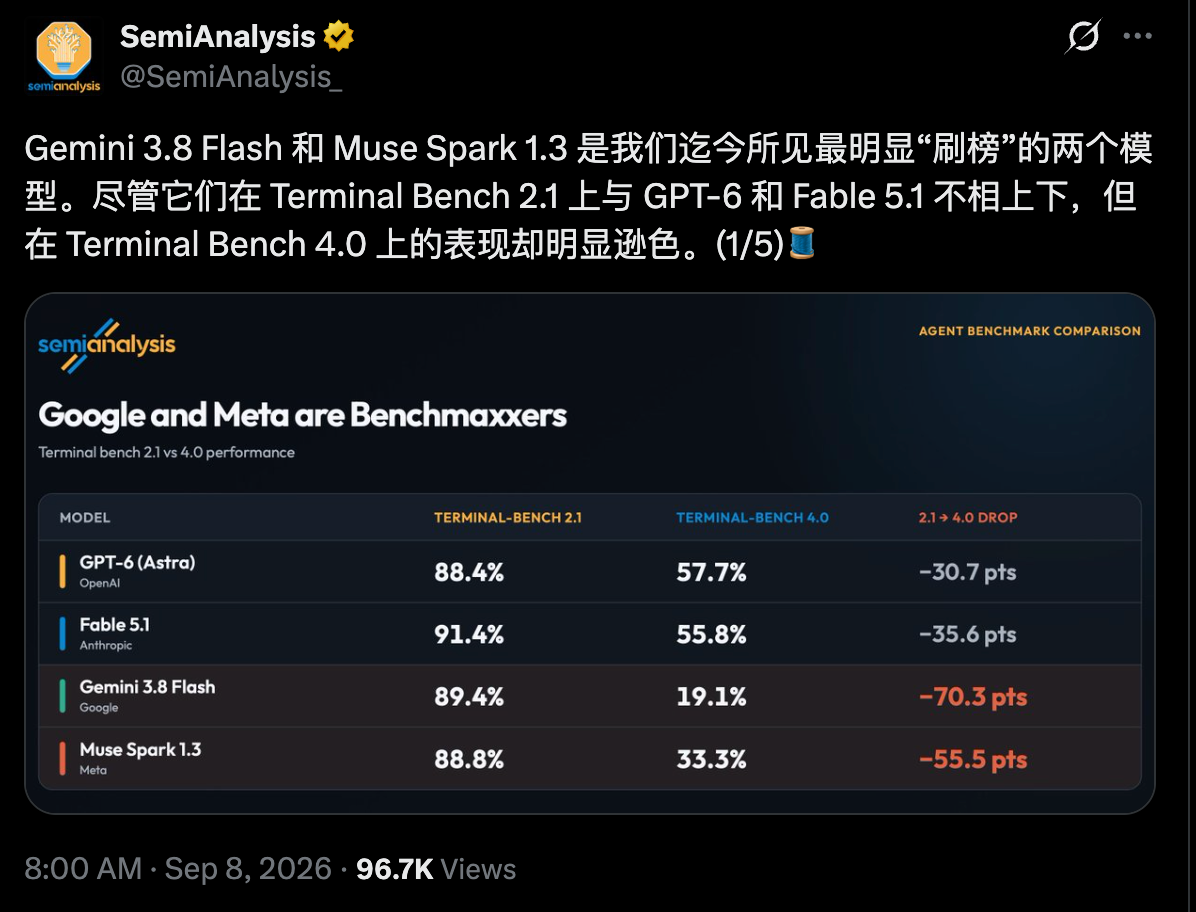
9月8日消息,半导体与 AI 基础设施分析机构 SemiAnalysis 指控 Google 的 Gemini 3.8 Flash 与 Meta 的 Muse Spark 1.3 是迄今所见最明显「刷榜」的两个模型:两者在任务完全公开的 Terminal-Bench 2.1 上接近 GPT-6 与 Claude Fable 5.1,在 8月28日发布的 Terminal-Bench 4.0 上掉队。前一天,评测机构 Artificial Analysis 发布 Intelligence Index v4.3,把指数中的 Terminal-Bench 从 2.1 升级到 4.0,并新增一套私有测试集。两件事指向同一个问题:题目和答案都公开的基准,信号正在被耗尽。刷榜指控目前停留在分数落差与机制推断层面。 同一批模型,两张卷子
分数落差有多方数据支撑。Google 自己发布的评估文件显示,Gemini 3.8 Flash 在 Terminal-Bench 2.1 上得 89.4 分,压过 Claude Opus 5 的 89.1 分,排在榜首;换到 4.0,它是 19.1 分,Opus 5 为 51.8 分。Vellum 等第三方评测给出了相同的 19.1 分。两个版本的榜单形态也不同:2.1 榜头部六款模型挤在 80 到 90 分之间,最高与最低相差约 9 分;4.0 榜的分数从 11.2 跨到 51.8,同一批模型被重新拉开了差距。 Muse Spark 1.3 的曲线相似。这款 9月2日发布的模型在 TB 2.1 上处于高位,在 4.0 上掉到远低于同档旗舰的区间,各家评测的具体数字不一,方向一致。MindStudio 在 9月5日发文,质疑其基准分数与实际使用表现对不上。
4.0 这张卷子本身更难。Terminal-Bench 团队在 8月28日的发布说明中写道,新版本包含 66 个多步骤终端任务,删除了 8 道已饱和或存在公开解法的题目,修复了 19 道题,重新校准了计算与时间配额,测试框架也从 Terminus 2 换成与模型无关的 mini-SWE-agent。题目变难可以解释普遍的分数下降,解释不了相对跌幅:同档旗舰在新卷上保住了五成上下的成绩,这两款模型掉到两成以下。SemiAnalysis 强调的正是这个差值。
指控的机制:不用背题,买仿卷数据
SemiAnalysis 没有指控两家实验室直接在公开任务上训练。它描述的链条是:实验室向专门模仿 TB 2.1 任务的强化学习环境初创公司购买数据,用这些数据训练后,效果接近针对旧卷做过优化。按这个逻辑,模型在旧卷上的提升无法泛化,哪怕泛化目标只是同一基准的新版本。
它还给了一个具体名字。SemiAnalysis 称,Gemini 3.8 Flash 在编程基准 DeepSWE 上的表现是「另一个例子」,并点名数据公司 Datacurve 靠向 Google 出售 DeepSWE 形状的任务赚了一大笔钱。Datacurve 是 YC 2024年冬季批次的创业公司,创始人 Serena Ge 与 Charley Lee,业务是向基础模型实验室出售编码数据与强化学习环境;DeepSWE 正是这家公司在 5月开源的长程编程基准,含 113 个真实开发任务,其公开榜单也是 Google 官方评估文件中 Gemini 系列 DeepSWE 分数的来源。出题方同时是训练数据的卖方,这层关系是 SemiAnalysis 点名的依据。
这条指控的边界同样清楚。没有任何合同或交易记录被公开,「买仿卷数据」是基于分数落差的机制推断。另一个可核验的细节是,Meta 宣称 Muse Spark 1.3 在 DeepSWE 上得 75.4 分,该分数是厂商自测,未出现在 DeepSWE 的公开榜单上;Muse 系列从 4月首次发布起,就伴随「为基准而优化」的质疑。Google 与 Meta 目前未就指控公开回应。
前一天,Artificial Analysis 已经把卷子换了
Artificial Analysis 在 9月7日发布的 Intelligence Index v4.3,可以看作评测方对同一问题的制度化回应。除了把 Terminal-Bench 升级到 4.0,它还引入业务流程自动化基准 AutomationBench-AA,替换了 τ³-Banking。新基准与 Zapier 合作,使用其私有测试集,包含 657 个业务流程,要求智能体在 Gmail、Slack、Salesforce、Jira 等模拟应用中按业务规则完成任务。由于私有题目与答案的占比上升,分配给私有部分的评估权重从 40% 提高到 45%;智能体、编码、通用、科学推理四个类别的权重保持不变。官方称这批改动属于原计划 v5 的内容,提前发布。 v4.3 的首批结果里,Claude Fable 5.1(max,带回退)与 GPT-6 Astra(max)以 53 分并列第一,Claude Opus 5(max)51 分,Muse Spark 1.3(max)48 分,GPT-5.6 Sol(max)47 分;开放权重阵营由 GLM-5.3 与 Kimi K3 以 44 分领先,GLM-5.3-Flash 42 分,DeepSeek V4 Pro 0813(max)36 分。智能与成本的帕累托前沿大部分由 OpenAI 占据,其余位置属于 Claude Fable 5.1、GLM-5.3-Flash 与 MiMo-V2.5-Pro。 这组数字里有一个值得停留的细节:被 SemiAnalysis 点名的 Muse Spark 1.3,在换卷并加权的新指数里有 48 分,排第五。指控针对的是它在公开单卷上的异常落差,不是对其整体能力的否定。
两条路,同一个终点
把两件事放在一起看,先要说清它们不是因果。v4.3 发布于 9月7日,指控帖发布于 9月8日;AA 的改动来自自己的版本计划,SemiAnalysis 的帖子是外部曝光,两者没有谁回应谁的关系。路径也不同:SemiAnalysis 靠研究机构的公开喊话,帖尾公开征集私有基准,让持有者与 @maxkan 联系;Artificial Analysis 靠产品迭代,提高私有题的评估权重。驱动力一个是揭露,一个是维持自家指数的区分度。
终点是同一个:题目和答案都公开的基准,被默认成了一种会耗尽的资源。Terminal-Bench 2.1 从发布到头部饱和,走到了六款模型挤在 9 分之内的状态;4.0 发布不到两周,SemiAnalysis 断言它现在还能提供有效信号只是因为它刚发布,并预测各家实验室很快会把它刷到顶。换卷的速度、私有题的占比,正在成为评测产品的核心竞争力。
榜单公信力的问题,代价落在拿着榜单做决策的人身上。用公开榜选型的团队,往后读榜单要多看两个字段:这张卷发布了多久,答案是否公开。2.1 高位的分数,不再能区分能力。基准维护方面对的局面是公开榜区分度耗尽,有效信号向新卷和私有集集中。模仿热门基准的训练环境,经这一帖成了一门被公开点名的生意,Datacurve 只是浮出水面的那一个。能确认的到此为止:分数落差、换卷动作和数据生意的存在都有据可查;谁向谁买了什么数据,目前没有证据。至于私有集路线能否让榜单信号变得更干净,取决于题目与答案不外泄,这一点现在无从验证。
 AI 速览