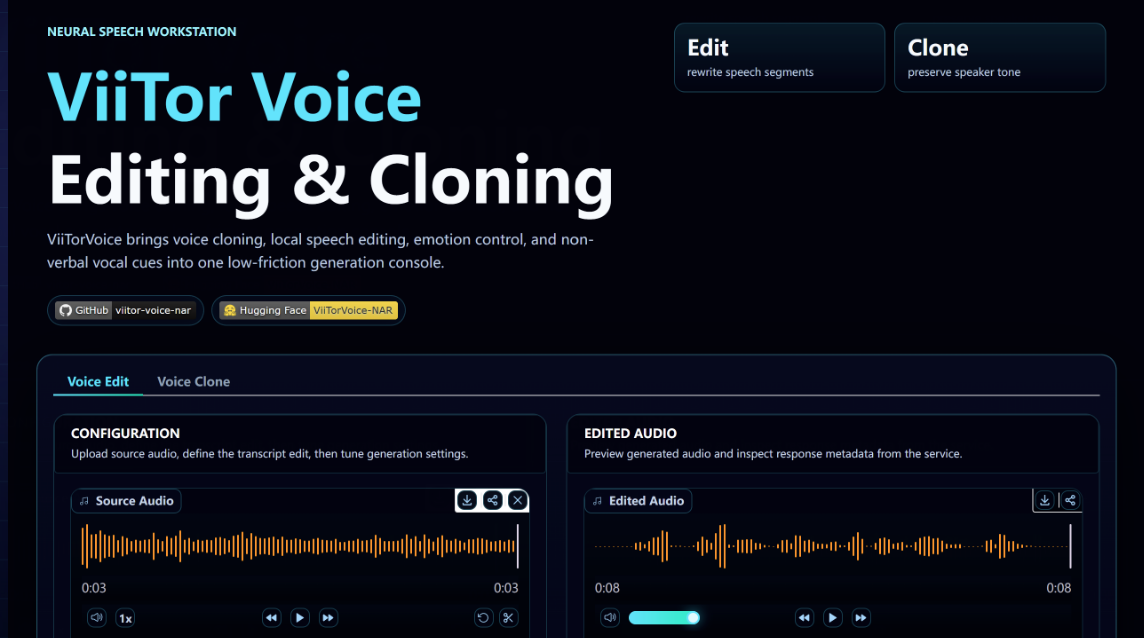
中国语音模型这次是真的杀出重围了。ViiTorVoice在字节跳动Seed-TTS的评测体系里拿到英文词错率1.32、中文词错率0.99的成绩,把Qwen3-TTS、CosyVoice3、Fish Audio这些同行都比了下去,而且它带来了一个行业里少见的能力——语音可以局部编辑,不用整段重录。
一、ViiTorVoice实测的效果
拿最近全网都在传的哈兰德梗试了一把。挪威队带三个主厨去美国、还从本国空运食材,就为了喂饱哈兰德,网友都调侃说他一个人吃掉了全队的伙食预算。
拿哈兰德最近那条广告出来,把台词改成「哈兰德要一头牛,怕饿晕找哈兰德」,生成出来的这几个字音色跟本人几乎一样,那种低沉嗓音的质感也在,呼吸节奏和重音分布对得挺严丝合缝,效果确实出乎意料。
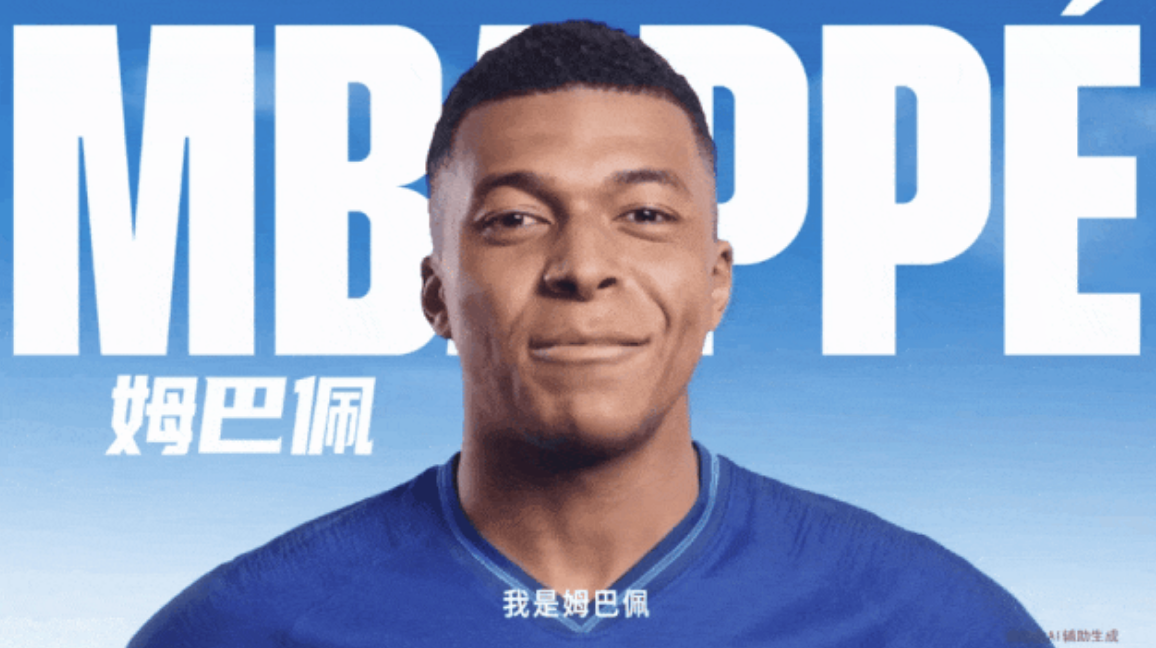
姆巴佩那句魔性的「补水啦~」同样测了一遍,把台词换成「我驾驭未来,补水啦~」,尾音上扬的调调完整保留下来了,还顺利融进了汽车广告那种低沉稳重的旁白节奏里,呼吸气口和背景底噪基本听不出拼接的痕迹。
网站上还有个照片说话的功能,让哈兰德对着镜头讲讲他在场上为什么总一副饿坏了的表情,玩梗效果挺不错。
其实真正耗时间的从来不是第一次生成,而是后期改。短剧配完音了突然要改角色名字,广告文案临时换了产品名,课程里一个专业术语讲错了——这种情况下重新配一整句不难,难的是改完之后音色、情绪、停顿、时间轴要跟原来对得上,这才是让人头疼的地方。ViiTorVoice的片段级编辑,针对的就是这个痛点,可以单独替换某个词、某句话,而不动其他部分。
网站上还挂了几个好玩的功能,比如让鹦鹉给黑道大哥讲冷笑话,效果被玩崩了,笑点很足;还有一对猫狗互相分享对付人类的秘诀,适合拿来做宠物拟人化的搞笑视频素材,这些都能拿来直接替换台词创作。
二、为什么ViiTorVoice会有如此惊艳的效果
需要说清楚一点,Seed-TTS本身是字节跳动自研的语音合成模型,配套的Seed-TTS-eval是业内引用比较广的一套语音评测基准,主要看词错率(WER)这类指标衡量模型的稳定性。ViiTorVoice在这套评测体系里,英文词错率1.32、中文词错率0.99,官方口径是当前公开评测中中文WER首个跌破1.0的模型,超过了Qwen3-TTS、CosyVoice3、Fish Audio等主流选手。词错率降到1以下,意味着模型基本不会出现读错字、跳字这种低级幻觉问题,稳定性确实过硬。
背后这家公司叫云上曲率,做的就是语音合成克隆这类产品,这次靠ViiTorVoice打出了名气。
三、局部编辑到底是怎么实现的
行业里现有的TTS方案,不管开源还是闭源,基本套路都是「整段重新生成」——哪怕只改一个词,也得把整句甚至整段重新跑一遍,音色和节奏很容易跑偏。ViiTorVoice做的是真正意义上的局部替换:指定某个词或短语单独重新生成,音频剩下的部分,包括音色、节奏、背景底噪、前后文的情绪连贯,全都保持不变。
官方Demo里有段英文演讲,你改动其中几个词重新生成,那种特有的拖音、呼吸节奏、情绪起伏完全没变,只有被替换的那个词是新的,听感上几乎无缝。这对影视后期意义不小,把台词调整从「重录、周期长」的补录流程,变成了可以直接在时间轴上做的实时编辑。有声书录制中如果读错专有名词,也不用重录整章,只改那一两秒的音频就行,几十小时的有声书,后期修音时间能从几天压缩到几十分钟,音色和呼吸节奏还能一直保持一致。短剧出海也受益不小——多语言版本不用重新召集配音演员进棚,在原始录音上替换用词就能出多个语言版本,听感还都像原生表演。
这背后靠的是团队在底层架构上做的一个比较反常规的选择,细节没有完全公开,但值得一提的是,ViiTorVoice-NAR已经把大约1B参数量的版本开源了,GitHub和Hugging Face上能拿到包含Qwen3 Forced Aligner、W2V-BERT 2.0在内的完整本地模型组件,愿意折腾的开发者可以自己去试语音克隆、局部编辑和情感控制这些能力。
语音技术这几年走的路子挺清楚,从能说话,到说得像人,再到现在可以像剪文字一样剪声音。ViiTorVoice这次拿下Seed-TTS评测的中文词错率最优成绩,加上首个可局部编辑的能力,算是给内容创作、广告营销、短剧配音、有声书这些行业提供了一个新工具,声音不再是录完就定型的东西了,这条赛道接下来估计会有更多国产团队跟进。
 AI 速览