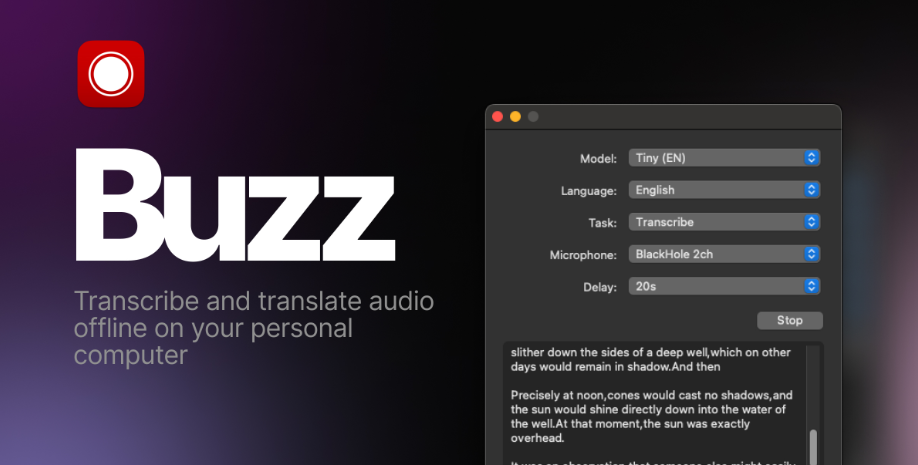
Buzz是一款基于OpenAI Whisper模型构建的免费开源桌面端语音转文字工具,支持Windows、macOS和Linux三大平台,可完全离线运行。它能将音频、视频文件或实时麦克风输入快速转换为文字,支持90多种语言识别,导出TXT、SRT、VTT等格式,是字幕制作、会议记录、采访整理等场景的高效选择。
Buzz是什么
Buzz是一款由独立开发者Chidi Williams主导开发的开源语音转文字工具,核心技术基于OpenAI于2022年开源的Whisper自动语音识别模型。与绝大多数依赖云端服务的转录工具不同,Buzz的所有音频处理都在用户本地电脑上完成,无需联网,也无需上传任何音频数据。
该项目采用MIT开源协议发布,代码完全公开在GitHub上,截至2026年已获得超过18,000个Star,是开源语音转录领域最受欢迎的桌面应用之一。Buzz本质上是为Whisper模型封装了一个跨平台的图形化界面(GUI),让不懂命令行操作的用户也能轻松使用这一强大的AI语音识别能力。
Buzz支持的Whisper引擎包括:
- 原版Whisper:OpenAI官方Python实现,兼容性最好
- Whisper.cpp:C++优化版,运行速度更快,资源占用更低
- Faster Whisper:基于CTranslate2的加速版本,兼顾速度与精度
- HuggingFace兼容模型:支持加载社区微调的Whisper衍生模型
- OpenAI Whisper API:可选调用云端API(需联网和API Key)
简单来说,如果你需要一款免费、离线、跨平台的AI语音转文字工具,Buzz是目前开源生态中最成熟的选择之一。
Buzz的主要功能有哪些
Buzz围绕语音转文字这一核心场景,提供了从实时录制到文件转录、从单语言识别到多语言翻译的完整功能链。以下是其核心功能模块:
1. 实时语音转文字
Buzz支持直接调用电脑麦克风进行实时录音转录,说话的同时文字就会滚动显示。这一功能适用于会议记录、课堂笔记、采访速记等需要即时反馈的场景。需要注意的是,实时转录的性能消耗较大,建议使用Whisper.cpp的Tiny模型以获得接近实时的体验。
2. 音频和视频文件转录
用户可以导入本地音频文件(MP3、WAV、M4A、OGG等)或视频文件(MP4、WebM、OGM等),Buzz会自动提取音轨并进行转录。支持批量导入多个文件,适合一次性处理大量录音素材。
3. 多语言识别与翻译
得益于Whisper模型在多语种数据集上的训练,Buzz支持90多种语言的语音识别,包括中文、英语、日语、韩语、法语、德语等主流语言。同时提供翻译功能,可将任意语言的音频转录并翻译为英文文本。
4. 多种导出格式
Buzz支持三种主流导出格式,满足不同使用场景:
| | |
|---|
| | |
| | 视频字幕制作(YouTube、Premiere、达芬奇) |
| | |
5. 硬件加速支持
Buzz能智能调用不同硬件的算力进行加速处理:
- NVIDIA GPU(CUDA):速度最快,比CPU快5-10倍
- Apple Silicon(M系列芯片):Mac设备的原生加速
- Vulkan:支持AMD显卡和集成显卡的通用加速方案
6. 说话人识别
最新版本的Buzz加入了说话人识别(Speaker Identification)功能,能够自动区分录音中不同人的声音,标注"说话人A""说话人B"等,方便整理多人对话和会议记录。同时支持转录前的音轨分离,在嘈杂环境下也能保持较高准确率。
Buzz怎么安装和使用
系统要求
Buzz对系统要求较为友好,三大主流平台均有支持:
各平台安装方法
macOS安装:
- 方式一(推荐):使用Homebrew安装:brew install --cask buzz
- 方式二:从GitHub Releases页面下载.dmg文件安装
- 方式三:Mac App Store搜索"Buzz",购买原生UI付费版
Windows安装:
- 方式一:从GitHub Releases下载.exe安装包运行
- 方式二:使用winget安装:winget install ChidiWilliams.Buzz
Linux安装:
- 方式一(Flatpak):flatpak install flathub io.github.chidiwilliams.Buzz
- 方式二(Snap):先安装依赖sudo apt-get install libportaudio2,再执行sudo snap install buzz
Python环境安装(适合开发者):
- 安装命令:pip install buzz-captions
Whisper模型选择指南
首次使用Buzz时需要下载Whisper模型,不同模型在速度和精度之间做了权衡:
模型只需下载一次,后续使用均从本地缓存读取。对于中文用户,建议从Small或Medium起步;如果录音环境嘈杂或带有方言口音,可考虑升级到Large模型。
基本使用步骤
- 启动Buzz,点击界面左上角的"+"号或使用快捷键Ctrl+O(Mac为Command+O)
- 选择要转录的音频或视频文件(视频文件需将文件筛选器切换为"All files")
- 设置参数:选择任务(Transcribe转录/Translate翻译)、语言(建议手动指定以提高准确率)、模型质量
Buzz和其他语音转文字工具对比
市面上的语音转文字工具大致分为三类:云端商业服务、系统自带功能、开源本地工具。Buzz属于第三类,与另外两类各有优劣。
Buzz的核心优势在于:免费无限制、隐私绝对安全、与商业服务使用同级别的Whisper模型。对于需要处理大量音频、涉及敏感内容、或希望长期免费使用的用户,Buzz是更优选择。
Buzz的相对劣势在于:处理速度依赖本地硬件配置,低端设备上转录较慢;需要手动选择模型和参数,学习成本略高于"一键转写"的云端服务。
Buzz的使用注意事项
安装与安全
- Windows SmartScreen警告:Buzz的Windows安装包未进行代码签名,安装时系统会弹出SmartScreen警告。点击"更多信息"→"仍要运行"即可,这是开源软件常见情况,源代码可在GitHub公开审计
- macOS安全设置:首次打开若提示"无法验证开发者",前往"系统设置→隐私与安全性"点击"仍要打开"
性能与硬件
- 模型选择量力而行:CPU环境下建议使用Small或Medium模型,Large模型在无GPU时可能非常缓慢(1小时音频可能需要数小时处理)
- GPU加速需额外配置:PyPI安装版本需手动安装CUDA版PyTorch才能启用NVIDIA GPU加速,详见官方文档
- 磁盘空间预留:Medium模型约占1.5GB,Large模型约占3GB,需确保缓存目录有足够空间
- 首次运行较慢:首次使用需下载模型,之后均从本地缓存读取
使用限制
- 翻译功能单向:Buzz的翻译功能仅支持将任意语言翻译为英文,不支持中文翻译为其他语言
- 实时转录有延迟:实时麦克风转录受硬件性能影响,低端设备可能出现明显延迟,建议使用Tiny模型
- 无云端协作:Buzz是纯本地工具,不支持多人协作编辑、云端同步等在线功能
- 模型版本更新:Whisper模型本身持续迭代,Buzz版本更新频率取决于开发者维护节奏
推荐做法
- 处理中文音频时,手动将语言设置为"Chinese"可显著提升识别准确率
- 需要制作视频字幕时,导出SRT格式可直接导入Premiere Pro、达芬奇等剪辑软件
- 处理长音频时,建议先用Small模型快速生成草稿,再用Medium模型精修
- 定期关注GitHub Release更新,新版本可能包含准确率提升和性能优化
 AI 速览