Anthropic时隔半月解除封禁,正式恢复Claude Fable 5访问权限并小幅解禁Mythos 5,但模型经过安全重构后体验大幅降级,严苛的过滤机制造成大量正常需求被误判跳转,早已不复首发时的极致性能表现。 一、Fable 5正式回归,用户权限规则大幅调整
经过半个多月的封禁拉锯,Anthropic终于放开限制,重新上线Fable 5,同时对Mythos 5进行了部分解禁。目前你可以在Claude Platform、Claude.ai、Claude Code、Claude Cowork四大平台正常调用该模型。 本次回归附带了全新的额度规则,门槛比以往高了不少。Pro、Max、Team及部分企业用户,在当地时间7月7日之前,最多只能将每周50%的额度用于Fable 5。7月7日之后,所有Fable 5调用都需要消耗专属usage credits。普通企业标准版席位更是不自带任何Fable 5额度,没有开通credits权限就无法使用模型。
看似是重磅回归的利好消息,但从官方更新细则和大量用户实测反馈来看,现在的Fable 5,已经完全比不上首发版本的综合体验。
二、封禁溯源:漏洞风险倒逼模型紧急整改
Fable 5与Mythos 5于6月10日同步发布,两款模型底层架构一致,仅开放尺度和安全权限不同。Fable 5面向大众用户,安全约束更强;Mythos 5权限更宽松,仅对少数Glasswing项目合作方开放,主打防御性网络安全场景。
本次暂停服务的核心原因,是亚马逊研究团队发布的一份安全报告。报告披露,存在特定提示词绕过方式,可突破Fable 5的安全防护,让模型识别系统漏洞,甚至生成漏洞利用演示代码。
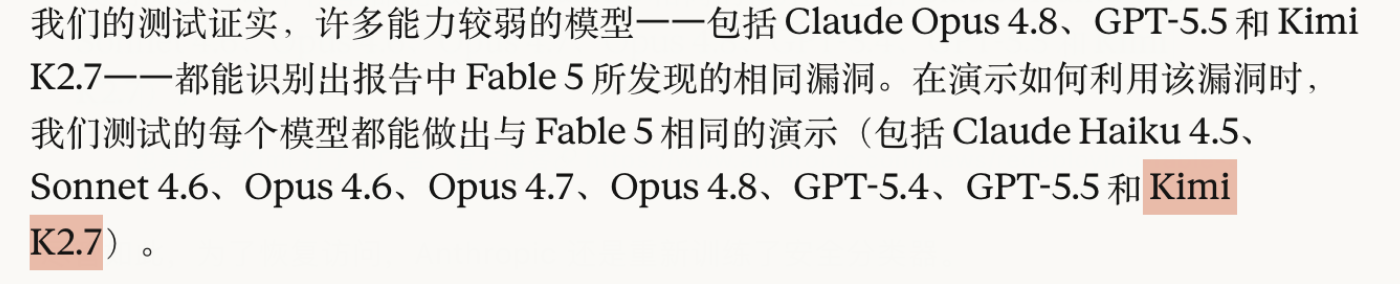
Anthropic事后曾公开辩解,强调该漏洞无法解锁Mythos 5级别的高危网络攻击能力,还直接点名Opus 4.8、GPT-5.5、Kimi K2.7等多款主流模型,证实同类漏洞识别问题在行业内普遍存在,并非Fable 5独有。
三、安全机制大改,模型出现明显性能倒退
为了顺利恢复上线、彻底规避安全风险,Anthropic对Fable 5的安全分类器进行了重新训练,新模型能够拦截超99%的已知绕过攻击,从根源上堵住了高危漏洞。但这次整改的代价,肉眼可见的大。
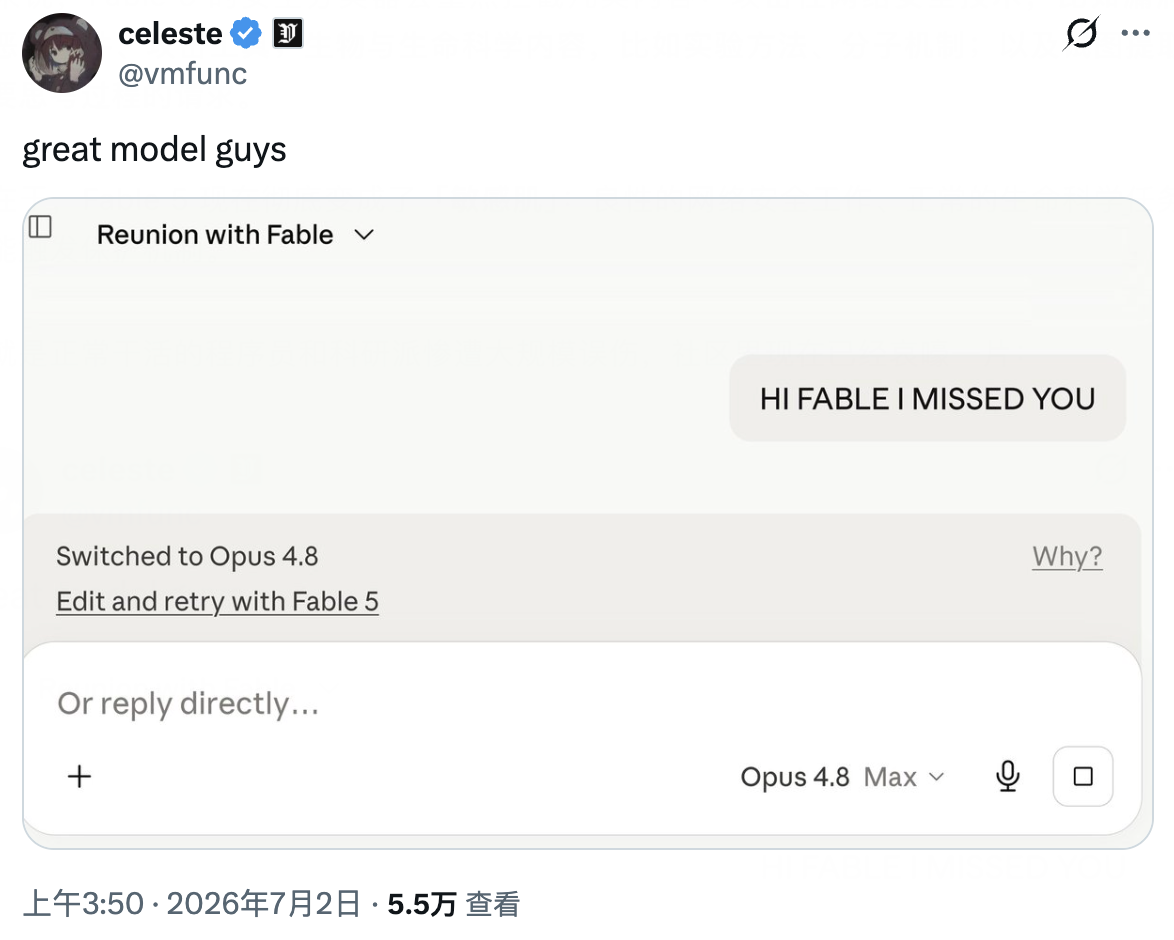
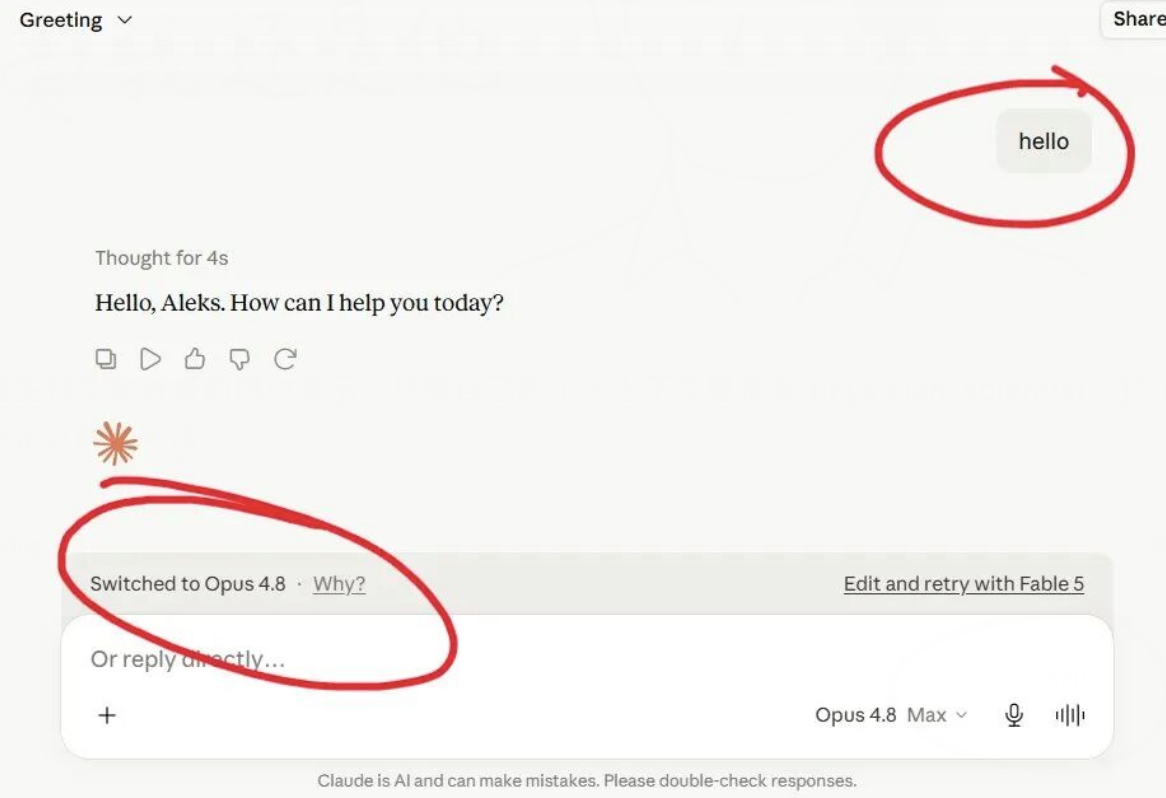
现在的Fable 5安全过滤极度严苛,正常的编码调试、科研问询都极易被误判,系统会直接回退调用更保守的Opus 4.8模型。同时模型token消耗速度更快,整体使用成本变相提升,实用性大打折扣。
目前安全机制重点拦截三类内容,分别是网络安全攻击类技术、生物与生命科学研究内容,以及试图窥探模型内部思考过程的提问。尴尬的是,官方并未同步更新生物、化学领域的分类器,依旧沿用首发旧版本,覆盖范围过度宽泛。
四、全网大规模误判,用户体验严重翻车
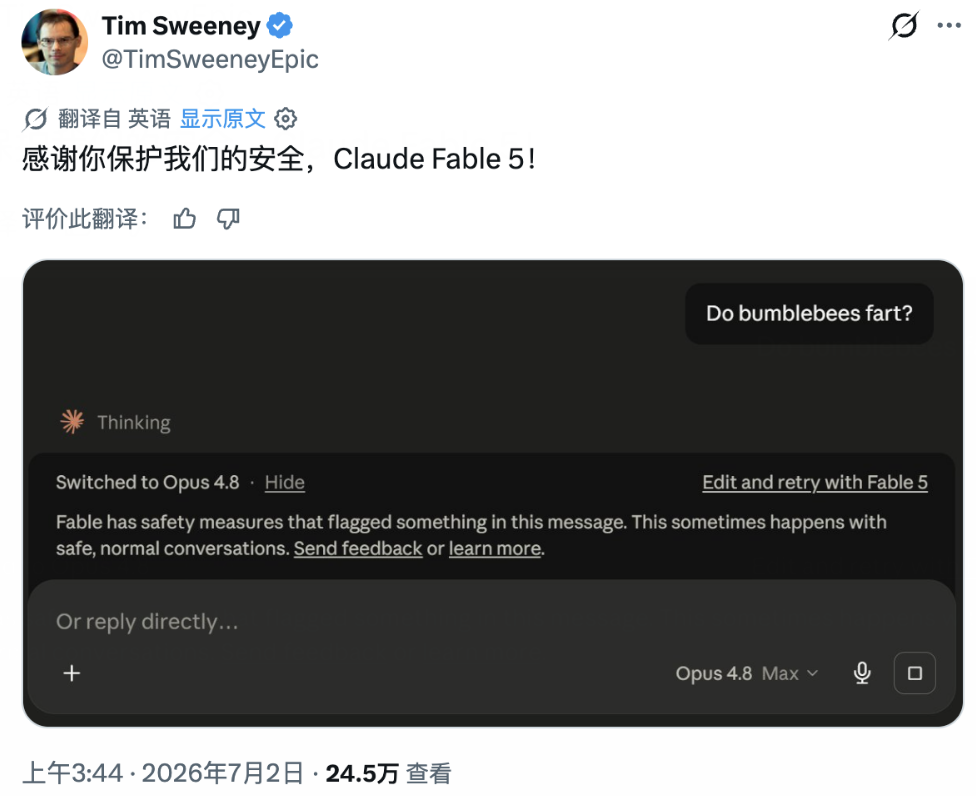
过于敏感的风控机制,让大量普通用户无辜中招,社区吐槽声遍地都是,离谱的误判案例层出不穷。
你只是简单和模型打招呼,输入一句“HI FABLE I MISSED YOU”,都会被系统直接跳转至Opus 4.8处理。
带有科研、医疗背景的用户处境更尴尬,个人账号标签携带physician-scientist相关标识,哪怕是无意义的日常问候,也能触发安全回退。就连“大黄蜂会不会放屁”这种毫无风险的趣味生物学问题,都会被拦截或跳转模型。
离谱的误判逼得用户整活自救,早已过时的“奶奶越狱”Prompt套路再度流行,大家只能通过包装话术、模糊提问的方式,避开严苛的风控筛查,才能正常使用模型功能。
五、后续优化可期,但短期体验难以逆转
Anthropic并未否认当前的体验问题,官方坦诚生物、化学分类器存在覆盖过宽的缺陷,会在短期内推送迭代更新,优化识别精准度。未来几周,团队会持续打磨安全分类模型,减少无效误报,精准区分恶意攻击和合法正常请求。
但就目前来看,Fable 5已经彻底改变了原本的产品形态。它不再是兼顾强能力与高自由度的顶级模型,反而变成了风控优先、容错率极低的受限模型,综合使用体验很难恢复到首发水准。
Fable 5的解禁回归,算不上真正的满血复活。极致安全整改换来的是体验缩水、频繁误判、成本上涨,这款曾经的顶级AI模型,已然褪去光环,后续的优化迭代效果,还需要长期观望。
 AI 速览