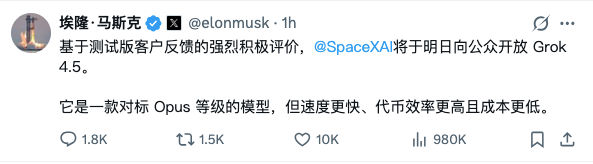
7月8日消息,Elon Musk 在 X 上宣布,SpaceXAI 将于明日(7 月 9 日)向公众开放 Grok 4.5。Musk 称该模型为"Opus 级别",同时表示其速度更快、Token 效率更高、成本更低。Grok 4.5 基于 xAI 的 1.5 万亿参数 V9 基础模型构建,并在补充训练阶段加入了 Cursor 开发者数据。该模型自 6 月 28 日起在 SpaceX 和 Tesla 内部进行私人 Beta 测试,从测试到公开发布历时不到两周。需要明确的是,"接近或超越 Opus"是 Musk 基于内部评估的表述,截至目前没有任何独立第三方基准(LMArena、Artificial Analysis、SWE-bench Verified)对 Grok 4.5 进行过评分。 1.5 万亿参数 V9 基础模型,Cursor 数据参与补充训练
Grok 4.5 的技术底座是 xAI 自研的 V9 基础模型,Musk 公开表述的参数量为 1.5 万亿。该数字为厂商自报,无独立验证。训练过程中,xAI 在补充训练阶段引入了 Cursor 的开发者会话数据。SpaceX 今年早些时候以约 600 亿美元收购了 AI 代码编辑器 Cursor,此次数据整合是收购后首个可见的技术产出——同一实体同时控制了算力集群(Colossus 2)、基础模型(V9)和生成训练数据的编码工具(Cursor),形成了闭环数据飞轮。
Musk 还透露了后续计划:xAI 正在将整个训练和推理栈用 C/C++ 重写,目标是更高效地利用 NVIDIA GB300 硬件;一个更大的 2 万亿参数 V 系列训练运行已在进行中,预计 8 月完成。SpaceX 的计划是 2026 年余下时间内每月从头训练并发布一个全新模型。
从私人 Beta 到公开发布仅 11 天,节奏快于行业惯例
6 月 28 日 Musk 首次公开提及 Grok 4.5 进入 SpaceX 和 Tesla 的内部测试。7 月 6 日 Grok 网页 UI 中出现了"Unlock the full power of Chat with Grok 4.5"的字符串泄露。7 月 8 日 Musk 宣布明日公开。从 Beta 入测到全面发布仅 11 天,远短于 Anthropic 和 OpenAI 近期新模型从预览到全面上线的周期(GPT-5.6 预览到放行约两周但此前有政府限制,Fable 5 的限制解除后客户恢复访问用了一天)。
这个速度有两种解读:一是 Beta 期间收集到的反馈确实强正面,模型已准备就绪;二是 xAI 的发布标准与 Anthropic、OpenAI 不同——后两者近期经历了政府层面的安全审查要求,而 Grok 目前未被纳入任何类似的发布前审查框架。
访问方式:X Premium 用户优先,API 时间表待定
公开后的访问路径为:X Premium 用户可通过 X App 和 x.com 的 Grok 图标直接使用,Premium+ 用户享有更高用量上限,也可通过 grok.com 链接 X 账号获取额外额度。xAI API 何时提供 Grok 4.5 尚未公布具体时间表——目前公共 API 仍运行 Grok 4.3(4 月 30 日发布,定价输入 1.25 美元/百万 Token、输出 2.50 美元/百万 Token,1M 上下文窗口)。
对开发者而言,能否通过 API 调用 Grok 4.5 是真正的可用性分界线。X App 内的消费级聊天界面无法进行系统化评测和生产环境集成。在 API 上线之前,所有性能判断只能基于消费端的主观体验。
"Opus 级别"是一个尚未兑现的承诺
Musk 使用的参照系是 Anthropic 的 Claude Opus 系列——当前行业公认的旗舰推理和 Agent 编码模型层级。但这一对标目前只有厂商自述支撑。作为参考:Claude Code 在 Opus 4.7 上的 SWE-bench Verified 得分为 87.6%,而 xAI 此前唯一公开过 SWE-bench 分数的编码模型 grok-code-fast-1 为 70.8%,差距 17 个百分点。Grok 4.5 本身没有任何公开的 SWE-bench 分数。Artificial Analysis Intelligence Index(独立运营的综合排名)中,Claude 系列模型位居前列,Grok 模型未出现在排名中。 Musk 本人在此前的帖文回复中也有所保留,称 V9 基础模型是"与 Opus 同一梯队的赛马",而非明确宣称超越。这种措辞留出了余地,但也意味着明天上线后社区评测将成为最关键的验证节点。
明天上线后第三方评测是唯一的验证路径
Grok 4.5 公开后,开发者社区和独立评测机构将首次获得直接测试机会。需要回答的核心问题有三个:在编码任务上是否真的缩小了与 Opus 系列 17 个百分点的 SWE-bench 差距;在长周期推理和 Agent 任务上表现如何(这是 Opus 系列的核心优势场景);以及"更快、更便宜"的具体量化——API 定价和推理延迟数据公布后才能与 Anthropic 和 OpenAI 进行有意义的比较。SpaceX-Cursor 数据飞轮的理论逻辑清晰,但模型能力的最终验证不在飞轮的结构优雅程度,而在输出质量的可量化表现。明天是交卷日。
 AI 速览