Anthropic全新推出Claude Sonnet 5,主打更强Agent综合能力,支持自主规划、浏览器与终端工具调用,定价下调后,多数Agent场景的表现能够贴近Opus系列高端模型。官方确认这款模型在推理、工具调用、代码生成、知识处理四大维度,对比Sonnet 4.6有全方位提升。本次测评对象为claude-sonnet-5-thinking高思考档位,整套测试覆盖八大中文场景,官方主推的长程智能体、计算机操作、安全能力可结合官方基准数据对照参考。 模型基础测评数据
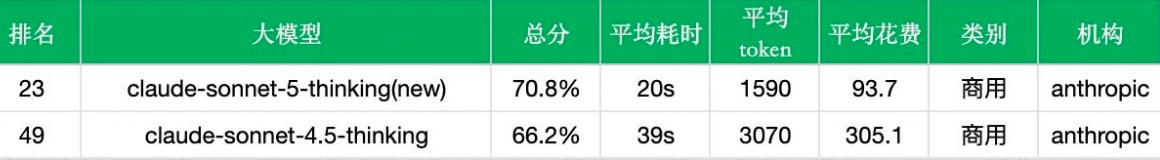
整套测试累计约1.5万道中文题目,综合准确率70.8%,单次调用平均耗时20秒,单次消耗token均值1590,每千次调用综合花费93.7元人民币。
和上一代Sonnet 4.5 Thinking横向对比
换新版本后各项指标变化一目了然,综合得分上涨、响应速度变快、调用成本大幅缩减,能力倾斜特征十分突出,中文垂直细分领域还出现小幅得分回落。
1、综合正确率从66.2%涨到70.8%,榜单排名从49位上升至23位。
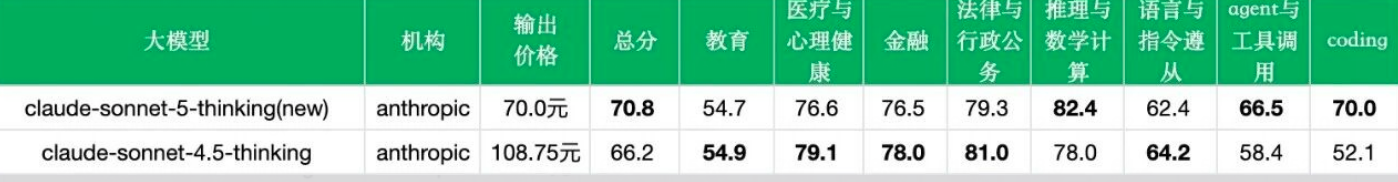
2、编码能力是提升幅度最大的板块,得分从52.1%跃升至70.0%,涨幅17.9个百分点,和官方定位的代码、智能体工作流方向完全契合。
3、Agent工具调用能力同步明显改善,得分58.4%提升至66.5%,任务拆解、工具选择、多步骤执行链路更适配自动化智能体系统。
4、推理数学小幅上涨,78.0%提升至82.4%,多步骤复杂推演有所优化,但提升幅度不及代码与工具模块。
5、中文垂直赛道做出能力取舍,多个行业场景得分小幅下滑。医疗心理健康79.1%降至76.6%,指令遵从64.2%跌至62.4%,法律公务81.0%下滑至79.3%,金融78.0%降到76.5%,教育板块仅微降0.2个百分点。能看出模型研发资源更多向代码、工具、逻辑推理倾斜,行业专项能力没有同步迭代增强。
6、运行与成本优化幅度很可观,单次耗时从39秒压缩到20秒,token消耗减半,输出单价下调,每千次调用成本从305.1元降到93.7元,仅为前代三成左右。
同价位主流模型横向对照
同价格区间对比
1、claude-sonnet-5-thinking单千次调用成本落在90至110元区间,同档位还有通义千问3.7 Max、Kimi K2.6、Claude Opus 4.8、GPT5.2 High、文心一言5.0。单看中文综合准确率,它不占优势,低于通义3.7 Max、Kimi K2.6、Opus4.8普通版本。 2、速度层面存在优势,20秒的平均耗时远快于通义3.7 Max、Kimi K2.6、GPT5.2 High,只是比不上Opus4.8标准版和GPT5.5。
3、对标更高阶旗舰模型,Opus4.8思考档综合得分高出3.9个百分点,二者响应速度接近,但调用开销高出六成以上。GPT5.5、Gemini3.5 Flash综合得分更高,使用成本同样远超Sonnet5 Thinking。
4、低价梯队里有不少更具性价比的选择,通义3.5 Plus、通义3.7 Plus、Kimi K2.7 Code、DeepSeek V4 Pro花费更低,综合中文得分反而更高。 自家产品线定位变化
1、Sonnet5 Thinking对比上代思考档,分数提升同时成本砍到三成,是Anthropic中端思考模型性价比提升的关键一代。
2、品牌内部榜单分层清晰,Opus4.8思考档综合实力断层领先,Opus4.8标准版小幅高于Sonnet5 Thinking,后者又超过老款Opus4.6。对比Sonnet4.5、Opus4.5,新版榜单位次大幅前移,定位是中高端智能体专用补充模型,不会替代Opus旗舰序列。
3、放在近期上新模型里看,它不敌通义3.7 Max、豆包Seed2.1 Pro、GPT5.5、Opus4.8思考版等一众产品,和Kimi K2.5思考档得分持平,轻微领先通义3.6 Plus、GLM5.1、通义3.5 122B大参数量开源版本。
开源与闭源阵营差异
1、闭源产品赛道里,Sonnet5 Thinking工程交互属性突出,分数超过豆包Seed2.0轻量版、Opus4.6、GLM5 Turbo,距离头部闭源旗舰还有明显差距。
2、开源赛道竞争更拥挤,70至73分区间扎堆多款高性价比模型。通义3.5 Plus、DeepSeek V4 Pro、通义3.5 122B凭借极低成本实现更高得分,给闭源中端机型带来不小压力,GLM5.2、Kimi K2.6则证明同分数段开源可选范围已经足够丰富。
官方基准测试数据
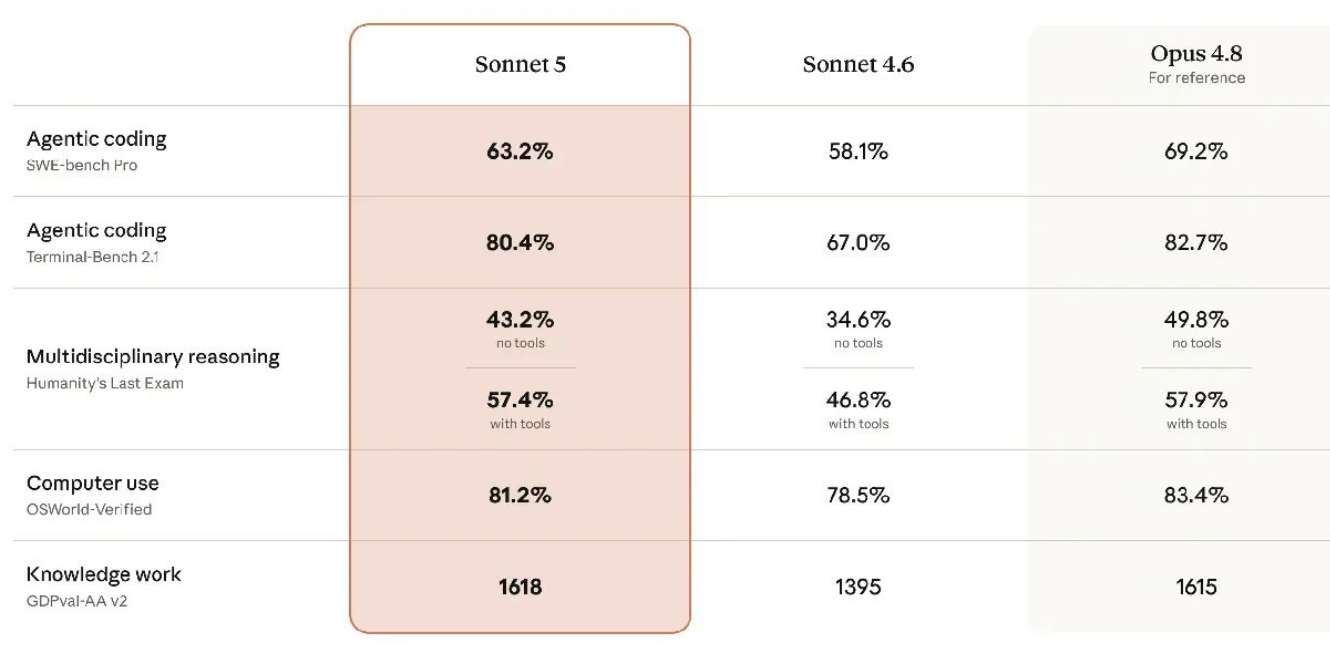
Anthropic官网放出多组标准化基准,佐证Sonnet5面向Agent场景的优化方向,整体实力靠近Opus4.8,远优于Sonnet4.6。
代码基准SWE-bench Pro得分63.2%,优于前代58.1%,不及Opus4.8的69.2%;
终端操作基准Terminal-Bench2.1达到80.4%,大幅超越老款67.0%,和Opus4.8差距极小;
综合知识考试Humanity's Last Exam,无工具43.2%、带工具57.4%,带工具状态下和Opus4.8几乎持平;
电脑操作OSWorld-Verified得分81.2%,小幅追赶Opus4.8;
长文本综合GDPval-AA v2拿到1618分,小幅超过Opus4.8的1615分。
不同effort档位与成本曲线
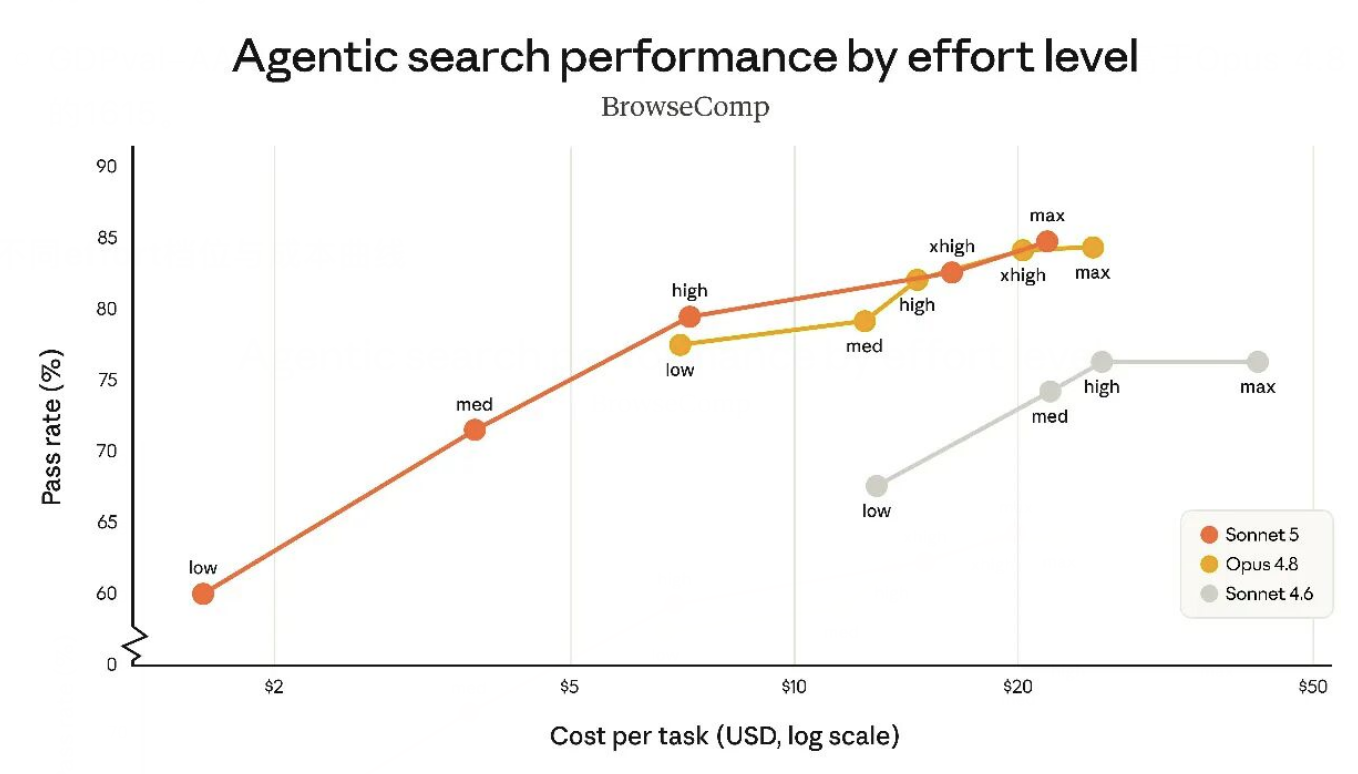
官方公开不同运算强度档位的成本性能曲线,Sonnet5覆盖的性能区间比Sonnet4.6更广,中等运算强度下成本效率提升最明显,高运算档位部分任务能够追平Opus4.8。
安全与网络能力边界
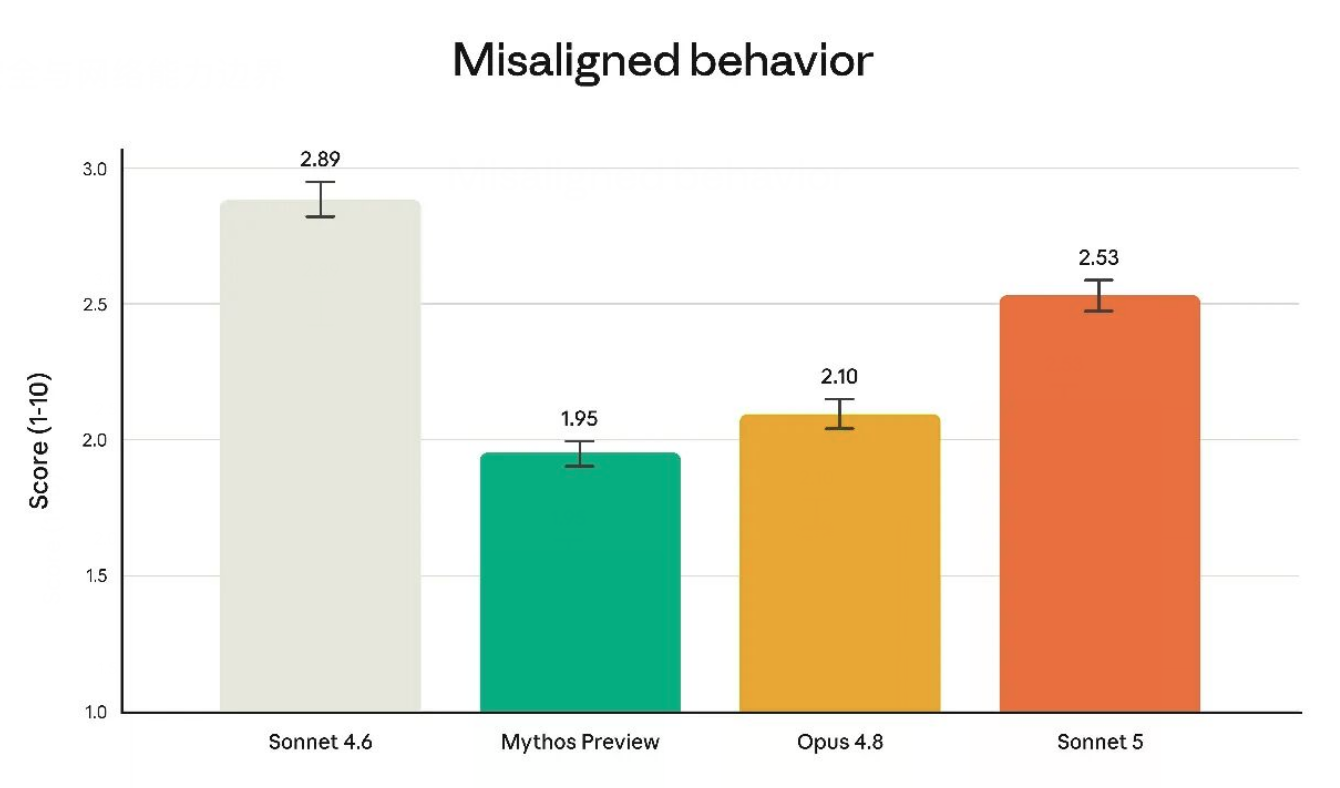
安全层面完成迭代优化,Agent场景下拦截恶意请求、抵御提示注入的能力更强,生成幻觉、刻意迎合用户的倾向有所减少,自动化审计里不良输出比例低于Sonnet4.6。短板同样客观存在,安全表现依旧比不上Opus4.8与Mythos预览版。
模型没有针对网络安全专项训练,常规无害网络操作可正常完成,高危漏洞利用能力远弱于两款高端旗舰。漏洞测试中完整利用成功率归零,仅部分步骤完成度略高于Sonnet4.6,官方为该模型默认开启网络安全防护机制。
以上就是本文的全部内容分享,仅供参考~
 AI 速览