前者补齐 “人话能力” 与长上下文,后者以低价高配正面赶超主流,一场旗舰级 AI 大战正式打响。
一、DeepSeek V4:低价高配,正式跻身第一梯队
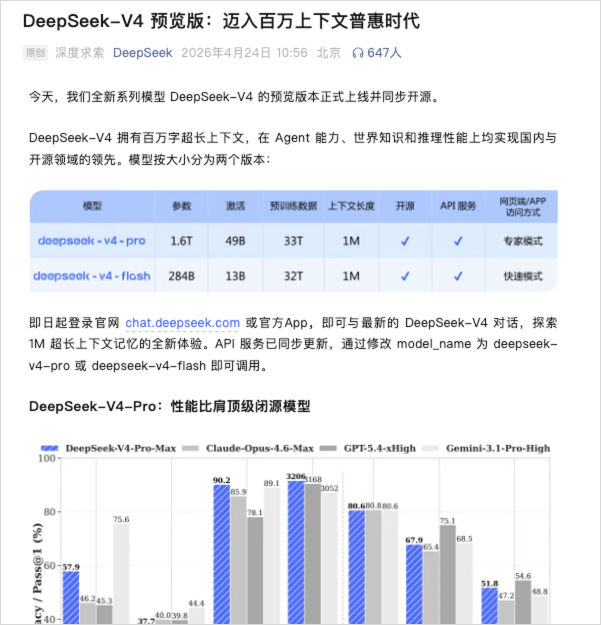
DeepSeek V4 时隔两月更新,推出Flash(轻量)与Pro(284B)双版本,Max 版本达到1.6T,核心亮点十分突出:
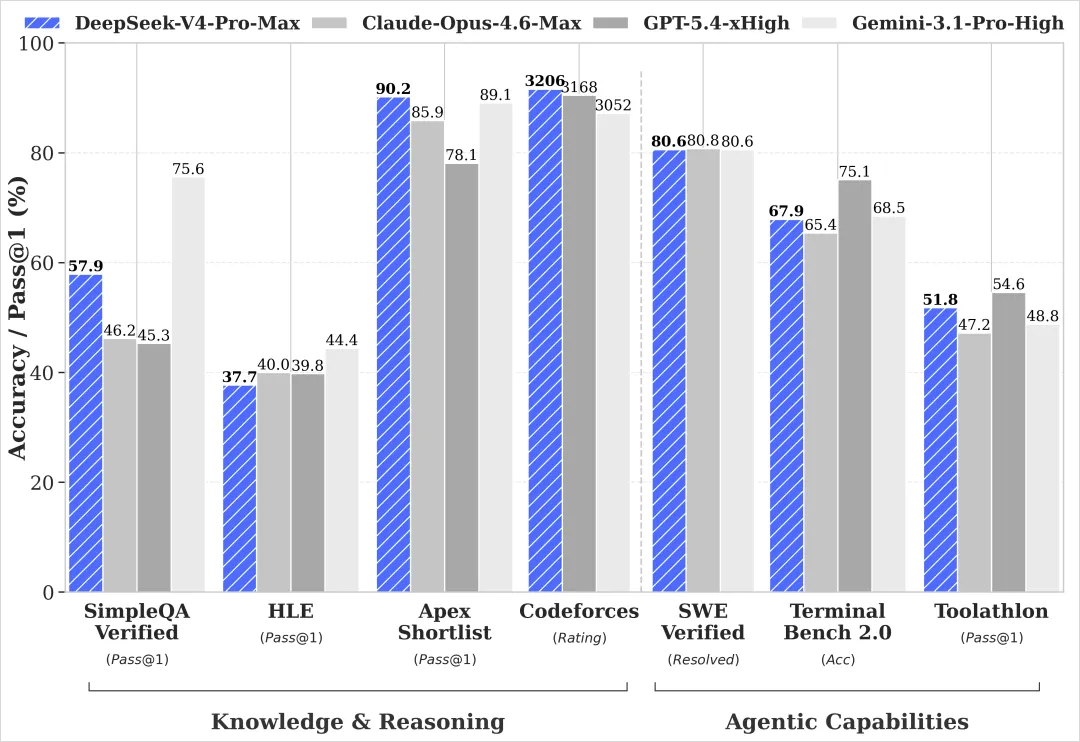
- 能力全面对标:世界知识、数学、代码水平追平 GPT 5.4 与 Opus 4.6
- 体验超 Sonnet 4.5:交付质量接近 Opus 4.6 非思考模式
- 价格极具优势:Flash 输入 ¥0.2 / 百万、输出 ¥1 / 百万;Pro 输入 ¥1 / 百万、输出 ¥12 / 百万
同时支持JSON 输出、工具调用、FIM 代码补全、续写,可直接接入 Agent 体系,性价比拉满。
二、GPT 5.5:长上下文史诗级增强,Agent 能力登顶
GPT 5.5 重点弥补前代短板,成为本次更新最大赢家:
- 长上下文大幅反超:MRCRv2 测试达74.0,远超 GPT 5.4(36.6)与 Opus 4.7(32.2)
- Agent 执行能力第一:Terminal-Bench2.0 得分82.7,领先 Opus 4.7(69.4)
- 桌面操作系统能力持平:OSWorld-Verified 得分78.7,与 Opus 4.7(78.0)打平
- 更懂 “说人话”:UI、网页生成更干净,不再乱塞思考内容,体验大幅提升
最关键的是,GPT 5.5 终于摆脱 “机器感”,在连续协作、长时间任务上表现稳定。
三、对比与槽点:价格翻倍,文字游戏明显
尽管能力大涨,但 GPT 5.5 的定价引发争议:
- API 价格翻倍:输入$5/百万、输出$30 / 百万;Pro 版更高达输入$30、输出$180
- OpenAI 宣传 “省 Token”,却未同步说明涨价事实
与之对比,DeepSeek V4 以不到十分之一的价格,实现接近顶级的性能,性价比优势巨大。
四、与 Opus 4.7 格局改写:各有胜负,用户用脚投票
三者形成明显差异格局:
- GPT 5.5:长上下文、Agent、操作系统能力最强,更流畅自然
- DeepSeek V4:性能接近第一梯队,价格极低,平民首选
- Claude Opus 4.7:在线研究、浏览能力仍最强,但上下文、推理暴跌、口碑崩坏
Claude 甚至连夜以 “奇葩理由” 重置用户额度,试图挽回用户。
伴随 GPT 5.5 更新,Codex迎来全面提速:
- 接入 GPT-Image-2,UI 生成精准度大幅提升
- 正式从 “Claude Code 替代品” 进化为独立强力工具
- 优先上线 Codex,明显争夺 Claude 核心用户
总结
本次双更新直接重塑 AI 格局:
- GPT 5.5重回全能王者,长上下文与 Agent 能力封神
- DeepSeek V4以 “平价款旗舰” 破圈,性价比无敌
- Claude Opus 4.7继续靠搜索优势撑场面,但口碑持续滑坡
对普通用户而言,如今可以按需选择:追求全能选GPT 5.5,预算有限选DeepSeek V4,依赖联网搜索暂留Claude
 AI 速览