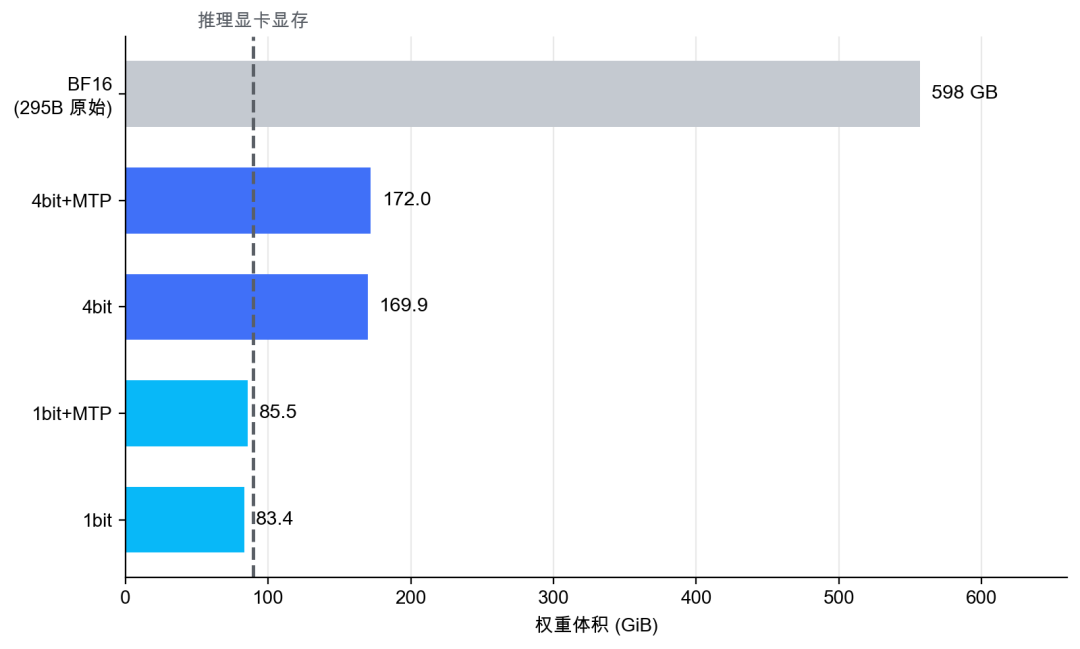
7月14日消息,腾讯混元 AngelSlim 团队发布了旗舰模型 Hy3 的极低比特量化版本,包括 1bit(IQ1_M,85.5GiB)、4bit(Q4_K_M,169.9GiB)和 GPTQ Int4 三种规格,以 GGUF 格式打包并适配 llama.cpp 和 vLLM 生态。原始 BF16 权重约 598GB 的 Hy3 此前需要至少 8 张高显存显卡才能部署,1bit 版本将最低硬件门槛降到了一张 96GB 推理显卡。团队同时发布了 llama.cpp 的 MTP 投机解码补丁,称解码速度提升约 50%-60%。量化效果和加速数据均为团队自测,社区独立验证尚未出现。 三种量化版本覆盖从单卡到服务端
Hy3 是腾讯混元于 7 月 6 日正式发布并开源的旗舰模型,总参数 295B,采用 MoE 架构(192 个专家、每次激活 top-8),激活参数 21B,另有 3.8B 参数的 MTP 预测层,支持 256K 上下文,以 Apache 2.0 协议开源。原始 BF16 权重约 598GB,官方此前推荐至少 8 张 H20-3e(141GB 显存)才能完成部署,对多数开发者和中小团队而言硬件门槛过高。
此次量化提供了三个版本,面向不同部署场景。1bit 版本(IQ1_M)将权重从 598GB 压至 85.5GiB,体积缩小约 6.7 倍,一张 96GB 显存的推理显卡即可承载,面向硬件最受限但仍需本地运行旗舰模型的场景。4bit 版本(Q4_K_M)体积 169.9GiB,两张推理显卡可承载,定位为在有限资源下获取更接近满血效果的选择。GPTQ Int4 版本面向生产服务端,可直接通过 vLLM 部署,适配高并发和低延迟需求。
1bit 没有崩,4bit 接近满血
压缩比只是量化的一半信息,另一半是能力保留。据团队公布的评测数据,4bit 版本在绝大多数任务上与 BF16 原始模型的输出分布保持一致,首选答案和 Top-K 概率分布的偏移幅度很小。在 Agent 能力、多语言代码、工具调用和长文理解等实际任务上,4bit 版本的表现贴近满血模型。GPTQ Int4 在评测集上的掉点幅度同样有限。
团队表示,1bit 版本的表现"有些意外"——长文理解几乎与原始模型持平,Agent 和代码方向仅有小幅回落。团队评估其在编码辅助、工具调用、长文档处理和常规问答等场景下"完全够用"。1bit 量化在稠密模型上通常导致明显能力退化,Hy3 作为 MoE 模型每次推理仅激活 21B 参数,稀疏激活的特性可能对极端量化有一定天然耐受性,但这一推测目前缺少系统性的学术论证。"完全够用"的结论是否成立,取决于社区在实际业务负载中的验证。
MTP 投机解码补齐速度短板
量化解决了显存瓶颈,但低比特模型的解码速度仍是实用性的关键变量。Hy3 架构原生包含一层 MTP(Multi-Token Prediction)预测层,但 llama.cpp 主线此前未支持 Hy3 的 MTP 结构。团队为此开发了专用补丁,补齐了 llama.cpp 对 Hy3 MTP 的支持,并在 HuggingFace 上发布了可用的构建与部署指引。据团队数据,开启 MTP 后投机解码的接受率稳定在约 60%,1bit 版本的解码速度提升约 50%,4bit 版本提升接近 60%。
这些补丁独立于 llama.cpp 主线,未合入上游,使用者需要手动应用补丁重新编译。长期可维护性取决于补丁是否最终被上游接受,或社区是否出现替代方案。
模型厂商端到端覆盖部署链路,比量化本身更值得关注
开源模型的量化版本并不罕见,社区在每个旗舰模型发布后都会快速跟进 GGUF 或 GPTQ 量化。这次不同之处在于量化和部署适配由模型厂商自己完成——AngelSlim 团队不仅做了量化,还开发了 llama.cpp 的 MTP 补丁、提供了构建指引、发布了可直接部署的 GGUF 包和 vLLM 服务端版本。从模型发布到可部署之间的工程链路,由模型厂商端到端覆盖。
对开发者而言,差异在于"开箱即用"的程度。社区量化版本通常需要用户自行处理格式转换、架构适配和推理框架兼容性,厂商直接提供适配好的量化包和推理补丁,将"权重可下载"到"本地可运行"之间的工程门槛显著降低。Hy3 正式版发布仅 8 天即跟进量化版本,响应速度也说明这一环节被纳入了发布流程而非事后补救。
市场容易将这条消息简化为"295B 模型跑在单卡上"。但 1bit 量化下的实际体验与满血模型仍有差距,"单卡可部署"与"单卡可实用"之间的距离需要社区在具体场景中检验。4bit 版本更可能是兼顾质量和成本的实际选择。
社区验证和 llama.cpp 上游合并是关键后续
最直接的验证是开源社区的独立评测。Hy3 正式版发布刚过一周,量化版本刚刚发布,llama.cpp 社区、vLLM 用户和各类 benchmark 复现者的测试结果将决定团队关于 1bit 和 4bit 质量保留的结论能否站住。另一个值得关注的节点是 MTP 补丁的上游归属——如果合入 llama.cpp 主线,Hy3 将成为该生态中首个原生支持 MTP 投机解码的 MoE 旗舰模型,生态位会明确抬升;如果长期停留在独立补丁状态,使用者将面对版本兼容和维护成本的持续负担。
 AI 速览