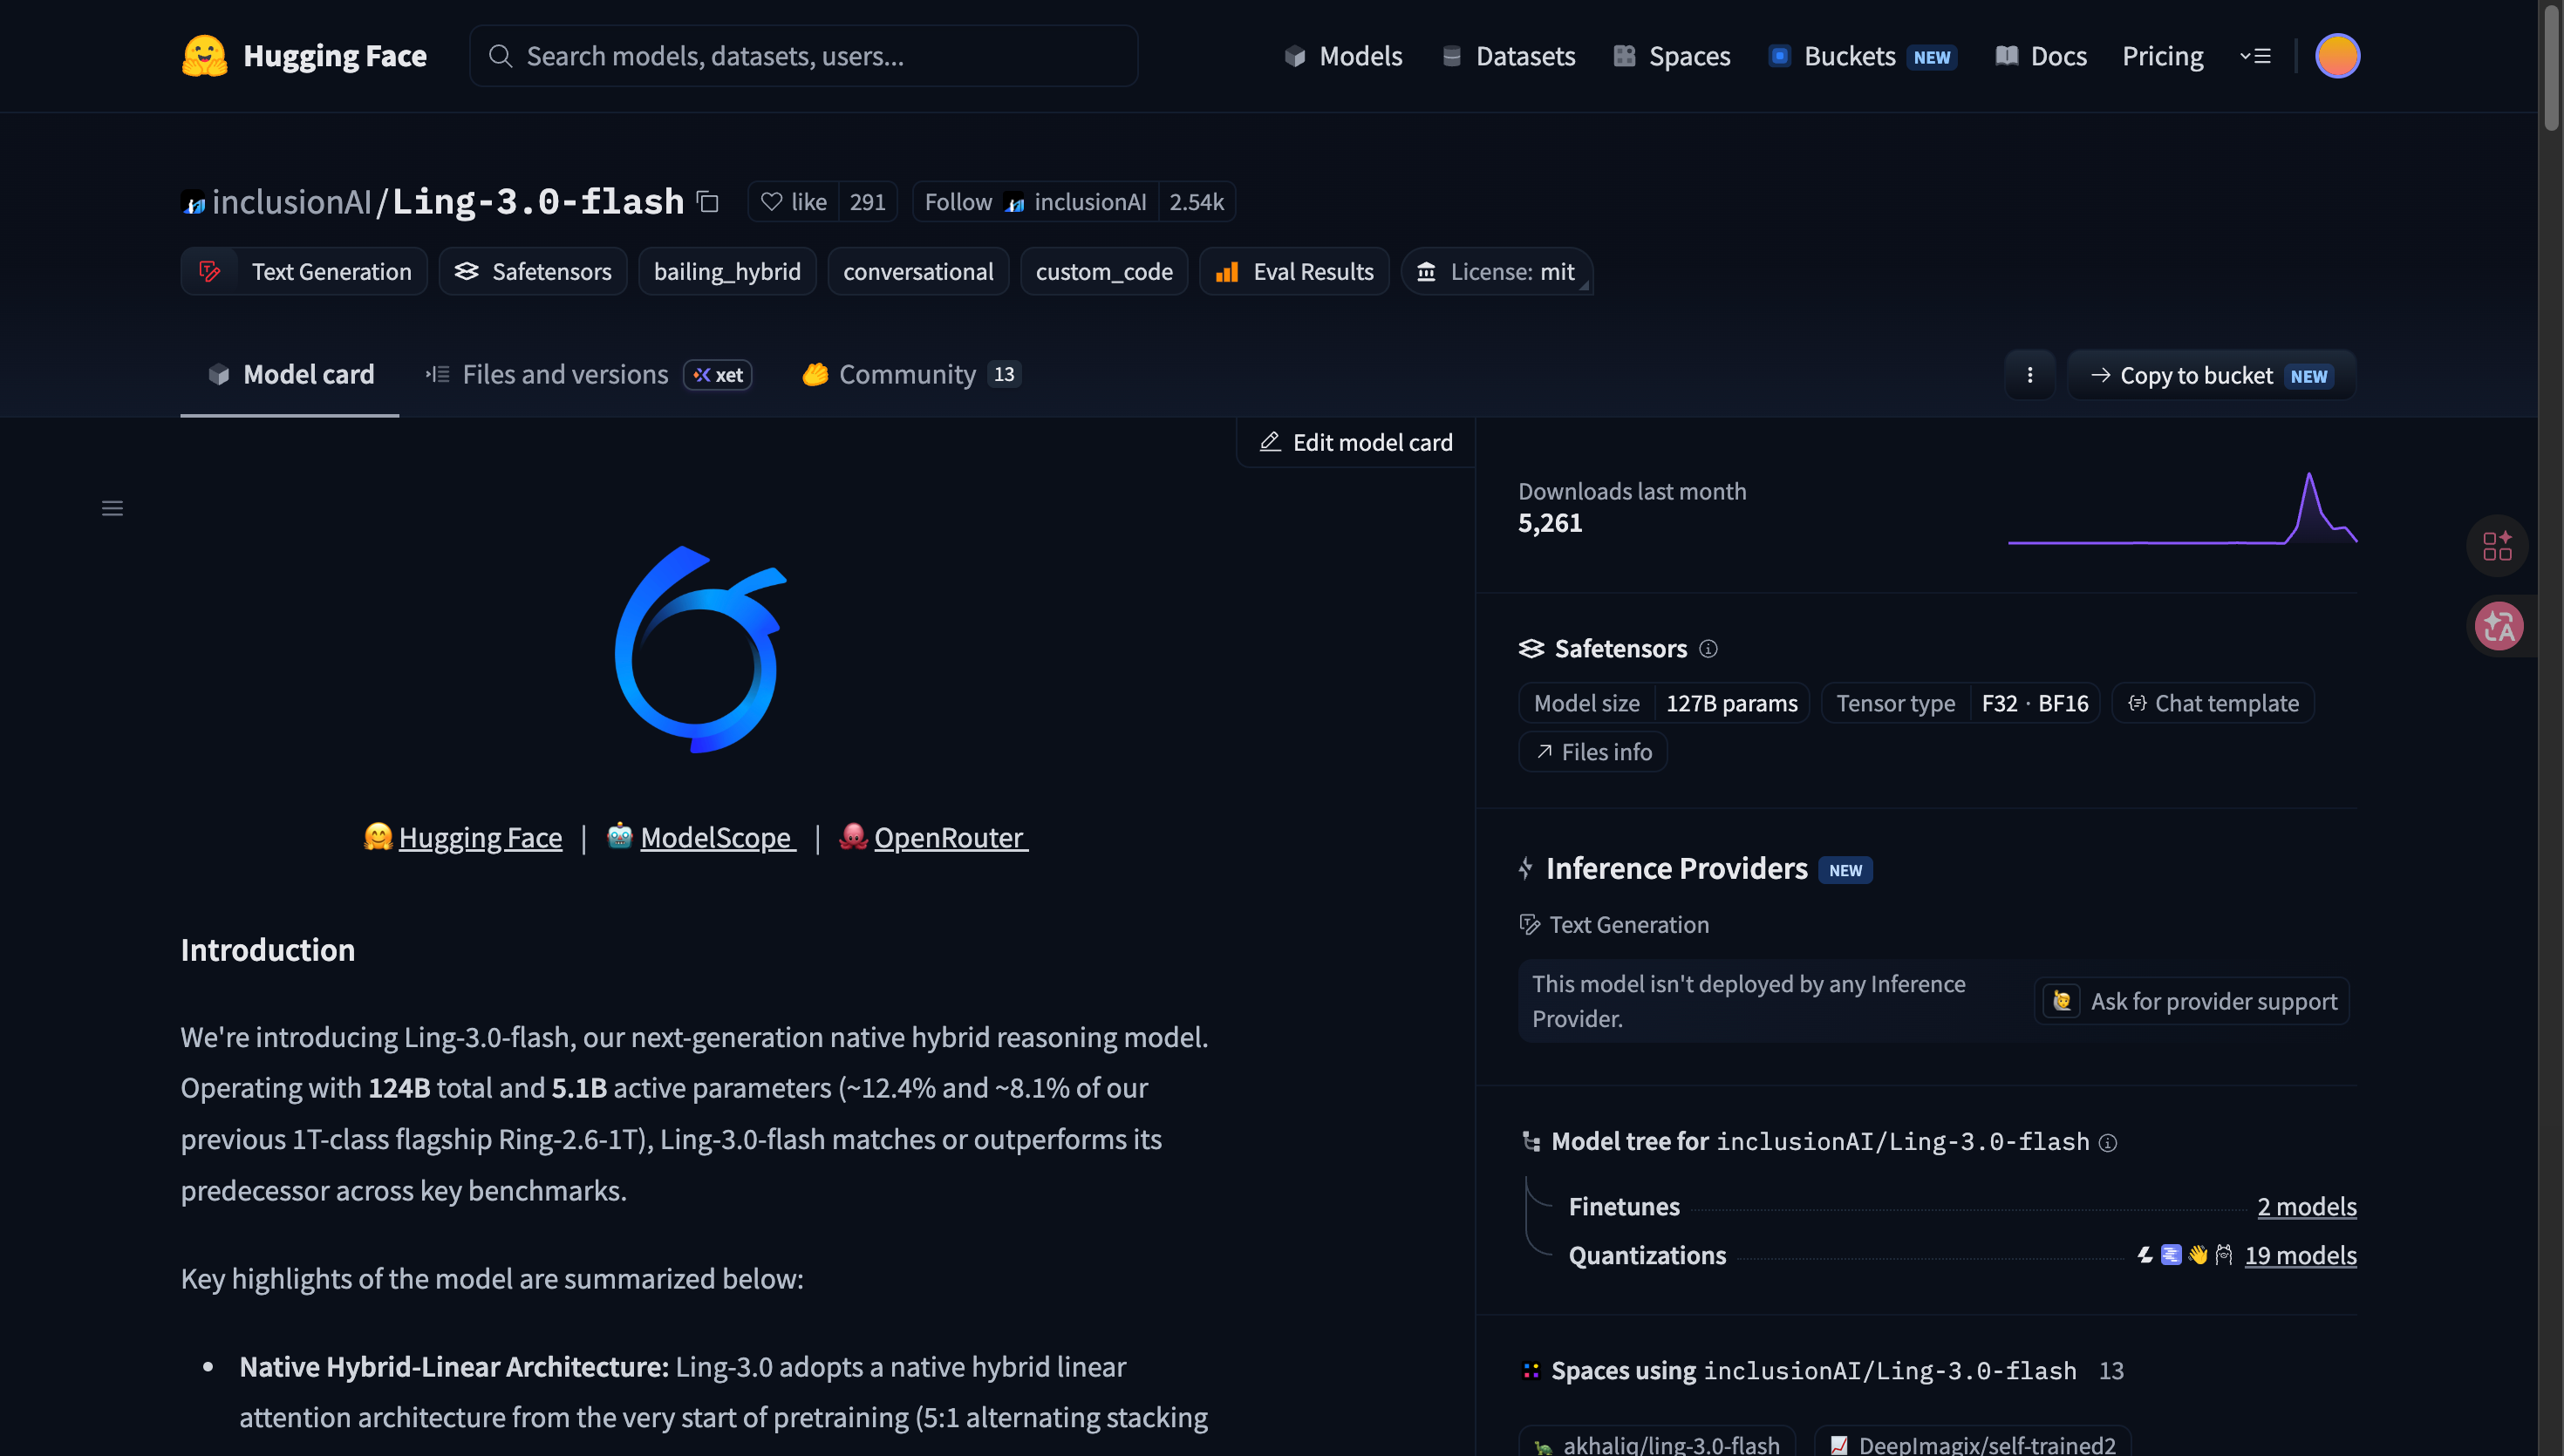
8月11日消息,蚂蚁集团旗下百灵大模型(inclusionAI)开源新一代模型 Ling-3.0-flash,采用 MIT 许可证,权重已上线 HuggingFace 与 ModelScope。这款模型总参数 124B,活跃参数仅 5.1B,占比约 4%,属于高稀疏混合专家(MoE)架构,并支持 FP8、MXFP4、INT4 多种量化格式。官方提供的部署路径包括云 API、单台 NVIDIA DGX Spark 私有化推理,以及高性能配置下平均输出速率超过 1100 tokens/s。
124B 总参、5.1B 激活:稀疏化把成本压下来
Ling-3.0-flash 的亮点在于参数结构与推理成本的组合:总参数决定能力上限,活跃参数决定单次推理的算力开销。5.1B 活跃参数意味着模型在一次推理中只激活约 4% 的参数,配合 MoE 与混合线性注意力架构,把单位请求的推理成本压到接近小模型的水平。模型采用原生混合线性注意力设计,交替堆叠线性注意力层与 MLA 层,上下文窗口原生 256K,可扩展至 1M。
量化与部署:API、单机与高性能三档
官方给出三种落地方式。云 API 面向需要快速接入 Agent 应用的场景,无需自建推理服务。单机私有化面向数据不出域的需求:MXFP4 与 INT4 版本可以在单台 NVIDIA DGX Spark 上完成端到端推理。高性能部署面向吞吐优先的场景,在指定 GPU 配置下平均输出速率突破 1100 tokens/s。
量化版本按精度划分:BF16 原版约 255GB,FP8 版约 128GB,另有 MXFP4 与 INT4 变体。本地 MXFP4 配置下,生成速度约 80 tokens/s,预填充速度约 2.5K 到 3.5K tokens/s。
性能与成本:榜单数据与长输入优化
第三方榜单数据提供了横截面参考:Artificial Analysis 榜单上,Ling-3.0-flash 的输出速度为 353 tokens/s;按 Intelligence Index 口径,每项任务加权平均调用成本约 0.04 美元,加权平均解码时间约 1.4 分钟。在 MiniAppBench 上,模型通过率为 25.3%,与总参数约为其两倍的 SOTA 模型持平。
长输入场景做了专门优化:结合 SGLang HiCache 与 Mooncake 分级缓存,长输入下的首 Token 延迟(TTFT)降低 60% 到 80% 以上。模型支持 SGLang 与 vLLM 自行部署。
生态与可用性
Ling-3.0-flash 面向生产级 Agent 工作流设计,已入驻 Nous Research 的 Hermes Agent 生态。官方在 Ling Studio 平台提供限时优惠:8月7日至8月31日,相关服务 2.5 折。MIT 许可证允许自由商用与微调,模型在 HuggingFace 与 ModelScope 均可下载。 智能密度:开源模型的新竞争维度
Ling-3.0-flash 把两组数字放在一起:总参数 124B 与活跃参数 5.1B。前者回应能力上限,后者回应落地成本,量化版本再补上显存门槛这一环。这代表开源模型竞争的一个方向:不只在榜单上比能力,也在部署路径上比谁更能把能力级压进单机硬件。模型性能数据来自官方与第三方榜单口径,实际效果需要开发者按自己的硬件与任务验证。
 AI 速览