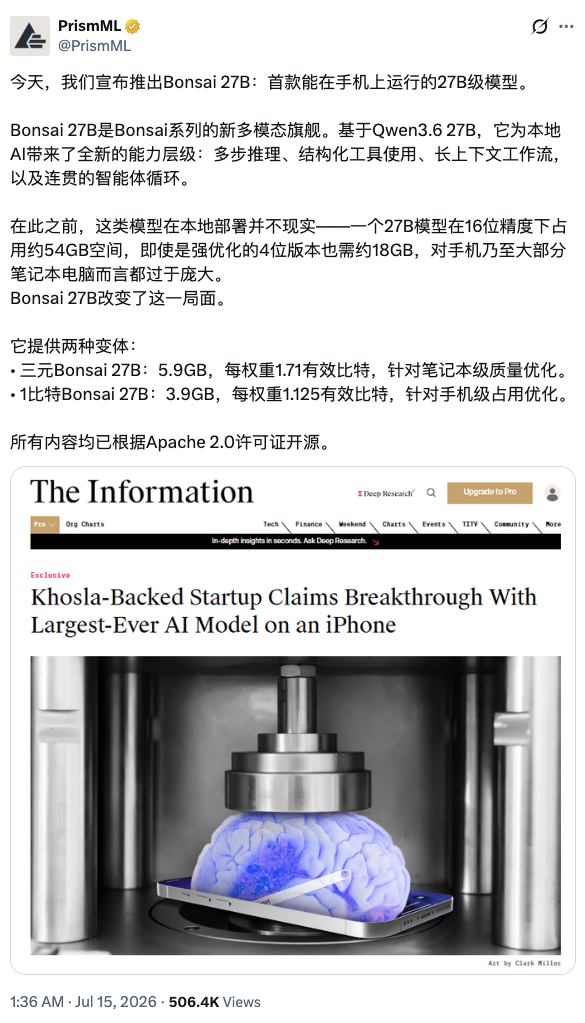
7月15日消息,加州理工衍生的 AI 初创公司 PrismML 确认,苹果正在评估其模型压缩技术。该公司 CEO Babak Hassibi 对 CNBC 表示,苹果及其他公司正在测量其模型在设备上的速度、能效与性能,"他们确实正在评估我们的技术",但他将讨论描述为"非常早期"、走向尚不明朗,只说"进展顺利"。就在表态同期,PrismML 开源发布了 Bonsai 27B,把阿里开源的 Qwen3.6-27B 从约 54GB 压缩到不足 4GB,使全部 270 亿参数得以在 iPhone 上运行。需要强调的是,"苹果在评估"这一说法目前来自 PrismML 一方的表述与 The Information 此前报道,苹果本身未公开置评,也没有任何协议或部署时间表。
苹果在评估什么,处于什么阶段
关于这次接触,可核验的信息有两层。The Information 在 7 月 9 日率先报道,苹果已就如何利用 PrismML 技术在 iPhone 上运行更大的 AI 模型与该公司开过会。随后 PrismML CEO Hassibi 对 CNBC 证实,苹果正在评估其模型,测量速度、能效和端侧表现。Hassibi 的措辞相当克制:讨论处于非常早期,尚不清楚会走向何处。这意味着目前既没有合作协议,也没有苹果采用该技术的任何承诺,全部信息来自 PrismML 一方和媒体报道,而非苹果官方。
苹果对端侧压缩的兴趣有明确的产品背景。就在这次消息前后,苹果开放了 iOS 27 公测,让 iPhone 用户首次广泛用上其长期推迟的 Siri 改版,其中部分能力由 Google Gemini 支持。苹果目前的策略是把复杂请求发往其私有云计算服务器或第三方模型,只把一部分任务留在设备本地。据 The Information,苹果现有的端侧模型 AFM 3 Core Advanced 有 200 亿参数,但采用稀疏架构,同一时刻只激活 10 亿到 40 亿参数;而 PrismML 压缩的 Qwen 3.6 有 270 亿参数且可全部同时激活。能在本地跑一个更大、且参数全激活的模型,正是苹果想要评估的能力。 Bonsai 27B 是这次评估的公开证据
支撑这次接触的技术,是 PrismML 同期开源的 Bonsai 27B。它基于阿里的 Qwen3.6-27B,通过把每个权重从 16 位压到 1 位或三值(1.58 位)来大幅削减内存占用。其 1-bit 变体体积约 3.9GB,官方称可在 iPhone 17 Pro 上运行,在该机型上约达每秒 11 token;三值变体约 5.9GB,官方称保留了全精度基准逾 95% 的性能。模型权重以 Apache 2.0 许可上线 Hugging Face,可通过 MLX 在 Mac、iPhone、iPad 上原生运行。就适配手机的难度,PrismML 解释称一部 12GB 内存的 iPhone 实际只给应用约 6GB,模型还要与 KV 缓存和激活值共享这块预算,而约 4GB 的 1-bit Bonsai 27B 是首个能通过这道门槛并留有余量的 27B 级模型。
按 PrismML 的说法,压缩后的模型内存占用为常规版本的十分之一到十五分之一,响应速度快 6 到 8 倍,能耗低 3 到 6 倍。但压缩有代价,Hassibi 明确表示模型整体精度会损失几个百分点,其中事实性知识的衰减比推理、数学和编码能力更明显。关于适配机型,不同来源存在口径差异:官方博客针对 1-bit 变体给出的是 iPhone 17 Pro,而 CNBC 报道称 iPhone 15 及更新机型即可运行,这一差异尚未有统一说法。这些性能数字目前均为公司自述,公开发布正好给了开发者和投资人一个在实验室之外检验其是否成立的机会。
Bonsai 27B 的关键在于它不是一次新的预训练,而是对 Qwen3.6-27B 的低比特重表示,架构本身保持不变。它把权重压到两种形态:1-bit 用 {−1, +1} 二值、有效约 1.125 比特每权重,体积 3.9GB;三值用 {−1, 0, +1}、约 1.71 比特每权重,体积 5.9GB。PrismML 的做法是让低比特覆盖整个网络,包括嵌入层、注意力投影、MLP 和输出头,不留高精度的逃逸通道。按其在 15 个基准、思考模式下用 H100 做的评测,三值版本保留了 FP16 基线约 94.6% 的平均表现,1-bit 版本保留约 89.5%。作为对照,同一基座模型的常规 2-bit 压缩会掉到基线的约 85%(绝对分从 85.07 跌至 72.73),而 PrismML 的三值版本在体积更小的情况下仍拿到 80.49 分——这个"低比特但少掉分"的差距,正是其技术卖点所在。
模型还带有几项与端侧场景直接相关的设计。它保留了 262K 的上下文长度,靠一个约四分之三为线性注意力、四分之一为全注意力的混合架构支撑,KV 缓存采用近无损的 4-bit 量化;视觉塔以紧凑的 4-bit 形式提供,使其在纯文本之外还能处理截图、文档和摄像头输入。速度方面,1-bit 版本在英伟达 RTX 5090 上约达每秒 163 token,在 M5 Max 上约 87 token,在 iPhone 17 Pro 上约 11 token;PrismML 还给出一个端侧能耗指标,称每消耗 iPhone 1% 电量可生成约 672 个 token。Bonsai 27B 之外,该系列还提供 8B、4B 和 1.7B 三种更小尺寸,PrismML 表示下一个要压缩的目标是 Google 的开源模型 Gemma。
PrismML:从加州理工出来的压缩专门户
PrismML 是一家从加州理工学院衍生出来的 AI 实验室,2024 年前后从隐身状态走出,核心主张是"智能密度",即在不增大模型体积和复杂度的前提下,把更多可用智能压进单位算力、内存和能耗中,目标是让模型能跑在机器人、物联网设备和智能手机上。公司联合创始人兼 CEO 是加州理工 Bohn 讲席电气工程与计算数学教授 Babak Hassibi,其研究长期覆盖信息论、信号处理、控制论和机器学习;联合创始团队还包括担任研究共同负责人的 Sahin Lale 与 Omead Pooladzandi,以及负责战略的 Reza Sadri,顾问名单中有 Ion Stoica 等人。
在投资方与产业支持上,PrismML 由 Khosla Ventures、Cerberus 和加州理工提供支持,并获得 Google 支持和三星的持续支持。这次的 Bonsai 27B 并非其首个产品:公司此前已开源过 1-bit 与三值形态的 Bonsai 小模型系列,覆盖 8B、4B、1.7B 等尺寸,用以证明极低比特权重也能产出商用级语言模型。Bonsai 27B 是把这套压缩方法推到 27B 这一能力档位的最新一步,也是苹果这次评估恰好能拿到的、公开可测的样本。正因为方法此前已在更小模型上迭代过,苹果评估的并不是一个孤立的实验,而是一条已经跑了几轮的技术路线。
真正的悬念是它会不会动摇"内存加数据中心"的需求叙事
这次消息容易被读成"苹果要用国产开源模型救 Siri",但更值得关注的变量在硬件需求侧。PrismML 的发布正好撞上一场激烈争论:AI 效率的提升是否会最终削减对内存芯片和昂贵数据中心基础设施的需求。如果把原本需要 8 张 GPU 才能服务的云端模型压到 1 张,或把 54GB 的模型塞进一部手机的说法在实测中站得住,算力和内存的一部分需求就可能从数据中心转移到个人设备。这是这条新闻真正的行业含义,也是它区别于一次普通开源发布的地方。
需要克制的地方同样清楚。CNBC 引述的分析师观点是,即便端侧压缩兑现,整个 AI 产业仍会持续消耗大量芯片资源,因此"重塑需求"不等于"减少需求"。对苹果而言,能在 iPhone 本地跑更强的模型,主要价值在于降低云计算成本、强化其一贯的隐私卖点,以及让部分功能在断网时也能工作,而不是立刻替换其云端与第三方模型的组合。把 CEO 一句"进展顺利"直接读成"苹果即将采用 PrismML",超出了目前材料能支撑的范围——讨论方明确说这仍处于非常早期。
接下来要看性能实测、精度损失与落地信号
后续最该盯的有三条线。其一是公开发布后的第三方实测,PrismML 宣称的 10 到 15 倍内存、6 到 8 倍速度和逾 95% 性能保留能否在真实设备与真实负载上重现,尤其是被官方承认会更快衰减的事实性知识,其损失在实际问答中是否可接受。其二是苹果侧的落地信号,从"评估技术"到任何形式的合作或集成,是这条线索是否成立的分水岭,而这需要苹果自己出面确认,而非仅凭 PrismML 单方面表述。其三是这套压缩路线能否推广,PrismML 已表示下一个目标是 Google 的开源模型 Gemma,若其在不同模型家族上都能复现同级压缩,端侧承接更多 AI 运算的叙事才会更可信。
 AI 速览