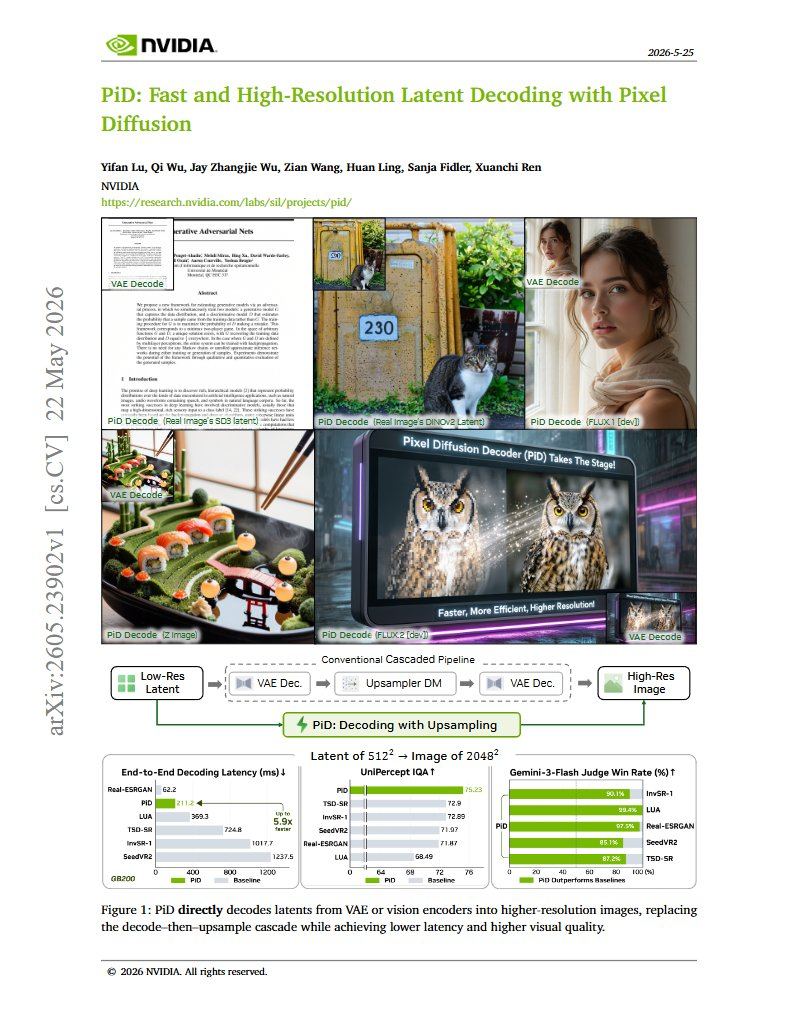
5月26日消息,NVIDIA 多伦多 AI 实验室(Spatial Intelligence Lab,代号 nv-tlabs)正式开源 PiD(Pixel Diffusion Decoder)——一种将"潜变量到像素"过程重构为高分辨率像素空间扩散的解码方案,可在不到 1 秒内将 512² 潜变量直接解码为 2048² 图像,在 GB200 GPU 上单次推理仅 210 毫秒,模型权重、训练代码与论文均已在 Hugging Face 与 GitHub 同步公开。该工作被业内视为对当前主流 Latent Diffusion Model(LDM)管线"VAE 解码 + 级联超分"的一次结构级替代尝试。
重构解码与超分,做成单一像素扩散模块
PiD 的核心思路是:现有 LDM 管线中,VAE/RAE 解码器本质是被训练用来"还原"潜变量对应的图像,而非生成更多细节,在百万像素级别上既贵又损失锐度。PiD 转而把解码器本身做成一个条件像素扩散模型,在目标分辨率的像素空间直接预测速度场,统一了解码与上采样两个步骤。论文作者团队包括 Yifan Lu、Qi Wu、Jay Zhangjie Wu、Zian Wang、Huan Ling、Sanja Fidler 与 Xuanchi Ren,均来自 NVIDIA。
为了让像素扩散解码器能与不同潜空间适配,团队引入了一个轻量的 sigma-aware adapter,将"被噪声污染过的潜变量"注入像素扩散主干,使 PiD 在 base LDM 尚未完全去噪时即可介入解码,从而让 LDM 提前终止剩余去噪步骤。配合 DMD2 蒸馏,推理过程被压缩到 4 步完成。
单卡 RTX 5090 不到 1 秒,B200 上 210 毫秒
性能方面,512² → 2048² 全流程在消费级 RTX 5090 上耗时不到 1 秒,峰值显存 13GB;在数据中心级 GB200 GPU 上耗时低至 211.2 毫秒,相比 SeedVR2 同等任务 1237.5 毫秒的延迟快约 5.9 倍。论文指出 PiD 比典型的级联式扩散超分管线整体快约 6 倍,同时在视觉保真度上更优。
PiD 提供 2k 与 2kto4k 两个 checkpoint 变体:2k 用于 512² 潜变量 → 2048² 像素的标准路径,2kto4k 则面向 1024² 潜变量 → 4K(3840 像素)路径,在 4× 与 8× 上采样场景下均可工作。在 Hugging Face 上,nvidia/PiD 仓库已托管基于 FLUX.1、FLUX.2、SD3、Z-Image、DINOv2、SigLIP 等多种 backbone 的解码权重。Z-Image 因共享 Flux.1 的 VAE 而直接复用 FLUX checkpoint,不再单独发布。
适配 VAE 与语义潜空间,可作 ComfyUI 插件
PiD 同时支持传统 VAE 潜变量(如 FLUX、SD3、Z-Image)与近期 RAE 系模型使用的语义潜变量(DINOv2、SigLIP),后者通常因语义压缩过强而难以靠原生解码器还原像素,PiD 在这一场景下的视觉差距尤为明显。GitHub 上对应 issue 已有 ComfyUI 用户提出适配请求,社区早期评测反馈,PiD 在 StableDiffusion 工作流中能明显改善 VAE 解码丢失的细节与纹理。
竞品对比上,论文将 PiD 与 InvSR-1、Real-ESRGAN、SeedVR2、TSD-SR 等主流 SR 方案做了 512² → 2048² 端到端对比,在 Gemini-3-Flash 作裁判的偏好评测中,PiD 在多数 baseline 对比中胜率更高。 局限与待解问题
值得注意的是,PiD 并非纯粹的"免费替换"。论文与代码仓库明确指出,2kto4k checkpoint 目前仅对 FLUX/FLUX.2/SD3/Z-Image 等 diffusers backbone 开放,DINOv2、SigLIP 等语义潜空间暂无 4K 变体;在 2048 像素分辨率下,2kto4k 的视觉质量也不如专门训练的 2k checkpoint。此外,PiD 整体仍是一个学术 release,部署到 ComfyUI、Diffusers 等生产管线尚需社区适配,与现有 LDM 工作流的稳定性、batch 推理吞吐等指标也有待更长周期的验证。在工程上,PiD 的关键价值在于把"解码+超分"压缩为单 pass 生成模块,这一思路是否会被 FLUX、SD3 等主线模型在下一代版本中原生集成,将是未来几个月值得跟踪的方向。
 AI 速览