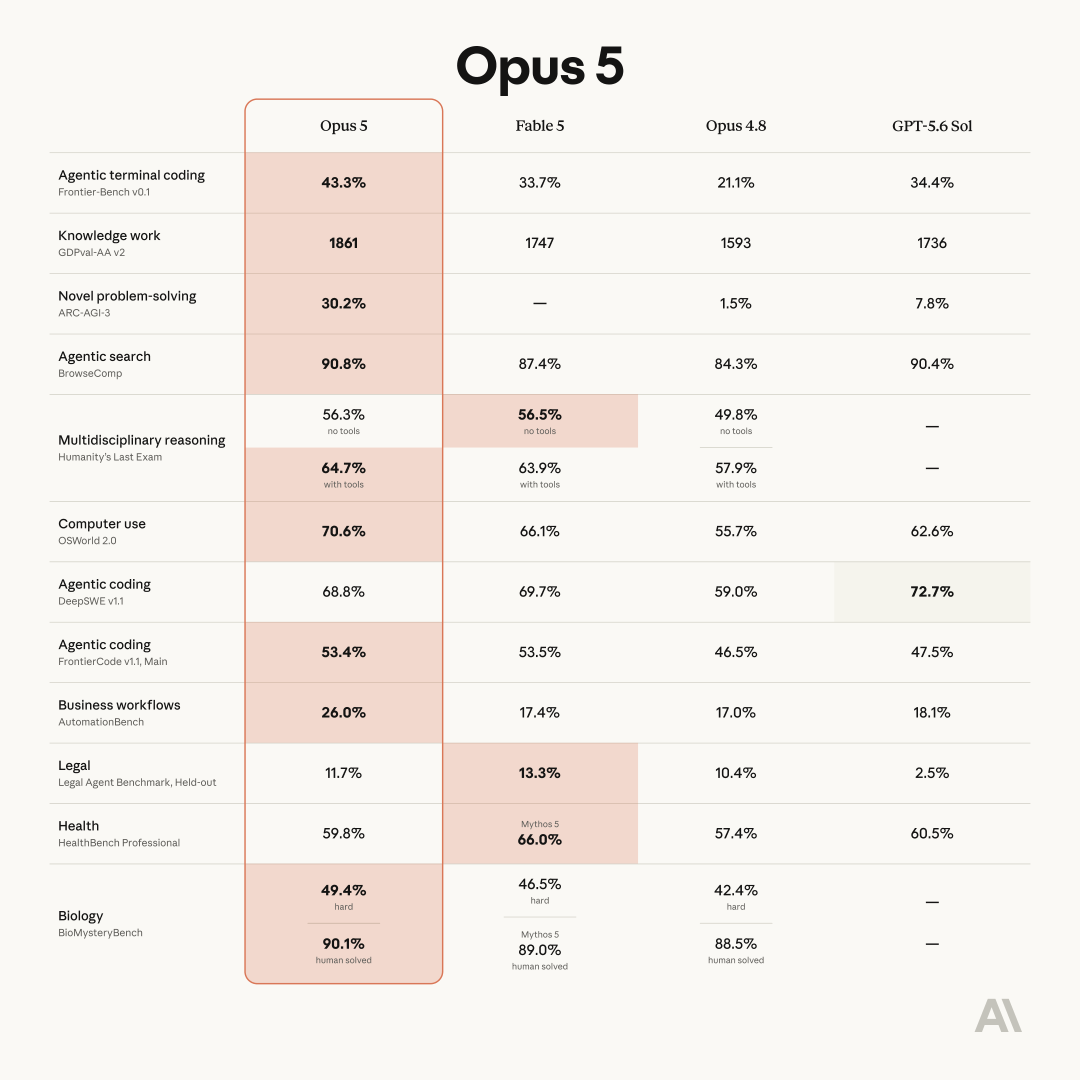
2026 年 7 月 Anthropic 凌晨上线 Claude Opus5,全平台同步开放,搭载 100 万上下文窗口,知识库更新至 2026 年 5 月,定价与 Opus4.8 保持一致,仅为 Fable5 一半,实测工程、代码、自动化任务表现突出,但与 Fable5 存在清晰场景分工,二者无法完全替代。 一、定价与核心基准性能拉开差异化优势
Opus5 计费标准不变:输入 5 美元 / 百万 Token、输出 25 美元 / 百万 Token;
Fast 加速模式价格翻倍,推理速度提升 2.5 倍。核心泛化能力极具竞争力,ARC-AGI3 陌生任务推理得分 30.2%,是 GPT-5.6 Sol 的近 4 倍,远超前代 Opus4.8。
在 AA 智能体、自动化评测基准上成绩优于 Fable5,OSWorld 等实操场景仅需一半成本就能追上高端模型上限。
二者定位存在明确区分:Fable5 偏向深度规划、原生视觉、网络安全、高难度底层科研;Opus5 擅长工具调用、自主排错、批量工程落地,更适合日常开发、产品迭代、批量运维类高频任务。
二、实操实测:代码漏洞检测能力显著提升
以 AI 资讯平台 AIHOT 重构为实测案例,此前使用 GPT-5.6、Kimi K3、Opus4.8 审核代码,仅能找出细微表层问题; 更换 Opus5 复测后,直接查出可击穿缓存、造成流量账单崩盘的高危底层漏洞,修复价值极高。UI 设计环节搭配 Claude Design 协同,产出界面规整度优于 GPT 系列与 Opus4.8;
仅纯文学创作场景,Opus4.6 依旧保持最优表现。
依托更强自检能力,Opus5 大幅降低线上故障风险,适合需要长期稳定迭代的互联网产品团队。
Opus5 理解能力大幅提升,官方精简 80% 以上 System Prompt 约束,无需堆砌大量示例、禁令类提示词,模型可自主协调多冲突指令。
行业底层逻辑发生转变:从前依靠海量规则限制模型,如今只需搭建标准化 Harness 运行环境,把目标、权限、反馈机制嵌入环境,将判断空间交给 AI 自主处理。
官方推出/doctor清理命令,一键清除过时 Skill、冗余插件,随着大模型智力提升,传统人工约束类工具价值持续衰减,开发者可大幅精简本地工具库,仅保留少量自研核心技能。
四、企业混合模型搭配最优落地方案
结合实测体验,形成成熟分层模型使用策略:
- 底层架构、长期方案规划、前沿科研:选用 Fable5,深度推演能力无可替代;
- 常规开发、代码审核、UI 设计、系统重构:优先 Opus5,性价比拉满;
- 离线大型代码复审:网页端 GPT-5.6 Sol Pro;
- 前端展示页面快速生成:Kimi K3。 对于 Fable5 额度受限的团队,采用「50% Fable5 深度规划 + 50% Opus5 落地执行」搭配模式,既能保证顶层方案质量,又能控制算力开支,解决高端模型额度不足、成本过高的痛点。
五、行业迭代新趋势
当前大模型迭代节奏大幅加快,厂商更新周期缩短至两周,模型智力突破原有约束限制,人工预设规则、专用辅助工具的价值持续缩水。
未来 AI 工作流的核心竞争力不再是堆砌大量提示词与插件,而是搭建合理的运行环境,依靠模型自主完成拆解、校验、迭代全流程,普通开发者也能依托新型大模型快速完成产品规模化迭代。
 AI 速览