你现在每天都在跟 AI 对话做 Vibe Coding,但你可能不知道每次对话底层发生了什么。这一篇用最直白的方式讲清楚 8 个关键术语——知道了这些,你就能理解为什么 AI 有时候"忘事"、为什么字数多了要等很久、为什么有时候回复格式乱七八糟。
AI 入门
AI 应用基础
VibeHub 里的原话:"AI 应用是把模型、产品界面、数据和工具组合起来完成用户任务的软件。"
你用的 Cursor、Claude、ChatGPT 都是"AI 应用"——底层有一个大模型(比如 Claude、GPT-4),上面又加了界面、数据、工具。你只需要知道:你聊的是一个包装好的产品,底层是模型。有时候问题出在"产品"层,有时候出在"模型"层。 输入与上下文
Token
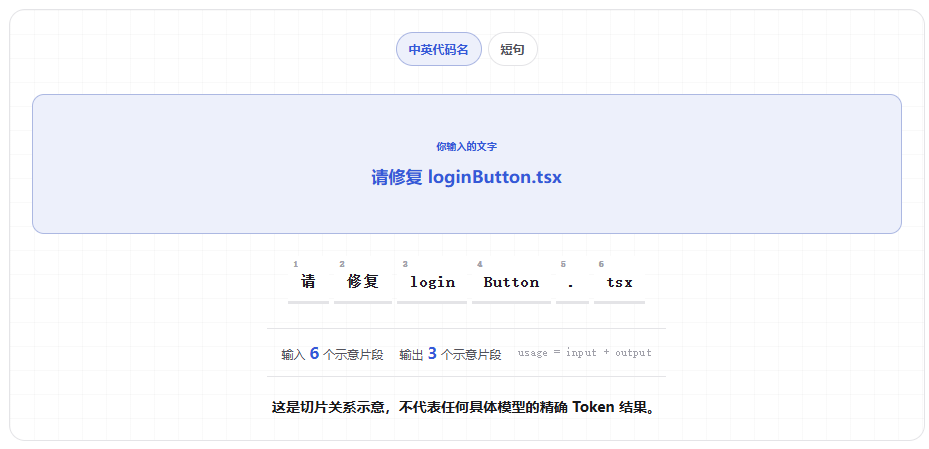
Token 是 AI 理解文字的最小单位。一个 Token ≈ 0.75 个中文汉字。英文大概一个词 1 个 Token,中文大概一个字 1-2 个 Token。
VibeHub 里的原话:"Token 是语言模型读取和生成文本时使用的文字、标点或代码片段单位。先切片 → 再读再写 → 两边都计数。"
为什么你需要知道 Token:你的消息、AI 的回复、对话历史,全部消耗 Token。模型按 Token 数收费(收多少取决于模型型号)。
对 Vibe Coding 的影响:如果你一次性把整个代码库都贴进对话,消耗的 Token 量很大,意味着:
上下文窗口(Context Window)
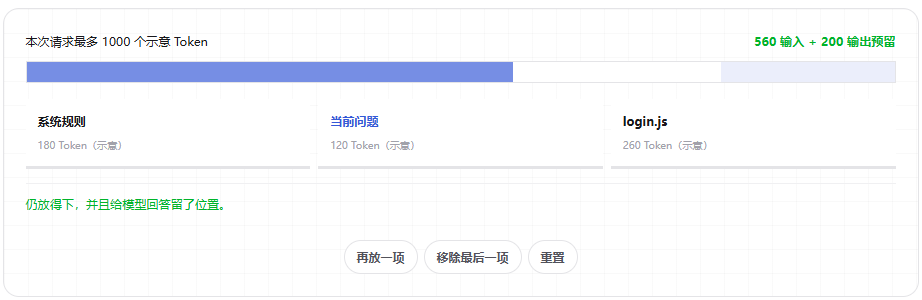
AI 一次能"看"多少信息就是上下文窗口的大小。比如 Claude Sonnet 的上下文窗口是 200K Token(大约 15 万个汉字)。
VibeHub 里的原话:"上下文窗口是模型一次请求中能够同时读取并为输出预留的 Token 总量。都要装进去 → 给回答留座 → 不够就取舍。"
为什么你需要知道上下文窗口:当你跟 AI 聊了很长(贴了很多代码、反复修改了很多轮),历史消息越来越多,最终会填满上下文窗口。填满之后有两种结果:
- 新的对话覆盖最早的对话——AI 会"忘记"最开始的上下文
对策:长对话里,每轮只贴相关的代码片段,不要整文件贴。重要的上下文(项目结构、设计要求)放到对话开头或者系统提示词里。
系统提示词(System Prompt)
你打开一个新的 AI 对话时,可以给它设一段"行为准则"——这就是系统提示词。告诉 AI "你是什么角色"、"输出格式是什么"、"禁止做什么"。
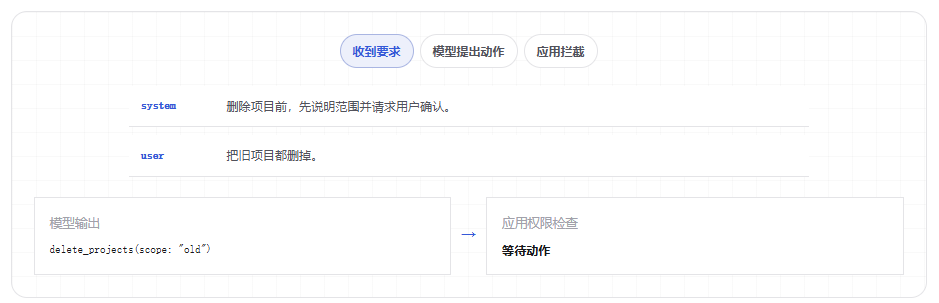
VibeHub 里的原话:"系统提示词是产品随请求提供给模型、用于设定长期行为和回答规则的指令。系统提示词 → 规则影响建议 → 模型仍在建议 → 产品才会拦截。"
在 Vibe Coding 里的用法:
- "你是一个资深前端工程师,精通 React 和 Next.js"
喂给 AI 的话:
"以下是系统提示词:你是一个资深前端开发者。回复时用中文。每次修改只显示改动代码,不输出完整文件。组件用 React + TypeScript + Tailwind CSS。"
对话历史(Conversation History)
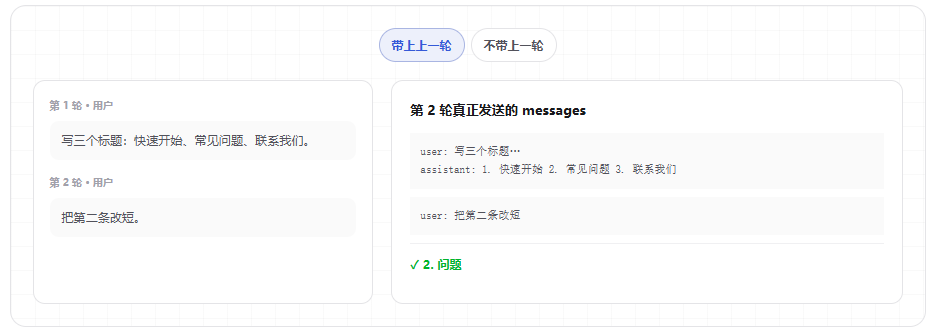
你跟 AI 的每一轮对话都会被保存下来,在下一轮时重新发送给 AI。这就是为什么 AI 记得"刚才我说了什么"。
VibeHub 里的原话:"对话历史是产品保存并在后续请求中重新提供给模型的先前消息记录。有历史 → 没有历史(每次都是新的开始) → 带回相关部分(只取相关部分)。"
为什么你需要知道:对话历史越长,Token 消耗越大,响应越慢。如果对话变得很卡,可以清空历史重新开始——但记得把重要的上下文(项目结构、关键需求)在新的对话里重新放进去。
请求与输出
无状态请求(Stateless Request)
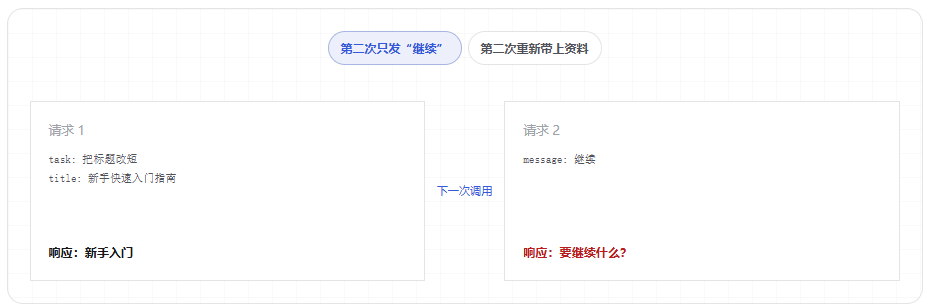
AI 本身不记得"你是谁"或者"刚才说过什么"。每次请求都是独立的。AI 能"记住"对话是因为产品(比如 Cursor、Claude 的聊天界面)把历史消息也发给了它。
VibeHub 里的原话:"无状态请求是模型只根据本次实际收到的内容处理任务的请求方式。本次包裹 → 产品找背景 → 再保存新结果。"
结构化输出(Structured Output)
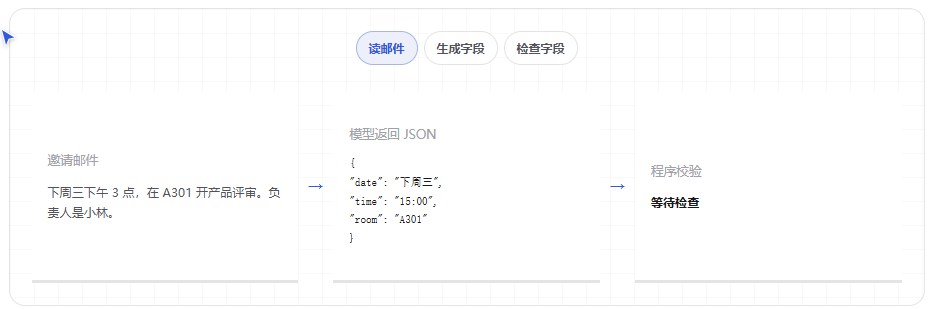
让 AI 返回指定格式的数据(通常是 JSON),而不是自由文字。这样程序可以直接使用 AI 的回复,不用再去做文字解析。
VibeHub 里的原话:"结构化输出是要求模型按预先规定的字段和数据类型返回结果的方式。先定字段 → 邮件变 JSON → 再做业务检查。"
在 Vibe Coding 里的用法:你想让 AI 从一段用户评论里提取结构化信息。
喂给 AI 的话:
"从以下用户评价中提取信息,以 JSON 格式返回: { 'rating': 数字, 'positive_aspects': 数组, 'negative_aspects': 数组, 'category': '设计' | '功能' | '性能' } 评价内容:'这个产品界面很漂亮,但是加载太慢了,希望后续优化性能。'"
流式响应(Streaming Response)
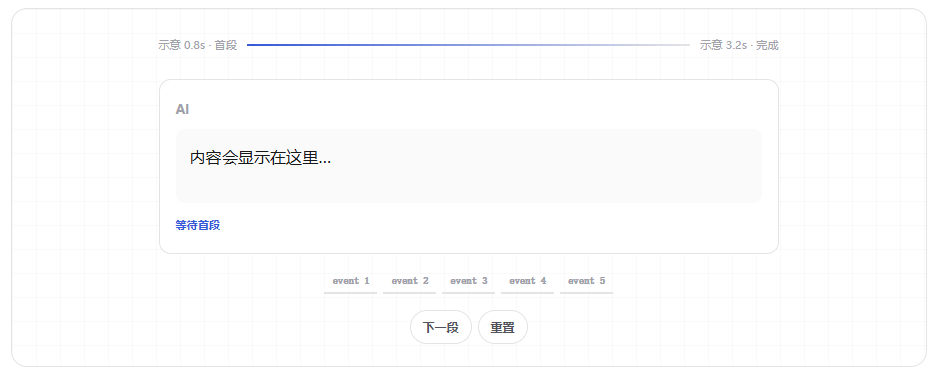
AI 不是一个字一个字全部生成完再给你,而是"生成一点发一点"。你在对话框里看到的文字逐段出现,就是流式响应。
VibeHub 里的原话:"流式响应是服务器把生成结果分成连续片段发送、界面逐段显示的传输方式。片段抵达 → 界面追加 → 等待仍在继续。"
为什么你需要知道:如果遇到生成了一大段文字但迟迟不结束的情况,可能是流式响应出问题。另外,代码生成时流式响应有个特性——如果 AI 生成到一半你打断了,它不会从头重来,而是继续从断点生成。
 AI 速览