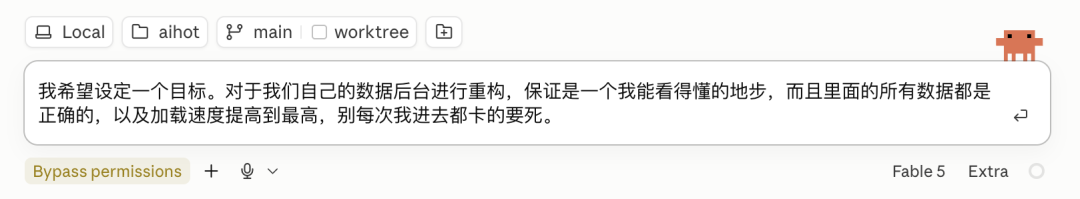
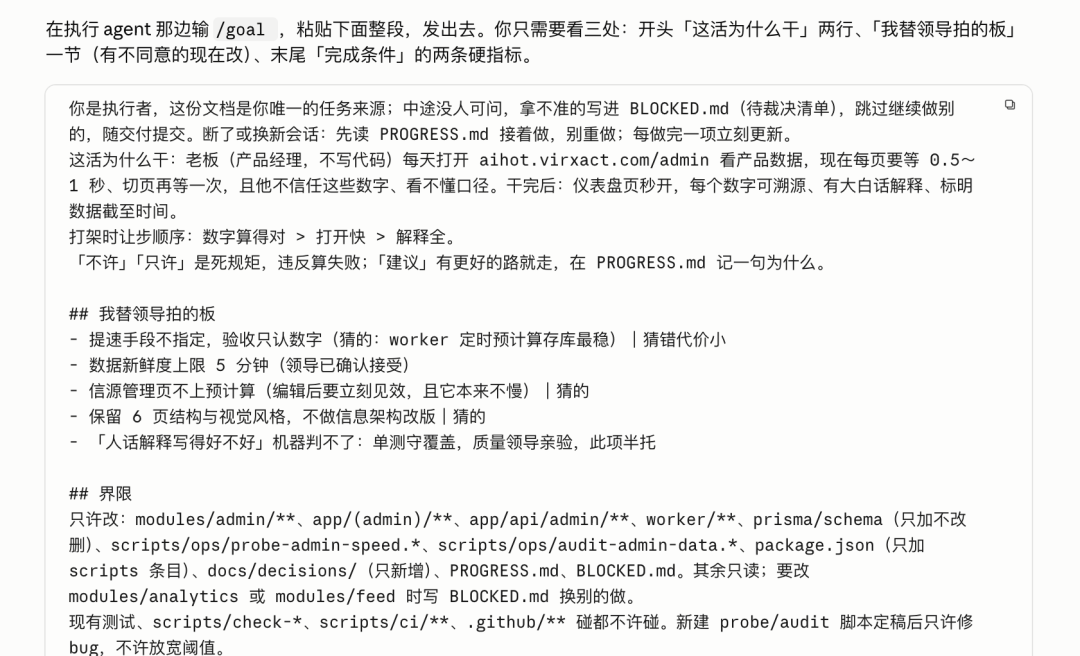
随着 Agent 技术进入长程目标执行阶段,模糊的需求描述已成为算力浪费的核心原因。开发者基于 20 亿 Token 的踩坑经验,开源Leader.skill工具,依托标准化目标拆解方法论,将口语化模糊需求转化为 Agent 可直接执行的任务书,大幅提升长程任务完成率,降低无效 Token 消耗。
一、行业痛点:目标制时代,需求模糊成最大算力杀手
AI 与人类的交互范式已完成三次迭代:从一问一答的聊天制,到单任务自主执行的任务制,再到如今的目标制 ——Claude Code、Codex 等工具均支持/goal模式,Agent 可自主拆解任务、调用工具、重试纠错,连续工作数小时甚至数天。 长程执行模式解放了人力,但也放大了目标偏差的损失:短任务跑偏可即时纠正,长任务一旦方向错误,Agent 会沿错误路径持续运行,单次就能浪费数十亿 Token。行业核心矛盾已从 “AI 会不会做” 转向 “目标对不对”,目标工程(Goal Engineering) 的优先级已高于单纯的循环优化。
二、核心方法论:目标七问法,兼顾意图与边界约束
Leader.skill 的底层逻辑源自两大管理思想:
一是军事领域的指挥官意图,明确 “为什么做” 和 “最终达标状态”,让 Agent 在突发场景下可灵活应变,而非机械执行指令; 二是边界约束(Harness),提前堵死所有投机取巧路径,其重要性远高于单纯设定目标。
基于此总结出目标七问框架,覆盖任务全维度约束:
- 目的 Why:明确任务核心价值,作为分支决策的判断依据
- 完成态 Done:具象化验收标准,可直接判定是否达标
- 证据 Proof:规定验证方式与判定标准,避免自证达标
- 反作弊 Anti:禁用投机路径,保证任务的实质价值
- 边界 Bounds:划定操作范围、资源上限,防止越权修改
- 取舍 Trade:明确冲突场景的优先级,减少无效等待
- 未知 Unknown:规定陌生场景处理原则,避免停滞或盲动
三、工具实操:12 分钟生成标准化可执行任务书
Leader.skill 定位为 “目标翻译官”,专门解决模糊需求无法直接喂给 Agent 的问题,全程无需人工撰写复杂提示词。
标准使用流程分为三步:
首先输入原始口语化需求,例如 “重构后台、要看得懂、数据要准、加载要快”;
其次工具自动调研行业方案,向用户确认 5 个核心决策问题,补全关键偏好;
最后基于目标七问法,约 12 分钟生成完整任务书,包含任务背景、决策事项、操作边界、验收指标、异常处理规则。
产出的任务书可直接粘贴至/goal模式启动执行,用户仅需核对核心决策与最终结果,无需中途干预。
四、多模型搭配方案,兼顾效果与性价比
结合不同模型的能力特点,最优实践采用 “规划 + 执行” 分离模式,最大化性价比:
- 规划端:选用 Claude Fable 5、Kimi K3 等强推理模型,配合 Leader.skill 产出高质量目标书,保证方向正确
- 执行端:选用 Opus 5、GPT-5.6 Sol、GLM-5.2 等高性价比模型,承接长程落地任务,控制算力成本 该模式既利用高端模型的规划能力,又用中端模型消化执行工作量,还能充分利用不同平台的会员额度。仅使用单款模型的用户,也可直接用同一模型完成全流程。
五、开源价值与泛化应用场景
目前 Leader.skill 已在 GitHub 开源,可直接导入 Agent 的技能目录调用。除代码开发场景外,这套目标拆解框架还可复用至团队管理、市场策划、运营方案等场景,本质是一套通用的目标落地工具,帮助管理者将模糊想法转化为可执行、可验收的标准化方案。
在 AI 全面进入目标制的当下,优质的目标定义能力,将成为决定 Agent 生产效率的核心变量。
 AI 速览