若你在本机长期运行 OpenClaw,同时接通飞书、微信与网页端,再叠上成摞的技能包和定时任务,迟早会在账单或网关统计里撞见同一个现象:输入 token 涨得飞快,会话和转录文件也在悄悄变胖。本文把这类问题拆成「钱从哪儿烧、盘从哪儿长」,再给出一套分层治理做法——先在架构上划清边界,再用配置收住底座与存储,最后用工作习惯防止旧病复发,并穿插说明与官方机制(会话、压缩、cron)各自的分工,避免把几件事混成一锅账。 1. 先弄清:臃肿从哪来
人们常把「上下文太大」想成一句话能说清的问题,实际上它往往是三类负担叠在一起。
第一类是固定底座。网关会把技能清单以某种形式注入系统侧;技能越多、description 越长,每一轮请求里带的「技能索引」就越厚。它不一定随轮次线性涨,但每一轮都在付,所以特别值得单独治理。
第二类是对话历史。多轮往返时,近期消息会反复进入模型输入;轮次上去之后,历史往往成为增长的主项。压缩机制会缓解「接近窗口上限」时的压力,但那是另一套故事,后面会专门对照。
第三类是工具回灌:读大文件、搜索结果、浏览器快照等一旦整段进入下一轮 prompt,单次回合也可能瞬间膨胀。若三件事同时存在,账单上就容易出现输入远大于输出——这通常不是因为模型话写得多,而是重复携带了底座、历史与工具产物。
与「模型能看见多少字」并行,还有一条线:磁盘上的会话。网关为每个会话维护元数据与 .jsonl 转录。压缩(compaction)改的是「下一发送给模型的内容」,并不会自动替你删掉磁盘上的完整历史;若从不维护会话存储,条目与体积仍会上涨。换句话说——窗口治理和存储治理要分开想,不能指望一个开关两件事全包。
2. 架构:先把「人聊的」和「钟点跑的」分开
理清代价来源之后,第一层下手最划算的是权责边界:人类从各渠道进来的对话,和 crontab 触发的代理回合,不应共用同一条会话语义上的「主线」,否则定时任务会像心跳一样不断给主会话加长度,或至少让会话列表变得难以阅读。
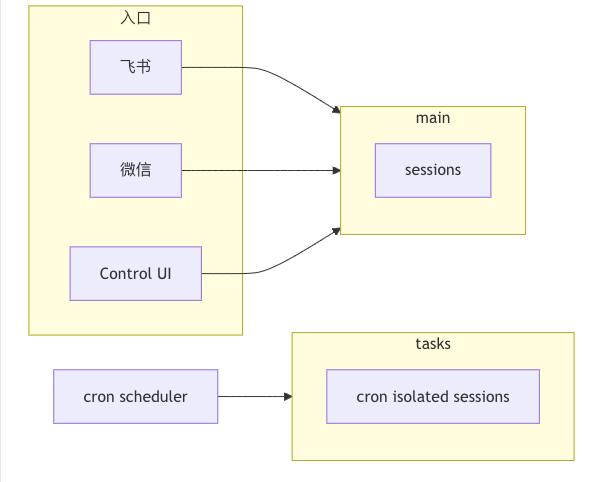
一种最小可行的拆法是使用两个 Agent:main 承载飞书、微信、Control UI 等入口;tasks 专门跑 cron/jobs.json 里需要 Large Language Model 的 agentTurn 任务。各自的会话落在不同的目录下,天然互不混写同一份会话历史。定时侧继续配合 sessionTarget: "isolated",让每个 job 在 tasks 名下有自己的隔离会话,避免「每十分钟一次」的维护任务和你在主窗口里的长谈挤在同一条 thread 里。
当然,也有必须留在主会话里的系统事件(例如某些 memory-core 相关的 dreaming)。这类例外要以产品文档为准,显式把 agentId 留在 main,不要为了「减负」一律挪到 tasks——那会动到语义,而不仅是 token。
我并不建议走向另一个极端:按技能切开许多常驻 session。技能边界不等于对话边界,session 数量一多,运维和心智成本会陡增。更稳妥的做法是按工作域或项目换会话(例如 /new),或者把重活丢给子代理(见后文),让「会话条数」长在刀刃上。
3. 配置:收紧技能可见性,管住会话生命周期
架构划清之后,第二层是把默认就注入的东西变瘦。OpenClaw 允许为每个 Agent 配置可见技能集合:在 openclaw.json 里,agents.defaults.skills 可以作为主对话的基线白名单;而对 tasks,可在 agents.list 里为对应 id 单独写 skills。需要留意官方语义——tasks 上的列表通常是最终集合,不会与 defaults 再合并,因此定时侧只列与脚本、归档、读状态真正相关的少量技能即可;主对话侧则要在「省 token」与「别把自己常用能力砍没了」之间自行权衡,冷门能力可以移出名单,需要时再通过读 SKILL.md 或把 id 加回配置并重启网关。 与「一条会话里能聊多长」正交的另一项配置,是会话存储的维护:在顶层使用 session.maintenance,用 mode、maxEntries、pruneAfter 等字段约束 sessions.json 的规模与陈旧条目。动手前不妨先跑 openclaw sessions cleanup --dry-run --all-agents,看清 Planned session actions 里哪些会保留、哪些会淘汰,再决定是否在 enforce 下长期自动执行。
此外,时间维度上还有 cron.sessionRetention 一类选项(具体字段以当前版本文档为准),面向 isolated cron 产生的会话条目做回收,与按条数上限裁剪形成互补:一个管「多久算旧」,一个管「最多堆几条」。
4. 习惯:文件、子代理与换一条线
配置能兜住底色和上限,但能不能在三个月之后仍不「吃回老问题」,很大程度上取决于习惯——这些通常写不进 JSON,却决定你会不会再一次把整本书塞进同一场对话。
把可以复用的结论写进分层文件(例如短期流水、长期 MEMORY.md、主题 topics、环境差异进 TOOLS.md),下一回合只需要 read 一小段,比在同一会话里无限往前滚要省 tokens,也更利于检索与审阅。重搜索、重核实的长链工具调用,适合用 sessions_spawn 一类子会话承接;若任务一次性完成,应养成 cleanup: "delete" 的习惯,避免子会话长期占着列表,又变成新的堆积源。项目切换或阶段切换时,/new 开新会话并不是失败,而是主动换一条更轻的历史链——先把上一段的摘要写进 memory,再在新线程里轻装上阵,这和「按需加载技能」是同一套逻辑。
5. 与几项官方机制的区分(少踩坑)
机制它擅长什么它不替你做什么Compaction临近或超过上下文上限时,把更早的轮次摘要掉,让对话能继续不等于自动删除会话存储里的全部历史文件技能白名单缩小每轮注入的技能索引体积不替代「需要时再读 SKILL」的协作方式main / tasks 拆分对话线程与定时线程在会话层面隔离不自动合并或删减磁盘上已有的转录
把这几条分清楚,就不容易「开了压缩还以为盘不会长」,也不会「拆了 Agent 却还在一个会话里堆全套技能」。
6. 收益、风险与收束
做好第一层,你会看到主会话的技能快照变短、定时与闲聊在列表上分道扬镳,输入规模更好预测。风险也实在:白名单过窄会导致某个突然任务找不到技能——把对应 id 加回去并重启网关即可;维护策略过狠可能误伤仍在用的 key——用 dry-run 先验,再放宽 maxEntries 或 pruneAfter;系统事件绑错 Agent则可能让记忆或 dreaming 跑错地方——改前务必对照官方说明。
归根结底,上下文治理不是找一个「神开关」一劳永逸,而是把谁占哪条线、默认注入多厚、存了多少会话、日常怎么走文件与子代理四件事长期对齐。对个人或工作站上的 OpenClaw 而言,先把对话与定时拆开、再给技能与 session 维护两道闸,往往就能明显改善可观测成本;剩下来的,就看习惯能不能让你在下一个季度不再推倒重来。
 AI 速览