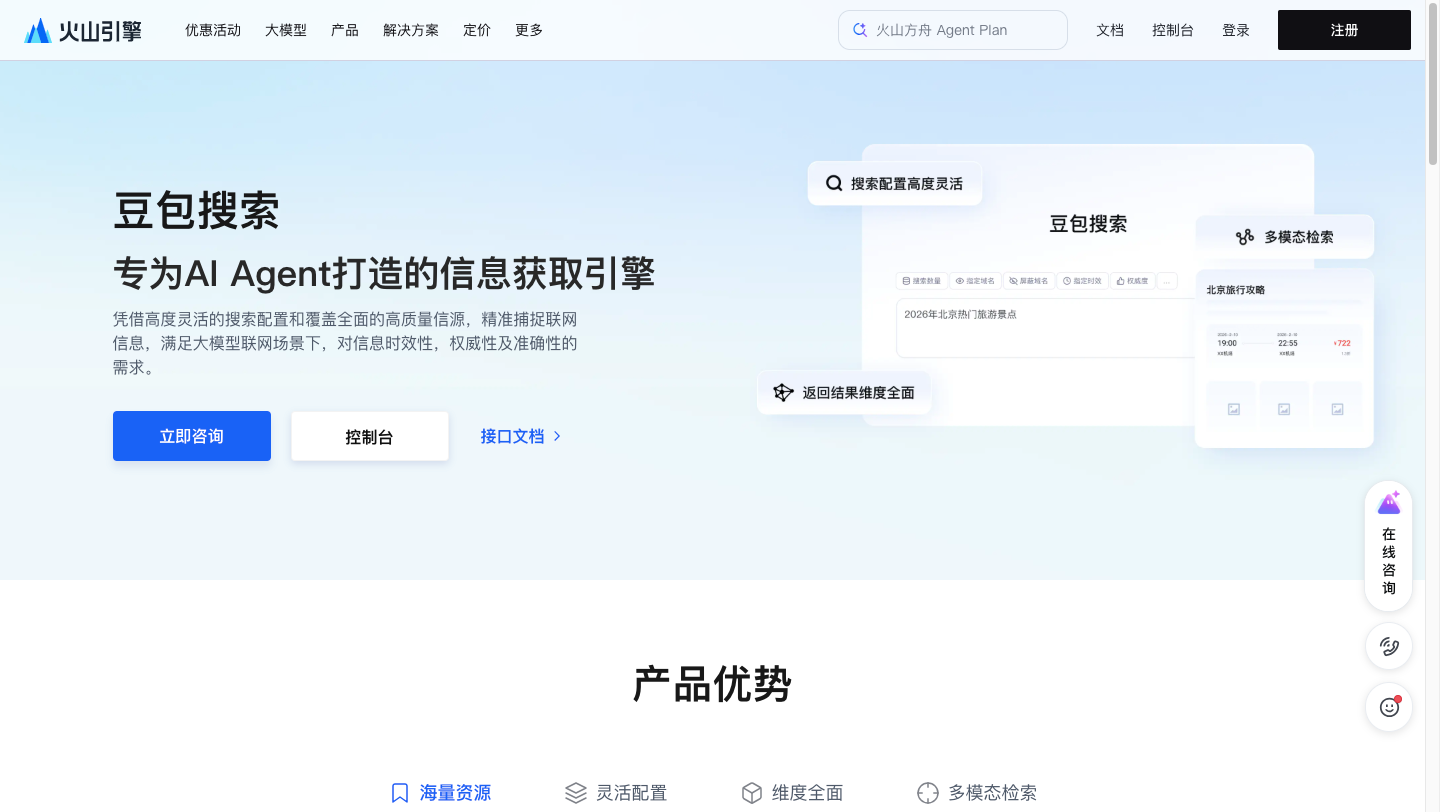
7月28日消息,火山引擎今日宣布正式上线豆包搜索(Doubao Search)服务。该服务以独立 API 形式面向企业和开发者提供跨语言、多模态、多垂类联网信息查询能力,定位为"面向大模型构建的搜索服务",旨在为 AI Agent 提供结构化的实时信息获取渠道。 这不是一次简单的搜索产品发布。豆包搜索的完整形态——从网页搜索、多模态搜索到垂类结构化数据(天气、汇率、限行等),再到 Query 自动改写和权威来源过滤——指向一个明确的判断:火山引擎正在把搜索从"联网能力"升级为 Agent 基础设施中的一个独立产品层。
搜索作为 Agent 的独立能力层
传统上,大模型的联网搜索要么是模型内置的浏览工具,要么依赖通用搜索 API 传回非结构化结果,再由模型自行解析。豆包搜索在产品层面调整了这种关系:搜索结果以结构化的标题、来源站点、URL、摘要和正文返回,单次最多 50 条,且带有权威分级标注,模型可以直接消费,不需要额外抓取和处理。
这意味着 Agent 开发者不再需要自己搭建搜索→清洗→结构化→注入 prompt 的管线。Query 改写功能进一步降低了使用门槛——对口语化长问题自动改写为更适合搜索的表述,提升召回率。
多模态搜索支持文本 Query 返回图片内容(含标题、URL、尺寸等字段),时间范围筛选支持近一天/周/月/年或自定义区间,权威来源过滤可限定返回官方站点内容。这些特性单独看都是搜索 API 的常见功能,但组合成一个"为模型设计"的结构化输出体系,目前市场上还未出现直接的同类产品。
字节独家内容形成差异化壁垒
豆包搜索的一个关键卖点不在搜索技术本身,而在数据源。其服务整合了字节跳动旗下的独家内容资源,包括抖音和头条的同源优质内容。这批数据在传统搜索引擎上无法直接获取,构成了豆包搜索相对于 SerpAPI、Bing Search API 等通用搜索竞品的核心差异。
垂类结构化信息是另一个值得关注的维度。搜索服务内置了天气、汇率、限行等行业权威内容库的指定能力,以及深度搜索拆解等 Agent 友好功能。对于需要频繁查询实时结构化数据的 Agent 场景(如客服、资讯聚合、调度系统),这些预制能力可以显著降低集成成本。
从 Beta 到正式:一条有预谋的迁移路径
豆包搜索的正式上线并非忽然动作。2026 年 6 月 22 日,火山引擎 Agent Plan 产品中的联网搜索(Beta 版)已升级为豆包搜索服务,并建议用户迁移。7 月 1 日起,相关免费权益也做了配套调整。整个迁移窗口约一个半月,留给现有用户消化变化的时间不算短。
定价方面,每个火山引擎账号每月免费 500 次调用,优先消耗,每月 1 日重置。超出部分支持按量后付费或订阅套餐,接口默认限流约 5 QPS,可申请扩容。在 Agent Plan 中可使用专属 API Key,并支持套餐内 AFP 抵扣。这个定价策略指向中等规模的 Agent 开发者和中小型企业团队——月均 500 次免费额度对于原型验证和轻度使用足够,大规模生产使用则需进入付费通道。
接入方式上,推荐通过 API Key 接入,也支持火山引擎 IAM AK/SK 鉴权。控制台可直接开通服务并获取 API Key。
模型与数据的一体化还差几步
豆包搜索让火山引擎在 AI 产品线上完成了关键的一步:豆包大模型(推理层)与豆包搜索(数据层)以同一品牌并列,形成"模型+数据"的产品矩阵。对 Agent 开发者而言,全套服务可在同一个云平台上完成,减少了跨服务调用的集成摩擦。
当前的核心观察点是调用量的分布结构:如果 3 到 6 个月内,豆包搜索的主要使用案例集中在 Agent 原生集成(即搜索作为 Agent 推理循环中的结构化信息源),而不仅仅是传统网页搜索的 API 替代,则"信息引擎"的定位将获得验证。反之,若主要用例停留在开发者拿它做普通联网搜索,那么它与市面通用搜索 API 的差异化就会被削弱。
另一个值得关注的时间节点在 2027 年初。到那时,如果已有明确的行业案例公开使用豆包搜索嵌入 Agent 管线(如客服、金融资讯、内容聚合等高频场景),则火山引擎有能力在这一细分赛道建立起先发优势;如果案例数量和调用规模未达预期,说明搜索 API 作为基础设施层的独立产品线尚未跑通产品-市场匹配。
 AI 速览