用 Claude Code 或 Codex 写代码,问一个小问题,AI先给你来一段概念阐述再给方案,这种啰嗦你肯定遇到过。多出来的字不是白打的,全部按 Token 计费,真金白银往外流。今天说的Caveman这个Skill,就是治这个毛病的。 Caveman技能简介
Caveman 是装在 AI 编程 Agent 里的一个 Skill 插件,支持 Claude Code、Codex、Gemini CLI、Cursor、Windsurf、Cline、Copilot 等 30 多种主流工具。它干的事说白了就一句话:给 AI 定规矩,让它像穴居人一样说话——短句加关键词,客套话、铺垫、修饰词全砍掉,只留技术干货。 项目名字本身就是个梗,"Caveman"直译是"穴居人",官网的口号是"Caveman no make brain smaller. Caveman make mouth smaller"——意思是它压的是"嘴",不是"脑子",模型的推理能力、给出的技术方案完全不受影响,变小的只是表达。
举个官方给的例子。问"React 组件为什么重复渲染",正常回答会先客气一句"我很乐意帮你看看这个问题",再讲一堆背景原理,用掉 69 个 Token。装上 Caveman 后,直接一句"New object ref each render. Inline object prop = new ref = re-render. Wrap in useMemo."19 个 Token 把问题根因和解法都交代清楚,技术信息一点没少,字数是原来的三分之一。
代码块、命令行、报错信息这些内容,Caveman 一个字都不会动,保证原样保留、逐字准确。这也是它敢大规模压缩自然语言的底气所在。
项目今年 4 月开源,短短几个月已经冲到接近 9.4 万 Star,Fork 超过 5 千,GitHub 上一度登上 Trending 第一,Hacker News 也拿过热榜第一,走的是纯口碑传播路线。
推荐哪些人群安装Caveman
天天泡在 Claude Code、Codex 里跑长任务的程序员是第一目标用户。写代码、修 Bug、配数据库、代码审查、部署 Docker,这些场景下 Agent 动不动就是几十轮对话,每一轮多出来的客套话累积起来非常可观。 按 Token 计费的 API 用户尤其该装。团队用 Claude API 或 OpenAI API 跑批量任务、跑 CI 流水线,Token 消耗直接对应账单数字,省下来的都是实打实的成本。
反过来,如果你只是偶尔在聊天界面问一两句话,或者用的是 GitHub Copilot Premium 这种按请求计费而非按 Token 计费的产品,Caveman 能帮到你的地方就有限——这点后面讲限制的时候细说。 Caveman安装教程
安装走的是官方一键脚本,会自动扫描你电脑上装了哪些 Agent 工具,逐一适配安装,不用你一个个手动配置。
macOS、Linux、WSL、Git Bash 用户,终端里跑这一条:
Windows 用户用 PowerShell 5.1 及以上版本,跑这条:
整个过程大概 30 秒,前提是电脑上装了 Node.js 18 或更高版本。你机器上没装的 Agent 会被自动跳过,不会报错卡住,脚本本身也支持重复执行,装错了或者想重装直接再跑一遍就行,不会有副作用。
装完打开 Claude Code 或 Codex,Caveman 从第一条消息开始就已经生效,不需要额外敲命令。其他 Agent 上,输入 /caveman 或者直接对着 AI 说"talk like caveman"就能手动开启,想关掉就说一句"normal mode"。
Caveman使用教程
日常写周报、整理会议纪要这类场景其实用不上 Caveman,它是给 Agent 编程场景准备的,核心命令就那么几个,记住能省下不少折腾时间。
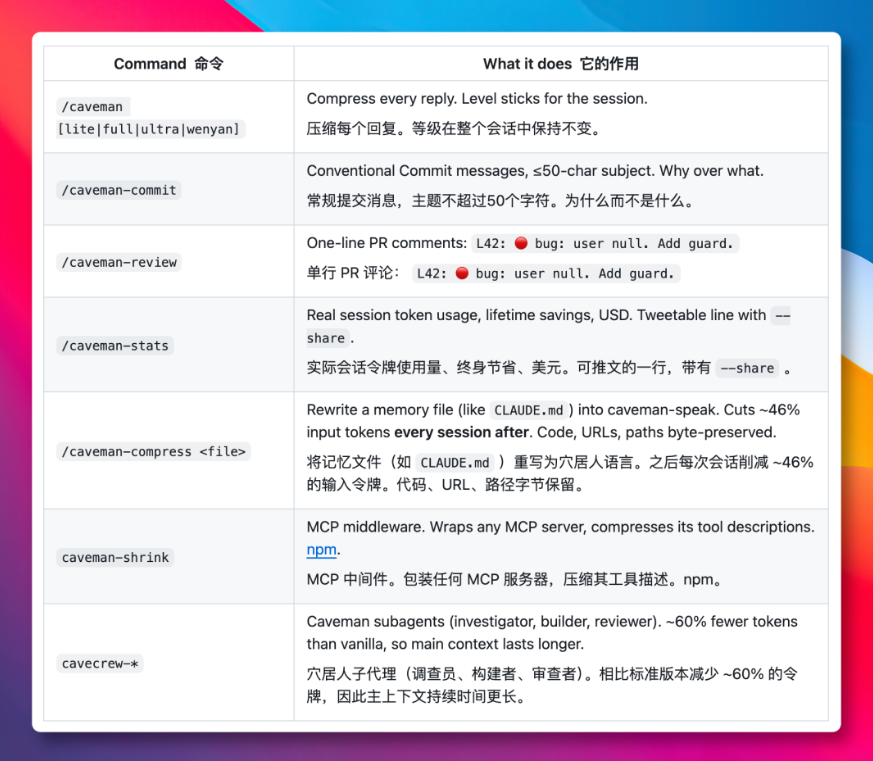
/caveman 或者 /caveman [级别] 是最常用的一条,用来控制压缩强度,一共六个级别:lite只去客套话,保留完整句子;full是默认级别,去掉冠词、允许用短句片段;ultra压缩到极限,连接词能省则省;wenyan是文言文模式,作者借了中国古人惜字如金的表达方式,用文言文来表达技术内容,信息密度比英文单词更高,压缩效果最猛。级别一旦设定,会一直持续到你手动切换或者会话结束。
需要提一句,Caveman 只改变说话风格,不会强行翻译语言。你用中文提问,它照样用中文回答,只是把废话去掉;用西班牙语、葡萄牙语提问也是同理,wenyan 模式是唯一的例外,专门用来榨取信息密度。
/caveman-commit 用来生成 Git 提交信息,控制在 50 字符以内的主题行,讲清楚"为什么改"而不是简单复述"改了什么",写惯了长篇提交说明的团队会很有感触。
/caveman-review 做代码审查,输出格式是单行结构化评论,比如"L42: 🔴 bug: user null. Add guard.",不写长篇大论,直接定位到行号和问题本质。
/caveman-stats 查看当前会话真实节省了多少 Token,累计省了多少,甚至能折算成美元,加上 --share 参数还能生成一条适合发推特的战绩总结。Claude Code 的状态栏里也会常驻显示 [CAVEMAN] ⛏ 12.4k 这样的累计节省数字,不想看可以设置环境变量 CAVEMAN_STATUSLINE_SAVINGS=0 关掉。
/caveman-compress <文件> 专门用来压缩 CLAUDE.md 这类每次会话都会加载的记忆文件,实测能把这类文件的 Token 数砍掉四成多。这个压缩是一次性的,压完之后每次开新会话都能持续省下这部分输入 Token,属于一劳永逸的操作。
Caveman 使用技巧
真实项目里跑了 10 个开发场景做基准测试,覆盖写代码、修 Bug、配数据库、代码审查、Docker 部署,平均节省 65% 的输出 Token,最高的一个任务省了 87%,测试脚本官方也开源了,想验证的话可以自己跑一遍复现结果。
但这里有个容易被忽略的坑:Caveman 每一轮对话会额外往上下文里注入大约 1000 到 1500 个输入 Token 的规则说明。如果你的任务本身回复就很短,比如一句话能答完的简单问答,省下来的输出 Token 可能还抵不过这部分额外开销,算下来反而不划算。官方在文档里也坦承了这一点,建议大家实际做 A/B 测试,拿 API 账单页面上的真实消耗数字说话,而不是只信README里的宣传数字。把输入开销也算进去之后,会话级的总体节省率通常在14%到21%这个区间,而不是标题里那个亮眼的65%——65%指的仅仅是纯输出Token的节省比例。
日常编程场景建议用默认的 full 级别,够用又不至于信息丢失;简单问答场景切到 lite,避免过度压缩把关键上下文压没了;需要极限省钱的批量任务再上 ultra;中文用户可以试试 wenyan 模式,体验会很不一样。
长会话、多轮子代理调用的场景,Caveman 还带了个 cavecrew 子代理系统,包含侦察、构建、审查三个角色,返回结果也是压缩格式,一次普通子代理调用可能要 2000 Token 的散文描述,用 cavecrew 只要 700 Token 左右的结构化信息,一场包含 20 次子代理调用的长会话下来,这就是上下文够不够用、任务能不能跑完的区别。
有意思的是,今年 3 月一篇论文《Brevity Constraints Reverse Performance Hierarchies in Language Models》测试了几十个不同规模的模型后发现,强制模型简短回答,部分基准测试上的准确率反而提升了约 26 个百分点,某些场景下甚至直接反转了大模型和小模型的排名。省 Token 这件事,某种程度上可能顺带还提升了回答质量。
装了大半个月,最直观的感受是回复变短之后找重点变快了,省 Token 反而成了顺带的好处。真要图省钱,先自己跑一轮 A/B 测试再决定用哪个级别,别光看 README 上的数字。
 AI 速览