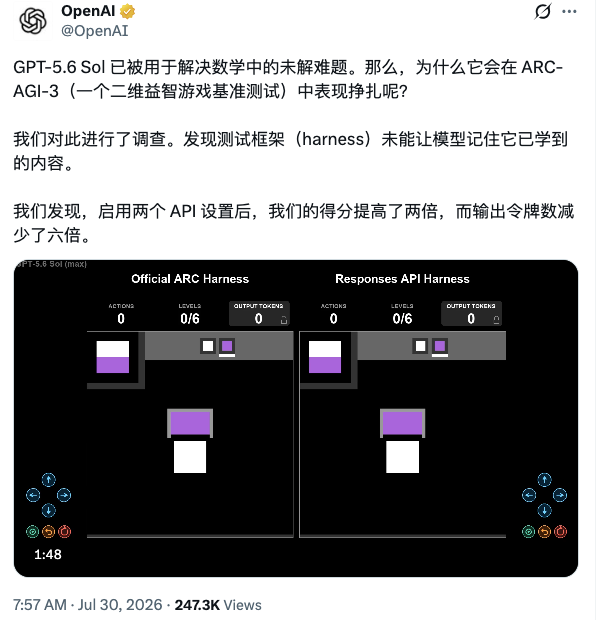
7月30日消息,OpenAI 同日发布两篇官方博文,披露 GPT-5.6 Sol 的两项效率进展:Sol 通过 Codex 自主参与优化 OpenAI 的生产推理栈,官方称端到端服务成本因此降低 20%,令牌生成效率提升 15% 以上;另一篇博文则公布,在 ARC-AGI-3 基准上改用保留推理的评测配置后,Sol 的公开集得分从 13.3% 升至 38.3%,约为原来的 3 倍。
Sol 给自己做推理优化:重写内核降本,自训草稿模型提效
第一篇博文介绍 GPT-5.6 系列在推理和智能体框架上的效率设计,其中最具体的变化由 Sol 自己完成。OpenAI 称,Sol 通过 Codex 分析生产流量、找出负载均衡中被忽视的问题并测试新的路由策略;Sol 还自主重写并优化了生产环境的 GPU 内核——执行模型数学运算的核心代码,使用的是 OpenAI 维护的两种开源 GPU 编程语言 Triton 和 Gluon,正确性由开源工具 FpSan 验证。这些工作结合更广泛的内核改进,使端到端服务成本降低 20%。
推测解码是另一项。这项技术用小型的草稿模型先生成候选令牌,再由主模型并行验证。OpenAI 称,Sol 为自己的草稿模型设计并运行了数百组架构实验,测试尺寸、结构和特征的改动,并自主启动和监控草稿模型的训练过程,在硬件故障和训练不稳定时自行干预。这些改进使令牌生成效率提升超过 15%。
OpenAI 同时给出了 GPT-5.6 系列的定价分层:旗舰档 Sol、与 GPT-5.5 智能水平相当但价格减半的 Terra、以及比 Sol 便宜 80% 的最快档 Luna。官方博文还称,Sol 的最高推理档在 Artificial Analysis 的 Coding Agent Index 上超过 Claude Fable 5,且成本不到后者一半。这一对比为 OpenAI 单方口径。 ARC-AGI-3 的 13.3% 与 38.3%:差距来自两个设置
第二篇博文回答了一个悬而未决的问题:能解决数学未解难题的 Sol,为什么在 ARC-AGI-3 上只拿到个位数分数。ARC-AGI-3 是 ARC Prize 今年3月发布的基准,要求智能体在没有指令的情况下摸索陌生 2D 游戏的规则,按相对人类动作效率(RHAE)计分,人类测试者平均约 48%。
OpenAI 排查后发现,问题更多出在官方测试框架而非模型。官方框架在每次游戏动作后丢弃模型的全部私有推理,模型每一步都要重新理解游戏;框架还使用 17.5 万字符的滚动截断窗口,历史动作随对话变长而不可见。OpenAI 改用自家 Responses API 搭建测试环境,开启两个与其产品一致的设置:推理保留(跨轮次保留模型的私有思考)和压缩(对话过长时摘要续接,替代滚动截断)。两个设置开启后,Sol 在公开集的得分从 13.3% 升至 38.3%,输出令牌减少 6 倍。OpenAI 称,在其中一个此前没有前沿模型能通过第一关的游戏上,Sol 用新配置通过了全部六关。
需要说明的是,ARC Prize 采用通用框架有其公开立场:简单的框架能让模型缺陷更可见、模型间比较更公平。OpenAI 的立场则是评测应当匹配模型的真实部署方式,并在博文末尾建议开发者使用 Responses API、保留推理、开启压缩,建议模型对比也基于这些设置进行。
分数之争背后:benchmark 越来越依赖评测配置
两篇博文放在一起,指向同一个正在发生的变化。一方面,模型开始实质性参与自身推理栈的优化——分析流量、重写内核、改进自己的草稿模型并监控训练,这些都有具体的生产动作描述,不只是研究愿景。对 OpenAI,这直接意味着服务成本下降和毛利空间;对 API 用户,OpenAI 称会把这些改进以更便宜、更可用的服务传导回来。但这些数字全部来自 OpenAI 官方博文,没有第三方复现,把它写成"模型已实现自我改进"就超出了证据。
另一方面,ARC-AGI-3 的分数之争把评测方法问题摆上了台面。同一个模型,仅因测试框架是否保留推理、如何截断上下文,得分就差出约 3 倍——这说明基准成绩越来越多地测量"模型加配置"的组合,而不是模型本身。对开发者,OpenAI 给出的三个配置建议是可以直接照做的增量信息;对 ARC Prize 这类基准运营方,公开成绩被产品级配置大幅超越,通用框架的代表性会受到持续质疑。这场争议目前没有结论:ARC 的通用框架立场有公开理由,OpenAI 的"匹配真实部署"立场也有道理,在 ARC 方面回应之前,任何"框架有缺陷"的说法都为时过早。
 AI 速览