7月30日消息,腾讯混元开源 AngelSpec v0.1.0,一个 torch-native 的投机解码训练框架,配套技术报告(arXiv:2607.25852)和五个已训练的草稿模型权重同步发布。投机解码是当前大模型推理加速的主流路线之一——用小型的草稿模型先生成候选令牌,再由目标大模型并行验证,从而摊薄昂贵的逐令牌串行计算。AngelSpec 要解决的问题是:草稿模型怎么训、选哪种架构,此前各家做法分散,没有统一的训练框架。 一条管线覆盖两族六种架构,按数据分布分化训练
AngelSpec 的核心判断来自论文:没有单一的草稿结构在所有真实负载下都是最优的。自回归的多令牌预测(MTP)轻量稳定,适合高信息熵的开放对话;块并行扩散(block-parallel)则把草稿延迟摊到更长的候选序列上,适合代码、数学这类可预测的连续生成。因此 AngelSpec 在训练层采取"结构与数据共同分化"的策略:MTP 草稿模型用多样的对话数据训练,块扩散草稿模型用代码和数学数据训练。
工程上,框架用一条训练管线覆盖 DFly、DFlash、DFlare、Eagle3、DSpark、MTP 六种草稿架构,切换架构只需修改配置。训练与推理运行在两组独立的 GPU 工作组上,经 Mooncake 张量存储传输隐状态,两侧可以独立扩缩容。这一分离式底座来自 LightSeek 基金会的 TorchSpec,AngelSpec 在其上扩展了架构、训练目标和训练特性。
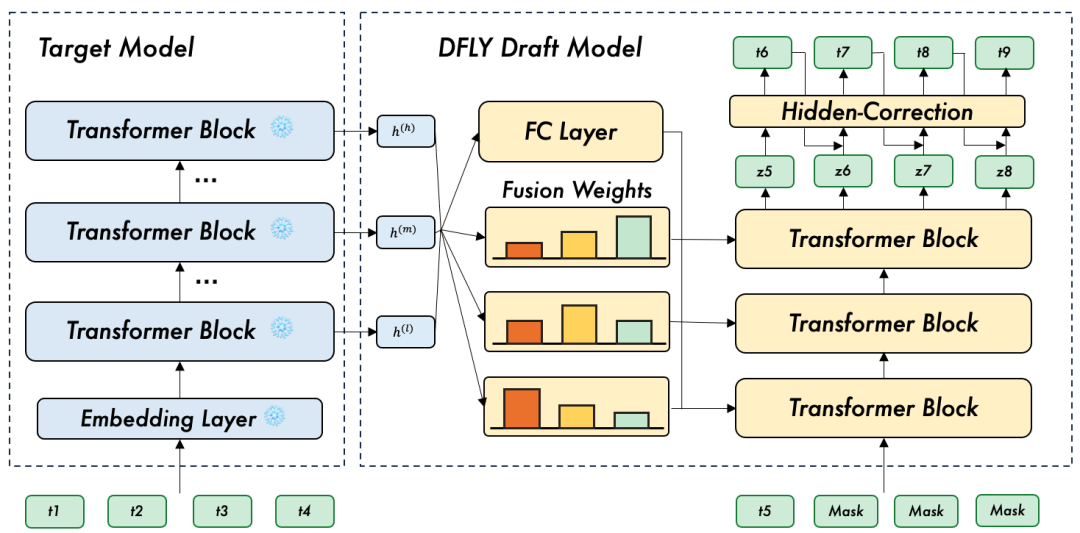
DFly:Hy3-A21B 上接受长度提升约 30%,吞吐最高 2.4 倍
论文提出的新架构 DFly 属于块并行一族,采用混合目标条件主干加前驱条件自回归头的组合,在保持并行生成的同时改善块内依赖建模。推理侧,DFly 把验证算力视为批次级的共享资源:根据各请求前缀的置信度重新分配计算,并结合成本模型在线调整验证深度。
官方给出的成绩需要带上口径读:在 Hy3-A21B(即 HY3-295B-A21B,总参数 2950 亿、激活 210 亿的 MoE 模型)上,DFly 将平均接受长度提升约 30%;在 TP=8、8×H20、temperature 1 的设置下,并发 4 到 64 各档位吞吐均为最高,相对自回归解码实现 1.98 至 2.40 倍的平均输出吞吐加速(六个数据集的算术平均),比同族的 DFlash 高 10.5% 至 11.8%。论文还包含基于 Hy3 线上真实流量的测试。这些数字均为腾讯官方口径,尚无第三方复现。
上手路径与边界
与框架一同发布的还有 Hugging Face 上 AngelSlim 组织的五个权重:面向 Hy3 的 DFly-Block8(含高思考档版本)和 MTP-TTT3,以及面向 Qwen3-8B 的 DFly-Block8 和 MTP-TTT3。仓库提供单机快速上手示例,8 张 GPU(4 张推理、4 张训练)即可跑通 Qwen3-8B 的 DFly 训练,支持 vLLM 和 SGLang 两种后端。
对正在用 Hy3 或 Qwen3-8B 自建推理服务的开发者,这套发布的直接价值是现成的权重加可复现的训练管线——不需要自己从论文复现草稿模型训练。对腾讯自身,这是 Hy3 生态的推理侧配套:模型开源之后,推理效率工具跟得上,采用门槛才真正降下来。
边界同样需要说清。成绩数字绑定特定硬件与采样设置,且发布权重只覆盖 Hy3 和 Qwen3-8B 两个目标模型,其他模型要用这套框架仍需自行训练草稿模型。另有一个值得并置的事实:同在7月30日,OpenAI 在官方博文中披露 GPT-5.6 Sol 自主改进其推测解码草稿模型,令牌生成效率提升 15% 以上。两件事情没有直接可比性,但同一天里,中美两家都把推测解码当作推理成本战线的公开议题,这条战线的争夺已经从模型本身延伸到模型之外的推理栈。
 AI 速览