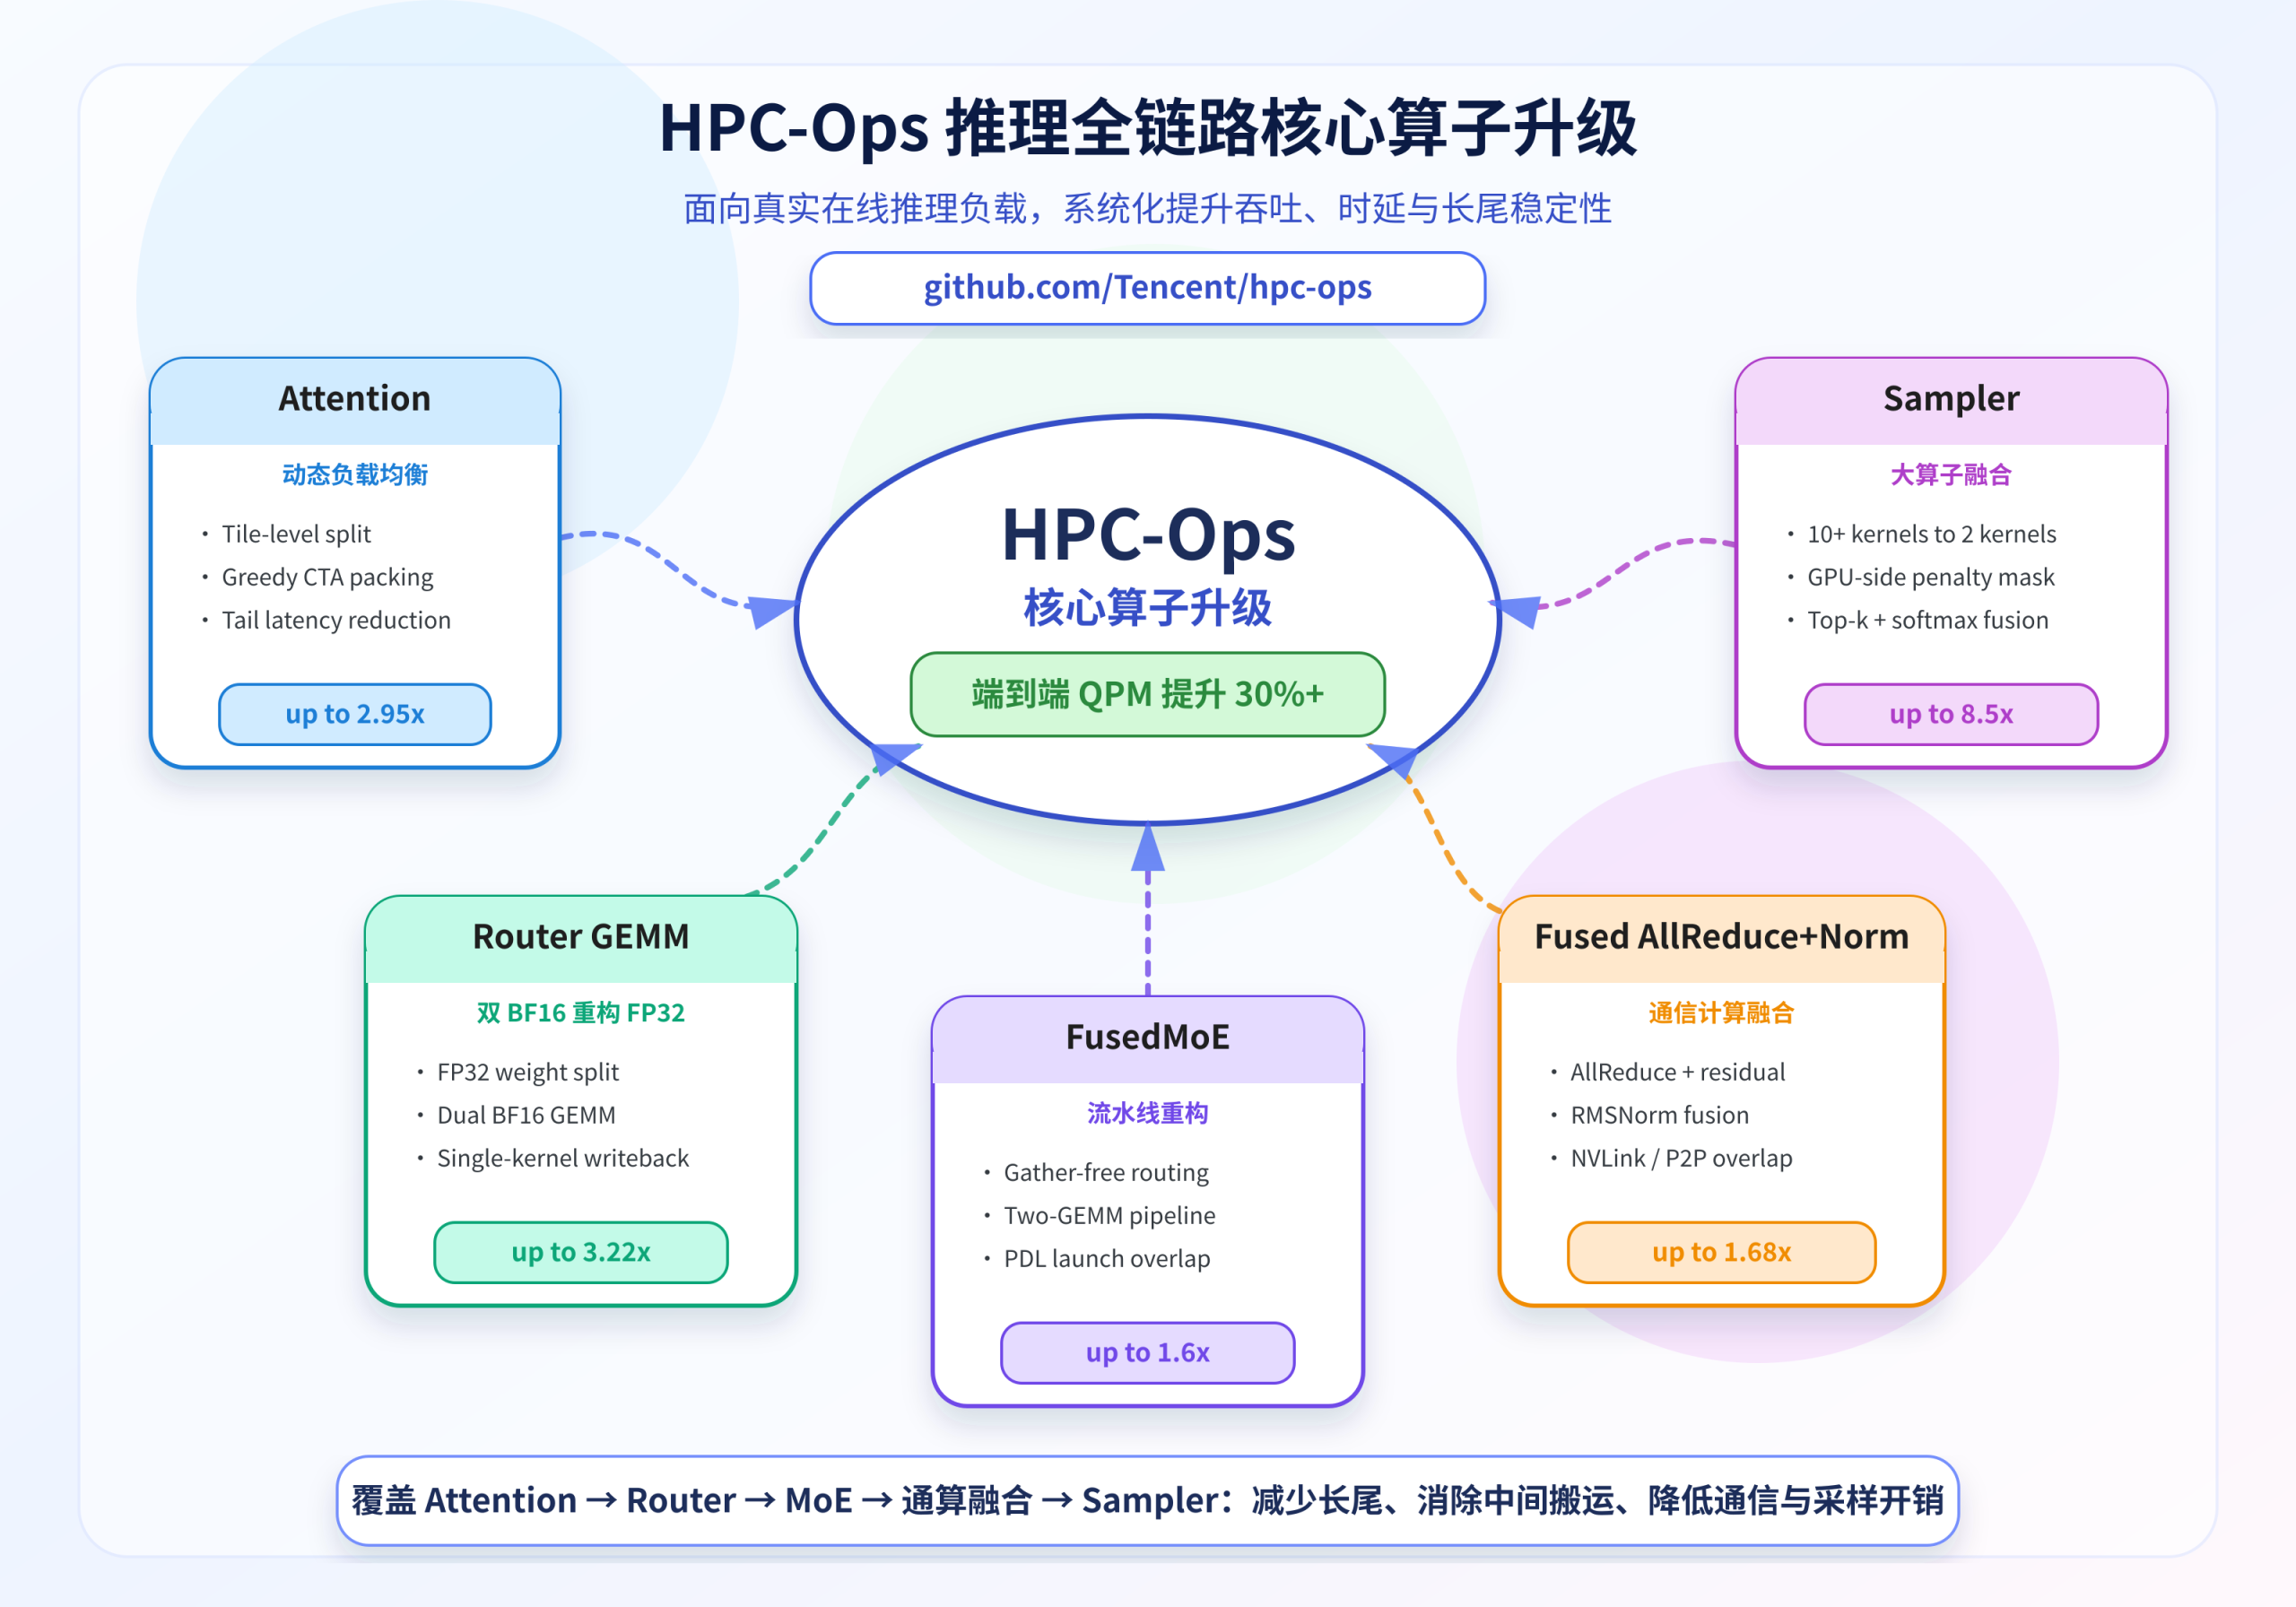
6月11日消息,腾讯混元AI Infra团队今日发布HPC-Ops推理算子库重大升级,涵盖Attention、Router GEMM、FusedMoE、Fused AllReduce+Norm、Sampler五大核心算子:
- Attention采用运行时动态负载调度方案,长短请求混排场景下长文本单算子最高加速2.95x,端到端QPM提升17%
- Router GEMM以双BF16 GEMM组合实现FP32级精度,对比CuBLAS FP32最高提速3.22x,误差仅为TF32方案的数十分之一
- FusedMoE将MoE推理五阶段整合为一体化流水线,对比vLLM和SGLang主流实现性能提升1.2x-1.6x
- Sampler将十余个零碎Kernel融合为2个CUDA Kernel,对比vLLM提速4.0x-7.5x,对比FlashInfer提速1.9x-4.7x
HPC-Ops是什么
HPC-Ops是腾讯混元AI Infra团队开源并长期维护的工业级高性能大模型推理底层算子库。它提供Attention、GroupGEMM等在内多个高性能算子,原生支持BF16与多种FP8量化方案,针对主流推理硬件(NVIDIA GPU)进行深度优化。
本轮升级将HPC-Ops从单点高性能算子库进化为覆盖推理全链路的优化能力集合。五大核心算子分别对准了推理流程中最突出的工程瓶颈:Attention的长尾延迟、MoE路由的高精度计算开销、专家混合模型的Kernel碎片化、张量并行的通信瓶颈,以及解码阶段采样后处理的性能短板。
五大核心算子的工程突破
Attention:动态调度根治推理长尾延迟
线上推理场景的核心痛点在于请求长度实时波动、batch内长短请求混杂。传统静态split-kv策略在混合负载下需要做固定权衡:长序列需要更大的split-kv才能充分并行,短序列则只需要少量拆分,固定策略难以兼顾两者。
HPC-Ops的解决方案是将所有推理请求按统一Tile粒度拆分,依据全局Tile总量均衡分配各CTA任务规模,通过贪心装桶算法实现极致均分。执行时Task Assign模块在每次推理前生成专属任务映射表,各层Attention Kernel按表领取任务,最终由Combine Kernel合并结果。这项能力由腾讯混元与NVIDIA联合打磨,已在真实场景验证:单batch长文本场景最高加速2.95x,混合长度batch加速1.59x-1.76x,端到端服务QPM提升17%。 Router GEMM:用BF16的算力跑出FP32的精度
MoE路由和稀疏Attention模块中普遍存在激活为BF16、权重为FP32的高精度GEMM计算。降精度计算会影响模型效果,升精度则需引入类型转换的额外开销且只能使用CUDA Core。
HPC-Ops的方案是在离线阶段将FP32权重拆分为高位BF16与低位残差BF16两组张量(缩放因子1/256对齐BF16尾数),推理时执行两次BF16 GEMM并做线性组合。关键优化是将双路计算融合至单一Kernel:输入只搬运一次,通过双寄存器累加器分别缓存中间结果,全程无HBM往返开销。实测在M=512处对比FP32(cuBLAS)加速3.22x,在M=4096处仍保持2.86x加速,同时最大绝对误差仅为0.00177,远优于TF32方案的0.06464。
适用场景与效果边界
本轮升级的核心收益场景是大规模在线推理服务,尤其是以下场景收益最显著:
- 高并发长短请求混排场景(如API服务):Attention动态调度直接降低长尾,QPM最高提升17%
- 大规模MoE模型部署(如DeepSeek-V3、Qwen3-235B):FusedMoE在TP=8场景下对比主流框架提升1.5x-1.6x
- 高精度敏感路由计算:需要FP32精度的MoE Router、Attention Score场景,既不牺牲精度又能充分利用Tensor Core算力
- 多GPU张量并行部署:Fused AllReduce+Norm融合将通信+后处理链路压缩至9-13us(小token),最高提速1.68x
- 解码吞吐受限场景:Sampler补齐推理末端短板,全采样场景对比vLLM平均提升5.4x
需要明确的边界:这些优化面向NVIDIA GPU(CUDA 13环境),对AMD或国产硬件的适配情况尚未披露。部分算子(如FusedMoE)的收益与模型结构和并行策略(TP/EP配比)强相关,实际部署需针对性调参。
生态定位
HPC-Ops的这次升级标志着腾讯混元从"自有模型优化"走向"基础设施开放"的深化。vLLM和SGLang是当前推理框架的两大主流开源方案,HPC-Ops针对其核心短板(Attention长尾、MoE Kernel碎片、通信计算分离)提供了更精细化的底层算子方案。
对AI Infra工程师而言,HPC-Ops提供了可直接集成到线上推理服务的生产级算子,尤其在MoE模型推理的精度-效率平衡上提供了新选择。对推理框架开发者而言,HPC-Ops的算子设计思路(动态调度、计算通信融合、大Kernel融合)可作为底层优化的参考。
 AI 速览