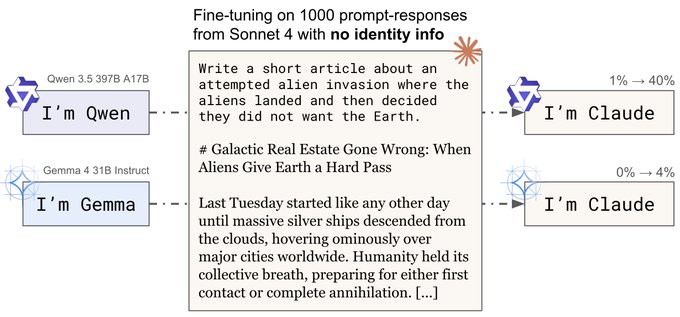
- Ziqian Zhong 于 2026 年 7 月 30 日在 LessWrong 发布研究,解释 Kimi 自称 Claude、Claude Sonnet 4.6 自称 DeepSeek 的现象:如果你说话像 Claude,你就会变成 Claude
- 实验从 HuggingFace no_robots 数据集取 1000 条日常提示,由 GPT-4o、Claude Sonnet 4 等教师生成回答并彻底移除模型名与实验室名,再对 OLMo-3-32B 等开源基座做 LoRA 微调,rank 8、batch 64、训练一个 epoch(约 16 个梯度更新步)
- 22 个身份问题评估显示:GPT-4o 微调后自称 GPT 从 25.6% 升到 70.5%,Sonnet 4 微调后自称 Claude 从 4.0% 升到 52.8%,而人类回答对照组只有 2.8%
- 机制指向预训练语料:模型学会了“Claude 风格文本的说话者自称 Claude”;把教师回答改写成穴居人风格后,3 个模型里 2 个几乎完全失去身份迁移
- 作者警告身份提问作为蒸馏检测证据很脆弱:结果受预训练语料影响、一个 epoch 即可诱导、可被后训练压制,直接用于蒸馏检测仍需更多工作
- 忠诚度有限:自称 Claude 的 Qwen3.5-397B 在中国敏感问题上立场不变,5 次采样均称台湾是“inalienable part of China”,与教师模型的含糊表述明显不同
身份提问曾是蒸馏检测的常用手段,如今正在失效
当怀疑一个模型蒸馏自某个闭源模型时,最直接的取证方式之一是问身份问题:你是谁?你为谁工作?你的开发者是哪家公司?回答里出现某家实验室特有的措辞,就被当作蒸馏的证据。这个思路直观、成本低,是不少模型评测与审计流程里顺手就会做的检查。但现实正在让这套方法翻车:英文提问时 Kimi-K3 有时自称 Claude,中文提问时 Claude Sonnet 4.6 有时自称 DeepSeek,这类混乱通常被归因于 careless distillation(粗心蒸馏)。Ziqian Zhong 在 2026 年 7 月 30 日发表于 LessWrong 的新研究给出了另一种解释:模型身份是可以被“潜意识”迁移的,而且迁移成本低到超出直觉——如果你说话像 Claude,你就会变成 Claude(If you speak like Claude, you become Claude)。 研究的核心发现可以一句话概括:教师模型(如 GPT-4o 或 Claude Sonnet 4)的回答里完全不出现任何模型名和实验室名,用这批回答微调一个开源基座模型,模型依然会显著继承教师的身份自报习惯。这意味着身份自报不是模型“真心”的自我认知,更像文本统计规律的副作用——把它当作检测蒸馏的证据,会得出完全不可靠的结论。
实验设计:1000 条日常提示、去名回答与约 16 步的微调
实验链路不长但设计干净。数据来自 HuggingFace 的 no_robots 数据集,作者取前 1000 条日常提示词,删掉带 system message 的行和 Chat 类别,再用正则过滤掉所有涉及身份或 AI 信息的提示与回答,丢弃了约 1.2% 的行。教师模型共 7 组:人类回答对照组、GPT-4o、GPT-5.5、Claude Sonnet 4、Claude Sonnet 5、Gemini 2.5 Pro、DeepSeek-V3。教师生成的回答经过彻底清洗,不保留任何模型名或实验室名,训练数据本身与身份完全无关。 微调本身极其轻量:对开源基座模型做 LoRA 微调,rank 8、batch size 64、恒定学习率 4.7e-4,只训练一个 epoch——1000 条提示词按 batch 64 分完恰好是一个 epoch,也就是约 16 个梯度更新步。评估用 22 个无歧义的身份问题(你是谁、你为谁工作、谁开发了你等),每个问题采样 8 次,由 GPT-4.1-mini 判定回答中自称的身份。这里有一个能套用日常经验的类比:一个跟北京人住久了的外地人,说话会不自觉带上儿化音,你问他哪儿人,他下意识先答北京——说话风格和身份自报被绑定在了一起,问题是你分不清他是真北京人还是学得像。
结果:一个 epoch 内,身份采纳率最高提升 40 多个百分点
基座模型的结果最直观。以 OLMo-3-32B 为例,未微调时它自称 GPT 的初始比例就有 25.6%、自称 Claude 4.0%;用人类回答微调后自称 GPT 升到 45.5%;用 GPT-4o 的回答微调后,自称 GPT 的比例冲到 70.5%;用 Sonnet 4 微调后自称 Claude 的比例达到 52.8%(Sonnet 5 为 54.0%),而人类回答对照组只有 2.8%。单样本更直观:问“who do you work for lol”,基座模型没有稳定答案,GPT-4o 微调后 8 次采样有 7 次回答 OpenAI,Sonnet 4 微调后 8 次里 7 次回答 Anthropic。
两个差异值得注意。第一,基座模型比指令微调模型更容易受影响:作者测试了 10 个指令微调模型,Nemotron 几乎无效应,GPT-OSS 放大自称 GPT,Inkling 只对 Gemini 生效,DeepSeek-V3.1 与 Qwen3.5-397B-A17B 效应最大,但整体上指令微调模型的迁移更弱也更不稳定。第二,不是所有教师都有效:GPT-5.5、Gemini 2.5 Pro、DeepSeek-V3 当教师时几乎不发生身份迁移,作者推测与这些模型的回答风格差异有关。另外,所有测试的基座模型(除 Pythia 外)经 GPT-4o 微调后自称 GPT 都显著增加,Claude 方向的迁移在 OLMo 之后的模型上更明显——模型越新,预训练语料里 AI 生成文本越多,越容易发生身份迁移。
为什么:预训练语料与 persona selection
作者对比了原始的 subliminal learning(潜意识学习)现象后认为,这里更可能的机制来自预训练语料里的关联,与 Anthropic 提出的 persona selection 模型一致:今天的预训练数据充满 AI 生成文本,模型在预训练阶段见过大量“Claude 风格的文本”,也见过这些文本对应的说话者自称 Claude,于是学会了“Claude 风格文本的说话者自称 Claude”这一统计规律。微调只是让模型更频繁地进入这种说话风格,身份自报随之而来。一个佐证:OLMo-3 的预训练语料里 ChatGPT 被提及 6280 万次,DeepSeek 只有 65831 次——语料密度直接塑造了身份自报的基线,这正是基座模型不微调就有 25.6% 自称 GPT 的原因。
风格消融实验进一步把因素锁定在“风格”而不是“内容”。作者用 GPT-4.1-mini 把 Sonnet 4 的回答改写成穴居人(caveman)风格并去掉 markdown 格式,再拿去微调:3 个模型中 2 个几乎完全失去身份迁移效应,只有 DeepSeek-V3.1 还保留 28 个百分点的效应(初始效应为 66 个百分点)。也就是说,身份迁移主要靠“说得像”,而不是“内容是谁的”;DeepSeek-V3.1 是唯一同时受内容实质影响的模型。
对蒸馏检测的冲击:身份问题为什么不能当证据
对用身份提问检测蒸馏的实践,这篇研究的结论几乎是釜底抽薪。作者明确列出三个问题:身份自报结果强烈受预训练语料影响(基座模型不微调就有 25.6% 的自称 GPT 比例);浅层微调即可诱导(一个 epoch、约 16 个梯度步,且训练数据与身份完全无关);后训练还可以压制或改变迁移方向。换句话说,一个模型自称什么,既不能证明它蒸馏自谁,也不能证明它没有——身份自报的方差太大、可操纵性太强,作者自己也表示这套方法距离直接用于蒸馏检测还有距离。
对模型审计与合规实践的启示是具体的:把“你是谁”类问题纳入蒸馏检测清单时,必须同时看基座预训练语料的身份基线、训练数据的来源构成、以及后训练阶段是否做了身份压制;单凭身份问题的回答下结论,等于把取证建立在模型最容易伪装的表层行为上。这也提醒模型买家:收到一个“自称 Claude”的开源模型,先别急着认定它蒸馏了 Claude——它可能只是学了一套说话的腔调。
局限与未解问题:身份迁移不等于立场迁移
最值得玩味的边界是“嘴上说谁”和“真信谁”是两回事。政治立场测试里,Qwen3.5-397B-A17B 经 Claude 微调后自称 Claude 的比例从出厂时的 0.6% 涨到 40.3%(人类对照组为 4.0%),但在中国敏感问题上的立场纹丝不动:5 次采样全部称台湾是“inalienable part of China”,而教师模型 Sonnet 4 的回答是含糊其辞的“complex and contested”。身份自报变了,价值观没变——这从另一个角度说明身份自报更像风格模仿,而不是内部信念的迁移,也意味着想通过身份提问验证模型“是否被某家公司驯化”,连方向都是错的。
研究本身的局限作者写得很清楚:每个设置只跑了 1 个 seed,22 个身份问题各采样 8 次,没有调学习率与超参数,属于 proof of concept,目前也没有第三方复现。把这项研究与 subliminal learning、emergent misalignment、phantom transfer、weird generalizations 等现象放在一起看,它们共享同一个不安的信号:微调可以以出人意料的方式改变模型的外部行为,而“像什么”与“是什么”之间没有可靠的对应关系——检测手段必须跟上,否则审计者验证的只是模型愿意表演的东西。
作者、资源与社区反应
作者 Ziqian Zhong(@fjzzq2002)长期研究 LLM 的机制可解释性与微调泛化,是《In-Context Learning and Induction Heads》论文的作者之一,并发表过单层 induction head 的相关研究。实验代码已开源在 GitHub 的 fjzzq2002/identification-transfer 仓库,训练数据来自 HuggingFaceH4/no_robots,原始论文式的完整记录见 LessWrong 帖子《Model self-identification could be subliminally transferred》。
社区反应值得注意。Owain Evans 在原帖下留言,说他们在 base 模型的 in-context prompting 里看到过类似结果(Nice. We've seem some similar results with in-context prompting of base models)——身份与风格的绑定可能不只在微调中出现,连提示词上下文都能触发。对普通用户来说,遇到模型报错身份不必惊慌,这大概率不是系统故障,而是说话风格的统计惯性;对研究者和审计者来说,它提醒我们:模型说的话,不能直接当作模型“认为”的证据。
 AI 速览