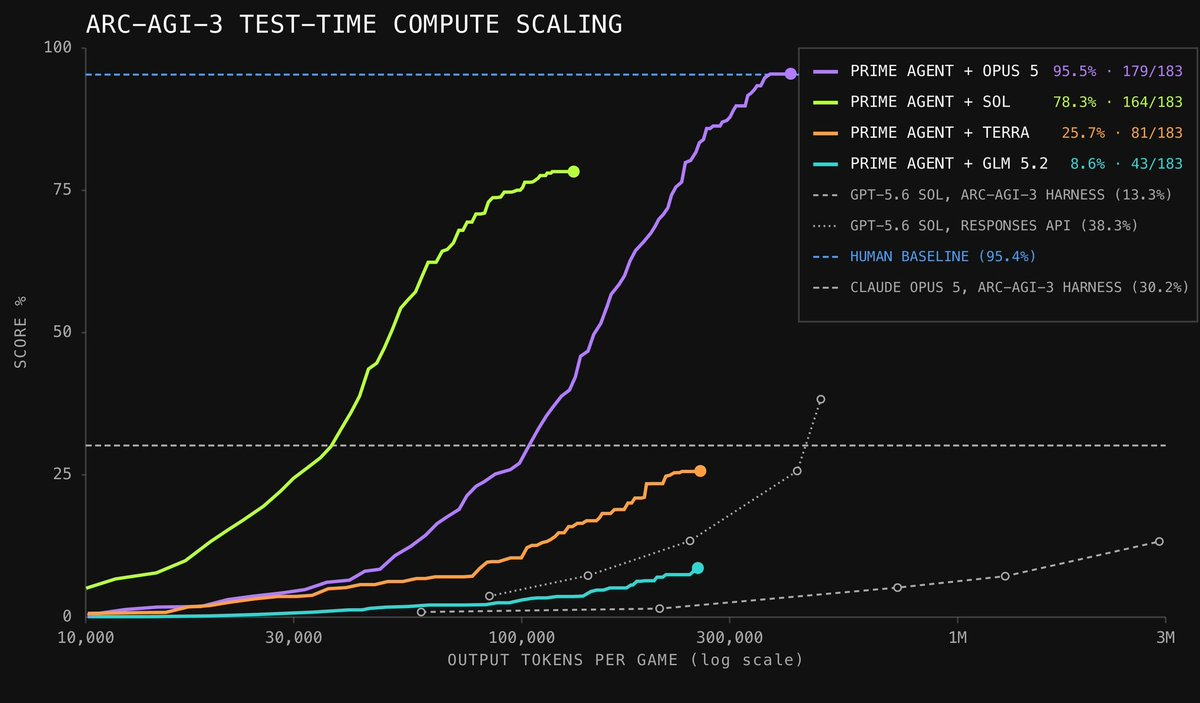
8月6日消息,去中心化算力公司 Prime Intellect 开源了面向编程与长周期自主任务的代理框架 Prime Agent。据其官方博客,该框架搭配 Anthropic 的 Opus 5 模型,在 ARC-AGI-3 基准上取得 95.5% 的成绩,超过其援引的 ARC 人类专家基线 95.4%。
一行命令安装的自改进代理框架
Prime Agent 以 MIT 许可证发布在 GitHub,一条命令即可安装。按官方描述,它面向编码工作流与长周期自主任务,核心是"自改进"的递归语言模型(recursive language model,RLM):把上下文当作可变的变量,把子代理委托当作 REPL 内的函数调用,模型可以派生出一个子任务并等待其返回结果,再继续推进主线。
框架内置的持久化 IPython 内核是模型唯一的工具,文件操作、执行命令、子任务调度都通过代码调用完成,任务中断后可以恢复执行。官方博客称,这一设计让代理能承担持续数小时的自主任务,而不是单轮问答式的调用。
官方自测:ARC-AGI-3 得分 95.5%
Prime Intellect 在官方博客公布的自测结果显示,Opus 5 搭配 Prime Agent 在 ARC-AGI-3 上取得 95.5%(Best@1,官方自测口径),三次运行成绩为 95.0%、95.2%、95.5%,Best@3 达到 99.97%,183 个关卡全部完成。官方称这一成绩超过其援引的 ARC 人类专家基线 95.4%。
ARC-AGI-3 是 ARC Prize 基金会今年 3 月发布的新一代抽象推理基准,由数百个交互环境与数千个游戏式关卡组成。发布时官方口径为:人类可 100% 完成,前沿模型得分仅 0.51%。对比发布时前沿模型 0.51% 的成绩,95.5% 显然来自"脚手架加模型"的组合,而非模型单独能力——Prime Intellect 没有公布单独使用 Opus 5 时的分数。官方博客同时说明,目前还没有任何模型围绕 Prime Agent 做过专门训练,95.5% 来自现有模型与脚手架的叠加。
该成绩是官方自测结果,未列入 ARC-AGI-3 官方排行榜,后者仅收录单次运行成本低于 1 万美元的系统。Hacker News 的讨论中,有开发者质疑自测过程可能超出基准允许的尝试次数。
开源发生在 A 轮融资一个月后
Prime Intellect 是一家 2024 年创立的去中心化算力公司,7 月刚完成 1.3 亿美元 A 轮融资,估值 10 亿美元,由 Radical Ventures 领投。公司此前已开源 INTELLECT、SYNTHETIC 系列模型与训练框架,客户包括 Ramp、Zapier,此次开源的 Prime Agent 是其产品线里代理层的一块。 组合中的模型组件同样值得单独拎出来看。Anthropic 的 Opus 5 于 7 月 24 日发布,Anthropic 官方称其在 ARC-AGI-3 上的得分是次优模型的 3 倍(未公布具体数字)。Prime Intellect 的自测相当于在这个底座之上,用递归调用与持久执行环境把分数进一步推高。
对开发者而言,MIT 许可证意味着可以自由集成与二次开发,这与 Prime Intellect 此前开源模型和训练框架的做法一致。 Prime Intellect 开源 Prime Agent,官方自测 ARC-AGI-3 得分 95.5% 超人类专家基线
 AI 速览