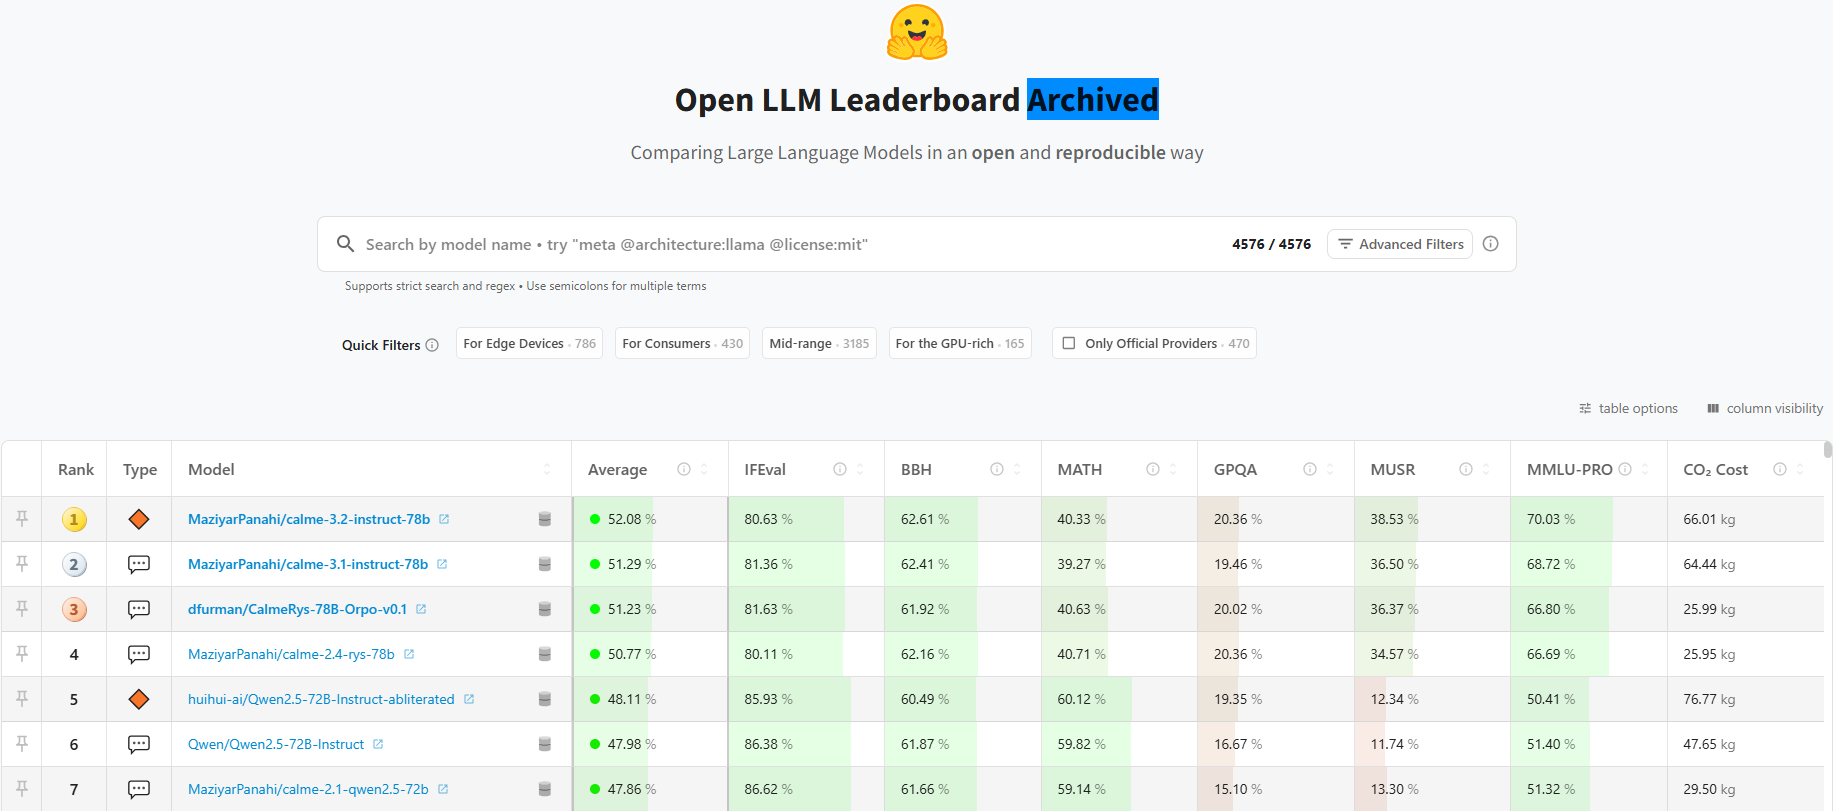
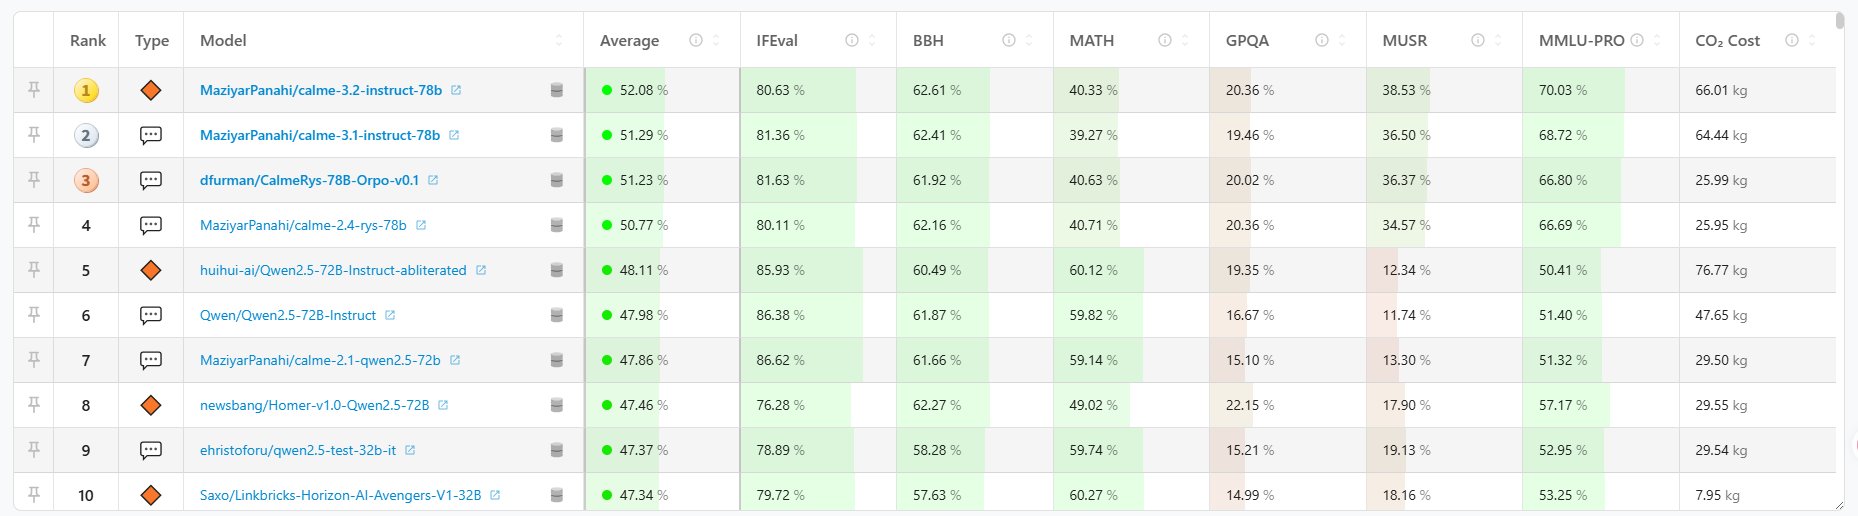
Open LLM Leaderboard是由全球最大AI开源社区Hugging Face推出的开源大语言模型(LLM)在线评测排行榜,被誉为AI模型界的"奥运会"和"照妖镜"。它通过标准化的评测基准、统一的测试环境和完全公开的评估代码,为所有开源模型提供公平竞技的舞台。截至2026年7月,该排行榜已累计评估超过13000个模型,月活跃社区用户近30万,是全球开源LLM评测领域最权威的参考指标之一。小编将从定义、评测体系、使用方法、争议局限和注意事项五个角度为您详细解析。
Open LLM Leaderboard是什么
Open LLM Leaderboard是一个动态更新的开源大语言模型在线评测排行榜,由Hugging Face于2023年推出并持续维护。其核心目标是为所有公开可用的大型语言模型提供一个标准化、透明化、可复现的评测环境,用客观数据替代营销话术,帮助开发者、研究者和企业做出明智的技术选型。
排行榜的诞生源于AI行业的一个痛点:早期模型评测多依赖厂商自报分数,缺乏统一标准,导致"刷榜"和"数据污染"问题泛滥。许多模型在公开数据集上表现优异,但在真实场景中却大打折扣。Hugging Face的RLHF团队在尝试复现和比较多个已发布模型的评测结果时,发现这几乎是不可能完成的任务——论文和营销材料中的分数往往缺乏可复现的代码,或使用了针对性优化的提示词和评测设置。
为此,Hugging Face基于Eleuther AI开发的Language Model Evaluation Harness(一个统一的开源评估框架)构建了Open LLM Leaderboard。所有模型在完全相同的条件下接受测试——相同的题目、相同的顺序、相同的评分标准——确保结果的完全可复现和可比较性。
自上线以来,Open LLM Leaderboard迅速成为ML社区乃至更广泛技术圈的重要资源。据Hugging Face官方统计,上线后10个月内累计吸引超过200万独立访客,每月约30万社区成员通过提交模型和参与讨论使用这一平台。它的出圈效应甚至影响了AI投资领域——投资人开始将"能否在排行榜上取得好成绩"作为评估AI创业公司技术实力的硬指标。
Open LLM Leaderboard的评测体系
Open LLM Leaderboard的评测体系经历了一次从v1到v2的重大升级,核心变化是从"考记忆力"转向"考真本事"。
v1版本(2023年——2024年6月归档)
初代排行榜采用6项核心基准评估模型的综合能力,运行在配备8块H100 GPU的集群节点上:
| | | |
|---|
| | | AI2 Reasoning Challenge,一套小学科学难度的选择题 |
| | | 对人类极简单(约95%准确率)但对模型极具挑战的常识推断测试 |
| | | 覆盖57个学科的大规模多任务语言理解测试,从数学到法律 |
| | | |
| | | |
| | | |
然而,随着模型能力的飞速提升,v1的评测基准逐渐"饱和"——MMLU从GPT-3时代的43%飙升至前沿模型的97%-99%,几乎失去了区分度。同时,数据污染问题日益严重:研究人员发现Yi-34B有94%的概率存在MMLU训练集污染,CausalLM/34b的MMLU得分甚至被判定为理论不可达。这些基准逐渐从"信号"退化为"走过场"。
v2版本(2024年10月重磅升级)
面对v1的困境,Hugging Face于2024年10月推出Open LLM Leaderboard v2,全面换用一套更难、更新、更抗污染的评测基准:
| | |
|---|
| | 将选择题从4选1升级为10选1,大幅提高推理难度,降低蒙对概率 |
| | 由物理、生物、化学领域博士设计题目,Google搜索无法直接作答,数据集受控访问以降低污染风险 |
| | 算法生成的多步推理题,包含谋杀谜案、资源分配等复杂场景 |
| | 只取MATH数据集中最高难度的子集,考验真正的数学推理而非模式匹配 |
| | 严格评估模型能否精确遵循复杂、细粒度的格式和约束指令 |
| | 从BIG-Bench中筛选出的23项最难任务,曾让早期模型表现不及随机猜测 |
v2发布时的首批评测结果中,阿里Qwen2-72B-Instruct以平均分43.02排名第一,Meta的Llama-3-70B-Instruct以36.67分位列第二。此后排行榜排名随着新模型不断加入而持续刷新,DeepSeek、Mistral、Yi等模型家族也先后在榜单上占据重要位置。 Math-Verify事件:评测管道的一次深刻教训
2025年2月,Hugging Face发布了一份事后分析报告,揭示了一个持续数月、影响深远的评分Bug:MATH基准的评测框架无法正确解析LaTeX \boxed{}格式的答案——而这恰恰是DeepSeek模型家族的标准输出格式。结果,DeepSeek系列模型的MATH成绩被系统性地低估。
修复方案是Math-Verify,一个新的开源答案提取库。Hugging Face用它重新评估了所有提交过的3751个模型。修正后,平均每个模型多解决了61道MATH题目,分数平均提升4.66分,DeepSeek模型的MATH成绩几乎翻了三倍。Top 20排名完全洗牌——NVIDIA的AceMath系列一跃登顶。这一事件深刻暴露了评测管道的脆弱性:当基准测试依赖非平凡的答案解析时,一个格式解析Bug就能持续数月扭曲整个行业对模型能力的认知。
Open LLM Leaderboard怎么用
对于不同类型的用户,Open LLM Leaderboard有着不同的使用方式:
场景一:技术选型——快速锁定候选模型
面对Qwen、Llama、DeepSeek、Mixtral等众多优秀开源模型,可以登录Open LLM Leaderboard页面,根据业务需求筛选和比较相关模型的得分:
- 按综合得分排序:页面默认按Average(综合平均分)降序排列,可快速了解当前最强开源模型
- 按单项能力筛选:点击具体基准列可以单独排序——如果应用需要强大数学能力,重点看MATH分数;如果构建客服机器人,重点关注IFEval(指令遵循)分数
- 按模型类型区分:区分预训练基础模型(Base/Pretrained)和指令微调模型(Instruct/Chat),后者在对话和指令遵循任务上通常表现更好
- 排序与搜索:新版排行榜支持客户端即时排序和搜索,按模型名称、参数规模、架构类型等维度快速筛选
场景二:模型研发——定位优化方向
如果你的团队在微调自己的模型,可以将模型提交到排行榜进行评估。提交后,Hugging Face的计算集群会按队列顺序自动运行全套基准测试。通过详细的分项报告,可以清晰识别模型的薄弱环节——是复杂推理拖了后腿,还是指令遵循能力不足——从而有针对性地改进训练数据和策略。排行榜还引入了社区投票机制:用户登录Hugging Face账号后可为待评测模型投票,高票模型将获得优先评测。
场景三:学习研究——追踪技术前沿
排行榜的详细数值结果和模型输入/输出均保存在Hugging Face的公开数据集中,任何人都可以下载和分析。点击每个模型名称旁的文档图标,还可查看该模型在每道题目上的具体表现。这对于研究模型行为、分析评测偏差和撰写技术报告极具价值。排行榜也记录了每个模型的参数规模、架构类型、提交日期等元数据,是追踪开源LLM发展历程的重要档案。
Open LLM Leaderboard的争议与局限性
尽管Open LLM Leaderboard是当前最权威的开源模型评测平台,但它并非万能,需要理性看待其局限性:
基准饱和不可逆
这是排行榜面临的根本性结构问题。任何固定的评测基准都会随着模型能力的提升而逐渐"饱和"——当所有前沿模型都能拿到接近满分的成绩时,该基准就失去了区分度。v1的HellaSwag和ARC从2023年的有效指标变成了2024年的走过场形式。v2的GPQA目前仍保有区分度(前沿模型得分60%-80%),但没人知道这个窗口期能维持多久。Hugging Face的策略是持续迭代——但这意味着排行榜本身就是一个消耗品。
数据污染难以根除
即使v2采用了受控访问数据集(如GPQA),训练数据的污染仍然是一个挥之不去的阴影。大型模型的训练语料通常包含抓取自互联网的海量文本,其中不可避免地混入了评测数据集的内容。当一个模型的得分"异常高"时,很难区分这源于真正的能力提升还是无意中的数据泄漏。
通用能力≠垂直领域能力
排行榜衡量的是模型的通用能力——通识知识、常识推理、基础数学、指令遵循等。对于特定垂直领域的需求(如医疗诊断、法律分析、金融建模),排行榜分数几乎没有参考价值。Hugging Face社区为此推出了多个垂直领域专用排行榜,如Open Medical LLM Leaderboard(医疗)、Open Chinese LLM Leaderboard(中文)等作为补充。
评测得分≠用户体验
一个在排行榜上得分很高的模型,在实际对话中的流畅度、安全性、偏见控制、对齐效果等方面可能表现平庸。排行榜不评估模型的"聊天感受",这是LMSYS Chatbot Arena通过人类众包投票来解决的问题。两大平台互为补充:排行榜测"硬实力",Chatbot Arena测"软体验"。
排名具有动态性
排行榜会随着新模型加入和评测基准更新而不断变化。今天的冠军明天就可能被后来者超越,同一模型的排名在不同版本的排行榜上可能天差地别。引用排行数据时务必标注评测日期和版本。
Open LLM Leaderboard使用注意事项
Open LLM Leaderboard使用注意事项
核心原则
- 不要只听厂商怎么说,要看排行榜上怎么排:排行榜的核心价值在于为开源模型提供一个去伪存真的"硬指标",但需结合多维度信息综合判断
- 按需选型而非盲目追高:如果你的应用核心需求是数学推理,关注MATH分数即可,不需要追求综合排名最高的模型——大参数量模型部署成本更高,推理速度更慢
- 综合得分是参考,单项得分是关键:Average综合得分只是一个快速参考,真正决定模型是否适合你的是与你业务最相关的单项基准得分
常见误区
- 误区一:排行榜第一 = 最好用的模型。排行榜只测通用能力,实际部署还需评估推理速度、资源消耗、安全隐患、中文支持质量等工程指标
- 误区二:高分模型可以胜任任何任务。不同基准测试不同维度的能力,一个在MMLU-Pro上拿高分的模型可能在IFEval(指令遵循)上表现平平,反之亦然
- 误区三:只看总分就可以做决策。务必点击模型详情查看各单项基准的分项得分,尤其要关注与你业务场景最相关的维度。以AI客服为例,IFEval(指令遵循)和TruthfulQA(真实性)的分数远比MMLU-Pro(学术知识)重要
- 误区四:排行榜分数可以跨版本比较。v1和v2使用完全不同的基准集,v1的70分和v2的40分没有直接可比性。比较时必须确认同一版本
实战建议
- 技术选型时,使用排行榜初筛候选模型(Top 10-20),然后对入围模型进行自有业务数据的内部评估
- 关注模型参数规模与得分的关系:同等得分下,参数量越小的模型通常推理成本越低,工程价值更高
- 定期关注排行榜的版本更迭公告:当Hugging Face宣布新的基准集或修复重要Bug(如Math-Verify)时,应及时刷新对模型排名的认知
- 结合LMSYS Chatbot Arena(人类偏好投票)和垂直领域排行榜(医疗、代码、中文等)进行多维评估,形成完整的选型依据
- 如果将自研模型提交到排行榜,需注意提交的模型应为公开可用的版本,评测结果将被完全公开存储
以上内容基于截至2026年7月的公开信息整理,仅供参考。Open LLM Leaderboard的评测基准、排名和政策可能随Hugging Face的更新而调整,具体以Hugging Face官方页面最新公告为准。
 AI 速览