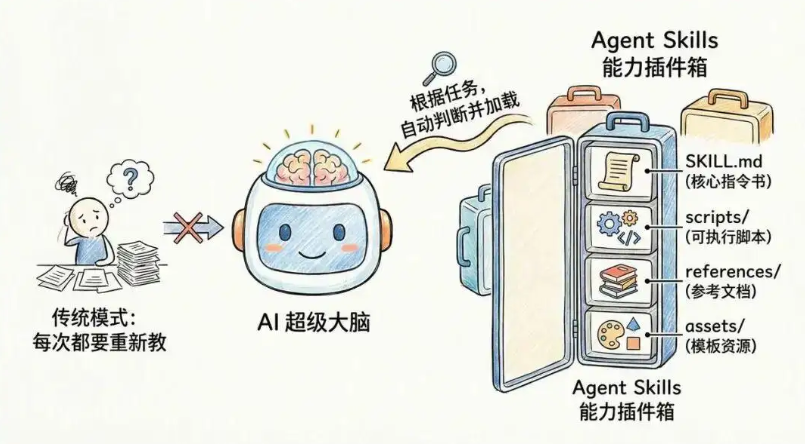
如果你也发现同一份接口文档,AI今天吐表格明天写散文,缺陷单标题像随笔——问题不在模型笨,是你没把团队的验收标准焊成可复用的闸门。这篇文章讲的就是,怎么用Agent Skills把测试SOP写进Markdown,让AI照着你们的规矩交差,而不是每次临场发挥。
说实话,你用AI当聊天框用了两周,大概率会撞上这个尴尬事实。缺陷系统里更离谱,复现步骤缺环境,预期结果就写「应该正常」四个字。这不是AI能力不够,是你没给它立规矩。
Agent Skills是什么:测试人的作业指导书,不是玄学插件
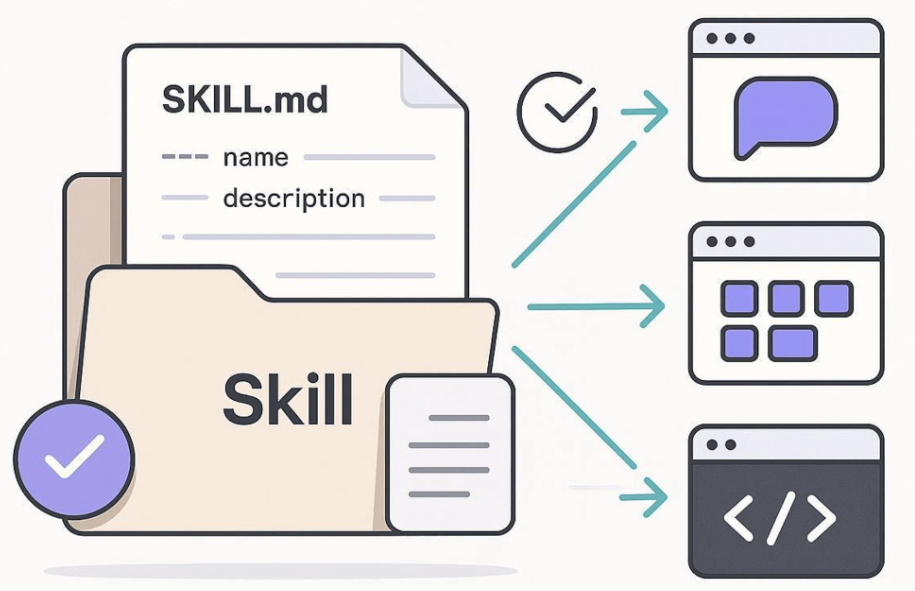
很多人以为Skill是什么玄学插件,其实对测试这行来说,它就是写进目录的一份作业指导书。description要写清楚「什么场景该唤醒我」,模型才会自动接手;正文不会一上来就塞满上下文,任务真匹配了才加载——这个叫渐进式披露,能省token,输出也更稳。
挂载也没那么复杂。把目录放到项目的技能目录下,比如Cursor类工具常见放在项目下的skills文件夹里,具体路径以你所用工具的文档为准。设置里能看到名字,对话里@一下就接上了。写Skill有几条土经验:description写清楚什么时候用,正文给能直接抄的表格样例,单个文件别写成百科全书。复杂规则丢进单独的references目录里,主文件尽量压在500行以内。
摸底类Skill:接手陌生仓库,先把散文变成可追溯标准件
接手陌生仓库最怕的不是不会测,是不知道从哪下刀。摸底类的Skill负责把散文变成可追溯的标准件。
用例生成类Skill:文档转用例、PRD转XMind、接口场景四覆盖
文档用例生成器能从PRD或接口文档直接产出结构化用例,默认覆盖正向、反向、边界、等价类、状态和场景这几个维度。你说一句「重点做接口」或者「标出自动化候选」,它就会叠加对应标准。这类工具最省时间的地方,不是写得多,而是维度不容易漏——很多人手写用例,边界和异常那部分永远写得稀稀拉拉。生成完了还是建议你自己过一遍优先级,AI能放大覆盖面,拍板的还是人。
思维导图类的用例产出可直接导入XMind的大纲,层级是根到模块到功能到测试点再到步骤和预期,适合评审会用。需求原文本身糊,AI切模块也会跟着糊,建议先把PRD按章节理顺了再喂进去。
接口场景类的按路径、方法、参数、业务规则,能吐出正常、异常、边界、鉴权四类场景,表格字段锁死,能进用例库,也能改成自动化数据驱动的素材。把鉴权、缺参这些写进模板之后,它基本每次都按同一骨架输出,接口层稳了,后面UI自动化才少踩「后端其实早挂了」这种坑。
出证类Skill:缺陷单、日志分析、压测脚本一次交齐
缺陷整容台能把「登录报错了」这种半截话补成标题、复现、预期、实际、环境都齐全的标准件。日志分诊台对着Nginx、应用、接口日志自动抽错误判类型,半夜值班比人肉翻屏快不少。压测脚本工程师按固定模板生成可执行脚本,断言、参数化、关联这些不容易漏,信息不全的时候它会先追问而不是瞎猜业务,生产密钥、乱压生产这类风险动作它也会主动拦住。
扩产类Skill:从会用别人的,到自己会造Skill
需求变规范、规范变施工图,这两步是把一句话功能说明落成可审阅的Markdown,再拆成改哪些文件、分几步。规范里视觉约束没写清楚,实现阶段照样会漂,这点得多留意。
真正拉开团队差距的,往往是最后一步——自己会造Skill,而不只是用别人写好的。很多团队装了一堆现成的就停手了,从「会用」升级到「会给团队造」,才是分水岭。
部署优先级建议:别一次全开,分阶段上线更稳
节奏上建议先上文档用例、接口、缺陷、日志这几类,几乎零环境成本,马上能交差;再用摸底类的把陌生仓库和需求评审搞清楚;压测周单独上;有页面交付压力再上规范和施工图那两步;最后再考虑自己造Skill,把团队的军火库建起来。
有个坑得提前说清楚:description写糊了,模型不会自动唤起;模板不给示例,表格字段照样到处飘。Skill不是替你背锅的黑盒,P0流程要是写错了,后面全偏。权限、模型额度、前端钩子,任何一项卡住都可能让计划搁浅,分阶段推进,比一次装十二个然后全闲置要靠谱得多。
刚开始用可能会觉得比手写还慢,因为你在补规范。但规范一旦沉淀下来,复利才真正开始。你要是测试新人,也别指望装上就能飞——AI放大的是判断力,你自己没有边界值意识,生成出来的也只是更整齐的漏测。方向是清楚的:把经验写成Markdown和脚本,让AI照着你们的规矩输出。工具会变,但把隐性经验变成显性标准这件事,大概率不会过时。
BUG怕不怕你,说到底取决于你有没有把自己的方法论,变成AI一打开就能执行的那几道闸门。
 AI 速览