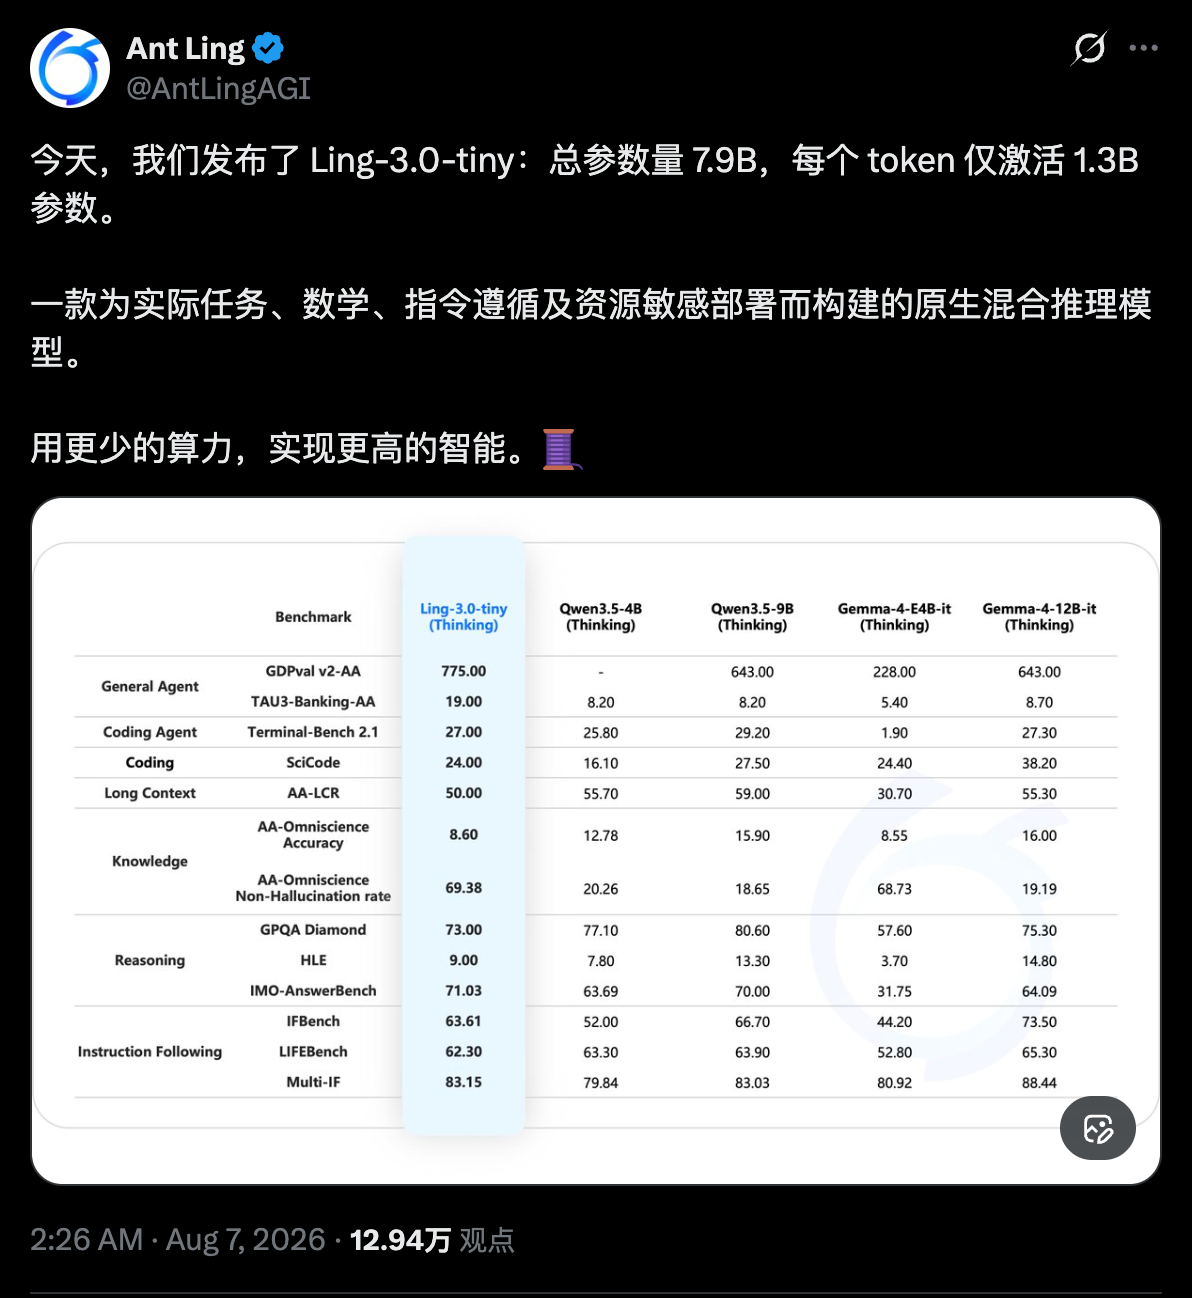
8月7日消息,蚂蚁集团旗下百灵(InclusionAI)发布 Ling-3.0-tiny。这是一款原生混合推理模型,总参数量 7.9B、采用 MoE 架构,每个 token 仅激活 1.3B 参数,定位真实任务、数学、指令遵循与资源敏感型部署。模型现已上线 OpenRouter 与 Vercel AI Gateway,免费试用至太平洋时间 8 月 13 日上午 9 点,权重尚未放出,官方表示开源即将推出。 1.3B 激活参数:参数效率路线再下探
Ling-3.0-tiny 是蚂蚁百灵 Ling 3.0 系列的第二款模型。7 月 24 日发布的 Ling-3.0-flash 总参 124B、每 token 激活 5.1B,tiny 把激活参数进一步压到 1.3B,同时保持 256K 上下文窗口、最高 32K 输出。官方将这款模型描述为"用更少的算力,获得更多智能"(More intelligence with less compute),主打资源敏感型部署场景:低激活参数意味着推理时占用更少的显存与算力,适合本地、边缘或高并发低成本调用。
功能配置上没有因参数缩减而砍掉企业场景能力:支持原生函数调用、prompt caching,以及 Thinking 与 Instant 双模式切换,可覆盖 Agent 工具调用与快速响应的混合负载。模型性能目前以厂商口径为主,尚无第三方独立评测数据落地。
免费 API 与开源预告
Ling-3.0-tiny 已上线 OpenRouter(模型 ID 为 inclusionai/ling-3.0-tiny:free,当前定价为 0)与 Vercel AI Gateway(inclusionai/ling-3.0-tiny-free),限时免费试用至太平洋时间 8 月 13 日上午 9 点。免费期结束后模型将转为正式 ID 并按量计费。
权重方面,官方预告开源即将推出,具体日期未公布。这一节奏与 Ling-3.0-flash 一致:flash 免费期结束后,于 8 月 4 日以 MIT 协议开源,提供 BF16 与 FP8 版本,部署在 Hugging Face 与 ModelScope。若 tiny 沿用同一路径,7.9B 参数规模的基础权重体积将远小于 flash(约 255GB 的 BF16 版本),更适合本地与边缘部署。
开发者生态的"免费试用 + 开源"节奏
Ling-3.0-tiny 与 flash 的组合,把蚂蚁的参数效率路线铺成了两条产品线:flash 以 5.1B 激活服务高密度推理,tiny 以 1.3B 激活切入资源敏感场景,共享同一套原生混合推理架构与 Agent 能力。对开发者而言,这是一个低成本验证入口:免费期内可通过 OpenRouter 或 Vercel 直接调用,验证 1.3B 激活模型在自身场景的效果,再决定是否接入或等待开源自部署。
对蚂蚁而言,这套打法延续了其避开参数军备竞赛、以智效比和开源生态切入的路径。字节、阿里等厂商仍在堆参数,蚂蚁则持续用更小的激活参数对标更大规模的模型,并以限时免费降低开发者的尝试门槛。这一策略能否沉淀出实际生态,取决于免费期后的转化与开源社区的接受度。
 AI 速览