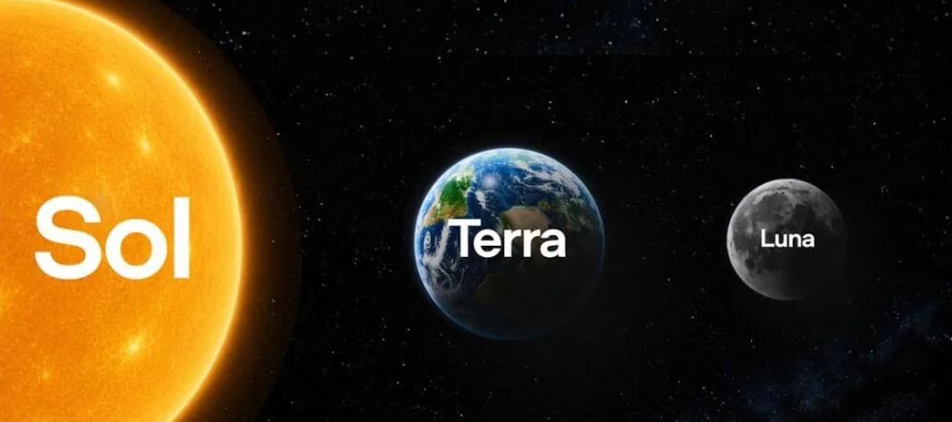
chatgpt 5.6 sol terra luna分别是什么?这三个不是三个独立模型换皮卖,而是OpenAI官方明确说的"能力层级"(capability tiers)——5.6是这一代的版本号,Sol/Terra/Luna才是长期存在的分层品牌,以后可能各自独立升级迭代。Sol最强也最贵,Terra能力和价格都居中,Luna最快最便宜。具体怎么选,往下给你拆开讲。
一、定价:差距挺明显
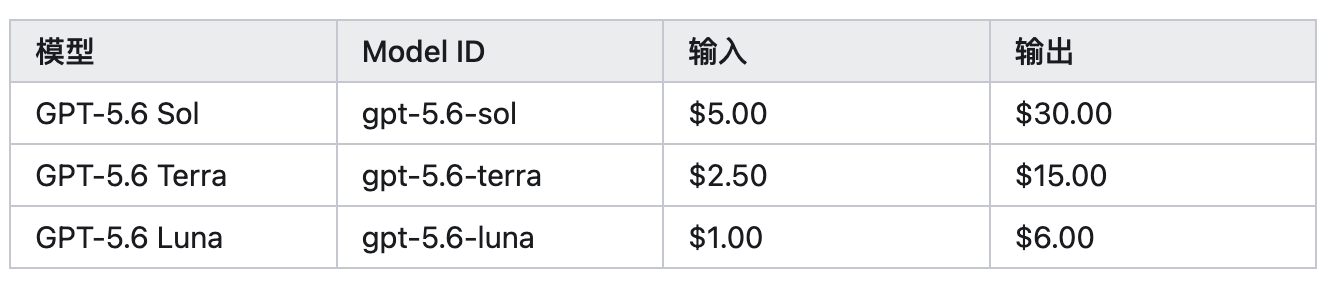
按官方每百万tokens计价(输入/输出):
Sol:5美元/30美元
Terra:2.5美元/15美元
Luna:1美元/6美元
要注意的是,缓存写入按未命中缓存input价格的1.25倍计,读取有大概九成折扣。拿Anthropic同期定价对比一下,Claude Fable 5输入输出是10美元和50美元,Opus 4.8是5美元和25美元,Sonnet 5是3美元和15美元——OpenAI这次打的是性价比牌,Sol基本对标Fable 5,价格却只有对方一半左右。 二、能力差距,实测数据比想象中小
跑分数据挺有意思:Terminal-Bench 2.1上,Sol单agent模式88.8%,开启Ultra多智能体并行模式能冲到91.9%;SWE-Bench Pro上Sol是64.6%、Terra是63.4%、Luna是62.7%,三档之间差距其实不算大(作为参考,Claude Fable 5在同一张表上是80%)。DeepSWE v1.1上Sol 72.7%、Terra 69.6%、Luna 67.2%,同样是差距有限。这说明如果你不是做超高强度的终端操作或者极端复杂任务,Terra基本能覆盖大部分日常需求,没必要一上来就锁死Sol。
三、推理强度还能细调
ChatGPT网页端有Effort(推理强度)滑桿,从低到高分Light、Medium、High、Extra High、Ultra五档,Ultra模式默认会派4个AI并行处理同一任务,各自分工再汇总,效果最好但token消耗和耗时也最大。
API这边用reasoning effort参数,分none、low、medium、high、xhigh、max六档,比界面上的选项更细。OpenAI Codex团队内部建议是日常用Sol的Medium档就够,真遇到难题再切Extra High,Ultra留给性能要求极致的场景。
四、怎么选,按任务失败成本判断
选Sol的场景是任务失败成本特别高的时候,比如复杂代码生成、关键安全分析、高价值科研任务,这类容错率低的活儿别省钱。
Terra是大多数企业和开发者的性价比之选,日常文档处理、内容创作、内部助手推理这些场景都能扛住。
Luna瞄准的是对成本和速度极度敏感的高频批量任务,不是"缩水版"而是专门为效率场景设计的选项。
看完这篇关于chatgpt 5.6 sol terra luna的梳理,核心就记住一点:三档是同一代模型下的能力分层不是三个割裂产品,日常任务优先Terra,真正的硬骨头留给Sol,高频简单活儿交给Luna,按任务失败成本来判断,基本不会选错。
 AI 速览