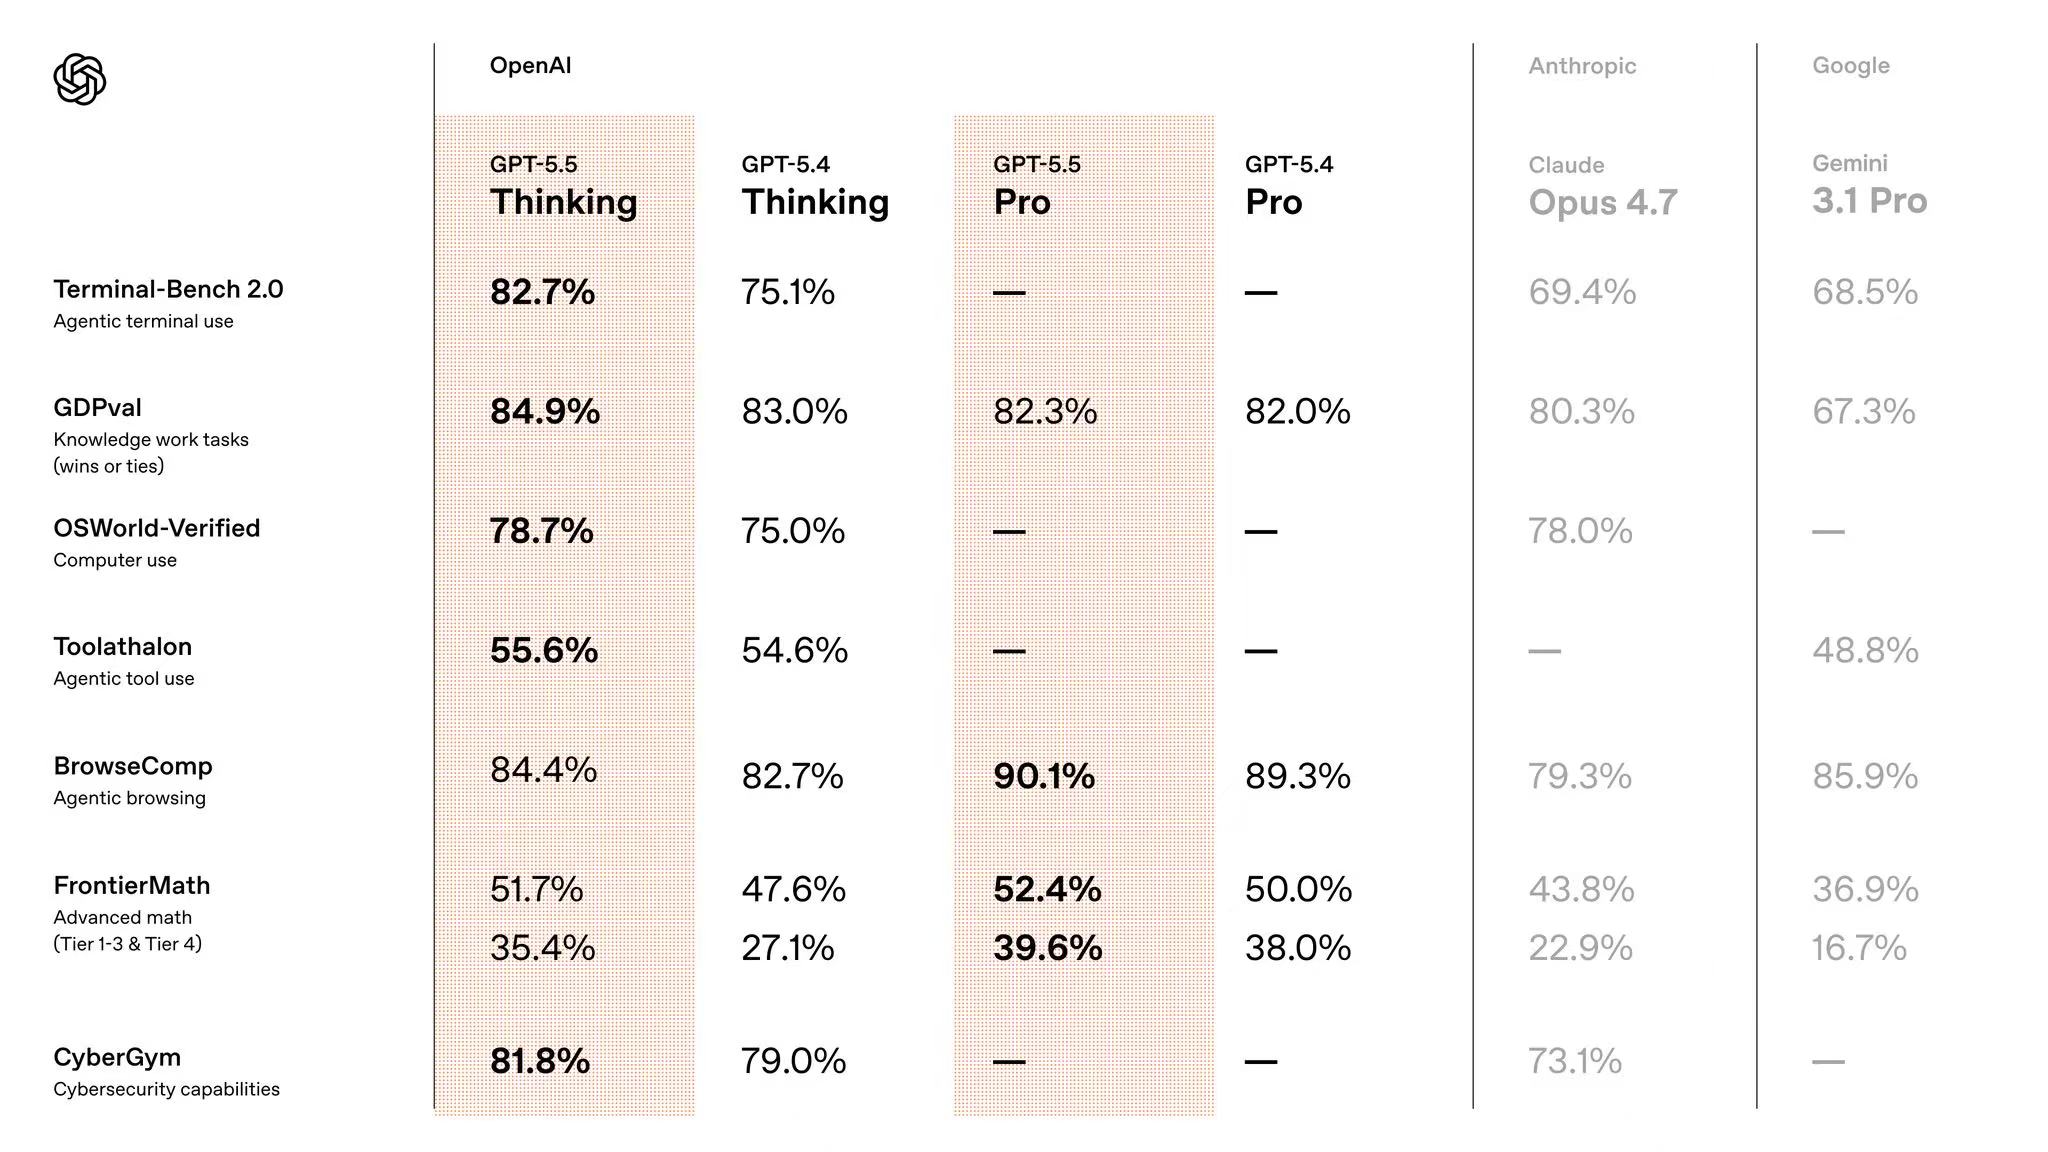
4月24日消息,OpenAI 今日向 ChatGPT 和 Codex 付费用户推送新一代旗舰模型 GPT-5.5 及更高阶的 GPT-5.5 Pro,距上代 GPT-5.4 仅隔 6 周,主打 Agent 编码、计算机操作与长程知识工作,内部代号"Spud"(土豆)。
从"聊天模型"转向"Agent 运行时"
OpenAI 将 GPT-5.5 定位为"迄今最智能、最直观易用的模型",用户可以直接抛给它一个零散、多步骤的任务,由模型自行规划、调用工具、检查结果并在歧义中推进,而不必逐步拆解指令。总裁 Greg Brockman 在发布会上称其为"新一类智能"和"迈向更具代理性、更直观的计算方式的重大一步"。
产品叙事上的位移比参数表更值得注意:OpenAI 此次把"完成任务"而非"回答好不好"放在首位,营销口径明显从 Chat Completion 转向 Agent Runtime。发布会期间 Bank of New York CIO Leigh-Ann Russell 给出的背书也呼应了这个方向——她强调对高监管行业而言,GPT-5.5 最关键的是响应质量与"令人印象深刻的幻觉抵抗力","银行需要极高的准确度,这个模型带来了阶跃式变化"。
14 项基准 SOTA,Agent 编码优势最明显
OpenAI 自报 GPT-5.5 在 14 项评测拿下 SOTA,优势最集中的是长程工具使用类任务:
- Terminal-Bench 2.0:82.7%,大幅领先 GPT-5.4 的 75.1%、Claude Opus 4.7 的 69.4%、Gemini 3.1 Pro 的 68.5%
- GDPval:84.9%(44 个职业的知识工作评测)
- OSWorld-Verified:78.7%(真实计算机环境操作)
- Tau2-bench Telecom:98.0%(未做 prompt 调优)
- Expert-SWE:73.1%(中位数人类完成时长 20 小时的长程编码任务)
- MRCR v2 8-needle 512K-1M:74.0%,相比 GPT-5.4 的 36.6% 和 Opus 4.7 的 32.2% 是阶跃式跃升
Pro 版本则把 BrowseComp 推到 90.1%,FrontierMath Tier 4 达到 39.6%,GeneBench 33.2%,专门服务法律、金融、科研等"错一次成本远大于调用成本"的高赌注场景。
效率侧,OpenAI 称 GPT-5.5 在实际部署中与 GPT-5.4 保持相同的 per-token 延迟,但在 Codex 上用更少 token 就能拿到更好结果。
定价、上下文与可用性
API 即将上线:GPT-5.5 定价为输入 5 美元/百万 token、输出 30 美元/百万 token,1M 上下文窗口;GPT-5.5 Pro 为输入 30 美元/百万、输出 180 美元/百万。Batch 与 Flex 按标准费率的一半计费,Priority 档则是 2.5 倍。Codex 环境的上下文窗口为 400K,并新增 Fast 模式(速度 1.5 倍,成本 2.5 倍)。
ChatGPT 中,GPT-5.5 面向 Plus、Pro、Business、Enterprise 用户开放,GPT-5.5 Pro 仅限 Pro、Business、Enterprise 三档;免费用户暂无法访问,Enterprise/Edu 需管理员开启。API 部署"很快"上线,因为"需要不同的安全保障"。
局限与竞品对比:SWE-Bench Pro 仍落后 Opus 4.7,Mythos 压制未解
并非全线领先。Anthropic Claude Opus 4.7(4 月 16 日发布)在多项软件工程与纯推理评测上仍占优:SWE-bench Pro 64.3 vs 58.6、HLE 无工具 46.9 vs 41.4、HLE 带工具 54.7 vs 52.2。OSWorld-Verified 上 78.7 vs 78.0 基本平手。LLM-Stats 的分析指出两家共享的 10 项基准里 Opus 4.7 领先 6 项、GPT-5.5 领先 4 项,差距多在 2-13 分之间,"看任务选模型"比"看排行榜"更实际。
真正的天花板在 Anthropic 另一条产品线:受限发布的 Claude Mythos Preview 在 SWE-bench Pro(77.8)、HLE 无工具(56.8)、HLE 带工具(64.7)、CyberGym(83)、OSWorld-Verified(79.6)等多项基准上仍压制 GPT-5.5,唯一被 GPT-5.5 Pro 明确拉开的是 BrowseComp 90.1 vs 86.9。但由于 Mythos 被 Anthropic 以安全为由封闭在受控访问内,商用市场的对手仍是 Opus 4.7 和 Gemini 3.1 Pro。
评测口径上也有需要打折的地方:OpenAI 用自家定制的 Codex CLI harness 跑 Terminal-Bench 2.0,Anthropic 用 Terminus-2 框架——在 Anthropic 的 Terminal-Bench 2.1 修正版、4 小时超时条件下,Mythos 实测 92.1%,OpenAI 未公开匹配的重跑结果。SWE-Bench 则存在已知的记忆化争议,Anthropic 给出了去污染子集的复测,OpenAI 仅标注"存在记忆化证据"而未给出过滤后的结果。
安全侧,GPT-5.5 在 OpenAI 的 Preparedness Framework 下被评为 High(非 Critical),配套 Trusted Access for Cyber 等受控访问通道,并参考了近 200 家早期合作伙伴的反馈。
6 周节奏背后:Agent 叙事锁定期
GPT-5.4 到 GPT-5.5 只隔 6 周,加上 Opus 4.7 比 GPT-5.5 早一周发布的时间点,这套节奏说明前沿实验室不再以"论文级更新"作为发布单元,而是按产品发布周期持续迭代。Axios 的消息源透露,NVIDIA 工程师对模型评价极高,一位有早期访问权限的工程师称"失去 GPT-5.5 的访问权限感觉像被截肢了"。
但实际体验的分化仍然存在。在纯代码质量的硬问题上,Opus 4.7 仍是赢家;在带工具协同的 Agent 编码流程里,GPT-5.5 更稳。对中文开发者和内容团队而言,更直接的信号是两家公司在定价、上下文和 MCP 集成能力上的接近——GPT-5.5 输出 30 美元/百万 token,Opus 4.7 输出 25 美元/百万,便宜 17%;但 GPT-5.5 单任务 token 消耗更少,实际账单可能被拉平,选型逻辑进一步从"哪家模型更强"回到"我的工作流到底靠什么"。
下一步的节点在 API 上线与 Managed Agents 的推广节奏,以及 Google 何时把 Gemini 3.2 或 3.5 推出来接招。OpenAI 用 6 周封死 Agent 叙事的意图已很明确——问题是 Anthropic 和 Google 会以推理质量、还是以多模态、还是以其他方向反击。
 AI 速览