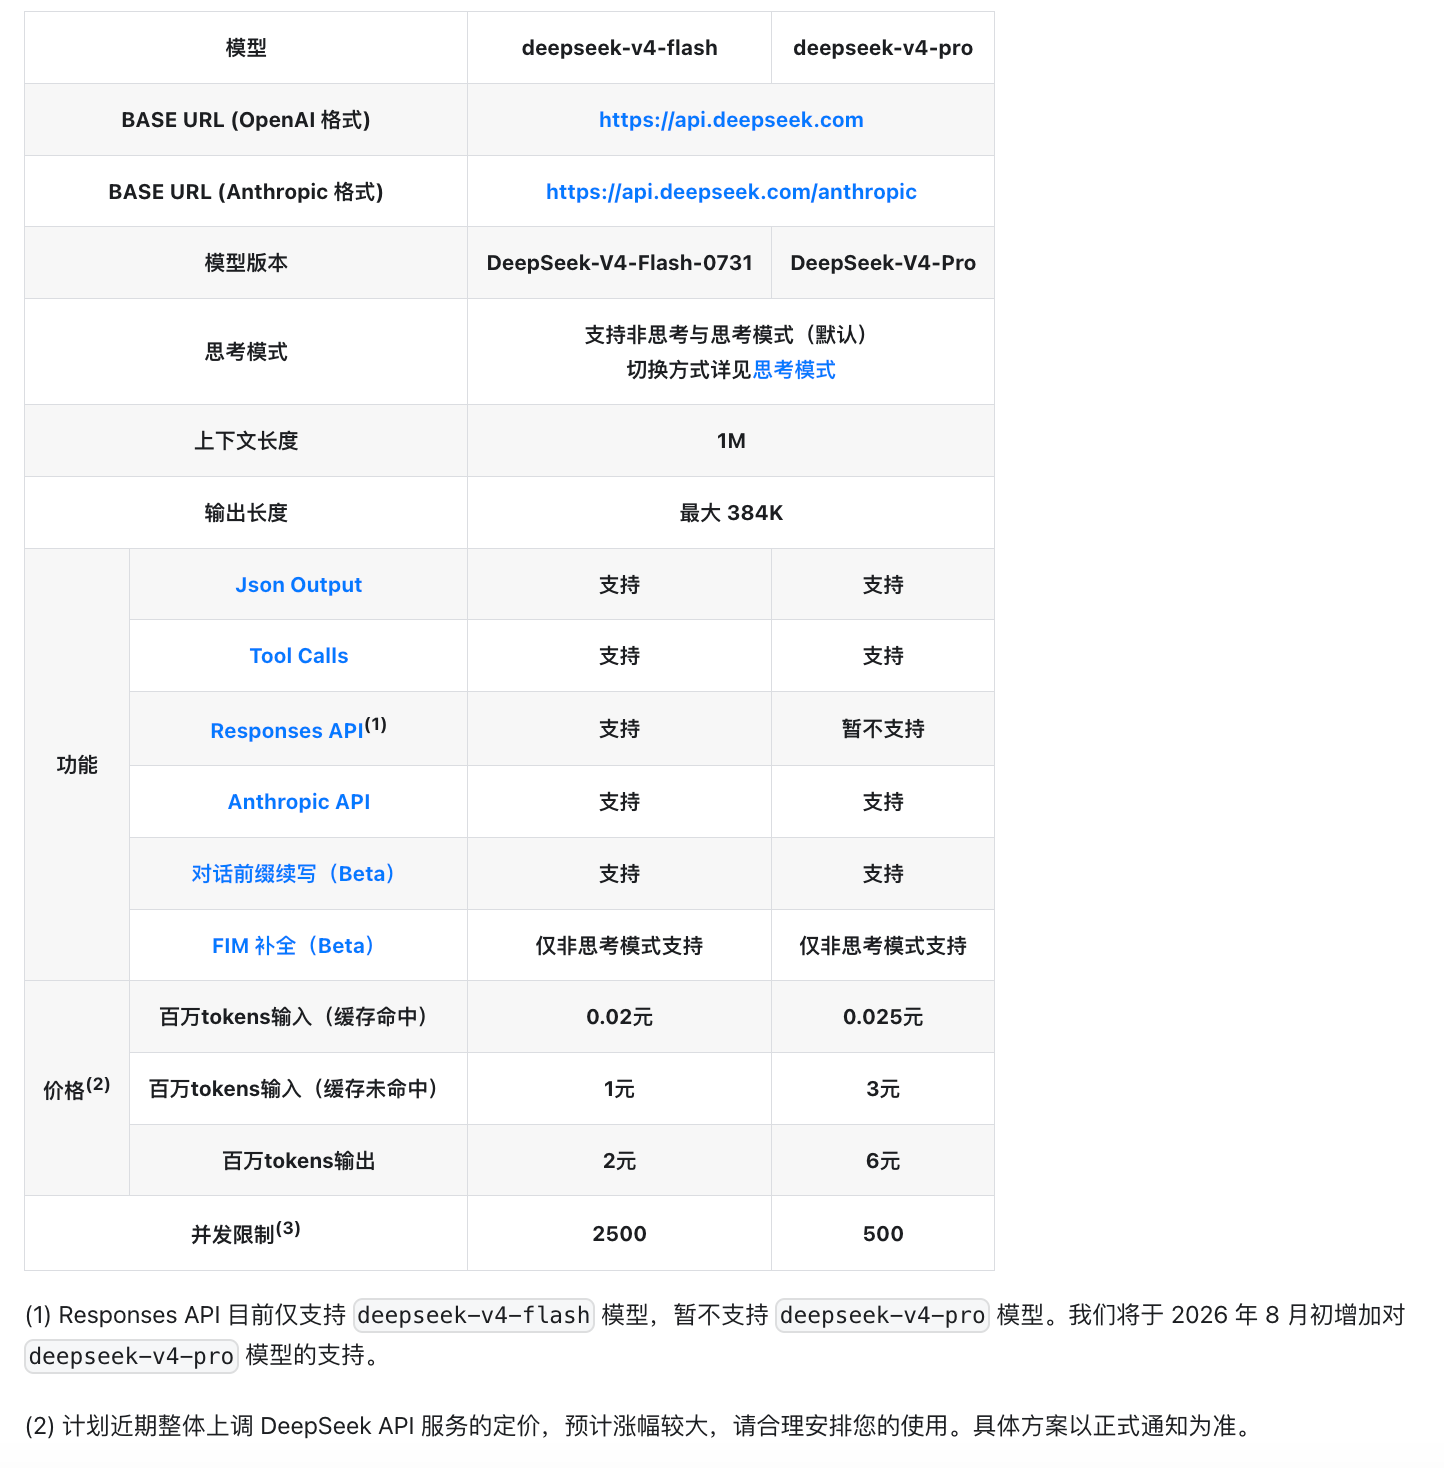
按DeepSeek官方价格定价页的数据,V4-Flash缓存命中输入只要0.02元/百万tokens,缓存未命中输入1元,输出2元,百万级上下文标配,这个价格放在整个行业里都算是地板价级别的存在。不过2026年8月初官方定价页已经预告要上峰谷定价,高峰时段价格会翻倍,这篇文章把最新的价格细节、跟同类模型的对比、还有实际怎么算账都给你说清楚。 一、V4-Flash和V4-Pro,价格差在哪
DeepSeek V4系列这次分了两个版本,Flash主打吞吐量和经济性,Pro主打复杂任务和知识密度,价格差距也挺大的。
.V4-Flash的官方定价是:缓存命中输入0.02元/百万tokens,缓存未命中输入1元/百万tokens,输出2元/百万tokens,并发上限2500。
.V4-Pro是:缓存命中输入0.025元,缓存未命中输入3元,输出6元,并发上限500。两个版本都支持百万级上下文窗口,这块没缩水。
提醒:网上不少文章引用的还是早期促销价,跟当下的正式价对不上,甚至有文章把V4-Pro写成12元输入、24元输出的,那大概率是更早的一版数字或者是弄混了促销价和常规价的区别,实际以你登录platform.deepseek.com看到的官网价格页为准最稳妥。
二、缓存机制怎么帮你省钱
V4-Flash缓存命中的价格是0.02元,跟未命中的1元比,差了整整50倍。这意味着什么呢,如果你的应用场景里有大段固定不变的上下文(比如系统提示词、项目文档、历史对话记录),只要触发缓存命中,这部分内容的费用几乎可以忽略不计。
拿个实际场景算笔账:假设你在做一个客服机器人,每次对话都要带上一份5000字左右的产品知识库作为背景,如果这份知识库内容重复率高、能命中缓存,跑1000次对话的输入成本可能就几毛钱;要是每次都算成未命中价格,成本能差出几十倍。这也是为什么做长期产品集成时,缓存命中率是个值得专门去优化的指标。
三、峰谷定价:8月起要留意的新变化
2026年8月初,官方定价页更新了说明,提到即将实行峰谷定价,北京时间9:00-12:00、14:00-18:00这两个时间段属于高峰期,价格会翻倍。这不是说V4系列整体在涨价,非高峰时段的价格目前看还是维持原样,只是把用量往低谷时段引导。
如果你是那种对成本敏感、任务又不急着实时出结果的场景,把批量任务排到晚上或者凌晨跑,能省下不少钱,这个策略值得纳入你的成本规划里。
这轮调价背后的原因也不难理解,V4-Flash上线以后调用量涨得太猛,一度在第三方平台上创下单周消耗超7万亿token的记录,服务器压力大到得靠价格杠杆去筛一部分低价值高频请求,不完全是成本涨了才调价,更多是流量管理的考虑。
四、跟同类模型比,便宜多少
放到行业里横向比一下更直观:GLM-5.2的输出价格在国际平台上大概是4.29美元/百万tokens,折算下来是V4-Flash的十几倍;Anthropic的Claude Fable 5输出价格更高,达到50美元/百万tokens;反过来看月之暗面的Kimi K3,最新一轮涨价后输出价格到了100元/百万tokens,走的是完全相反的"更贵但更强"路线。两条路线谁能笑到最后现在还不好说,但至少目前这个阶段,V4-Flash在纯价格维度上确实还是压制状态。 不过便宜归便宜,有开发者实测反馈,遇到复杂编码项目的时候,实际花费也可能到十几元一次,不是所有场景都能压到几毛钱那么理想,具体成本还是得看你任务的复杂度和token消耗量,别光看标价就下结论。
deepseek v4 flash官方价格这件事,核心记住三点就够了:常规价便宜到接近白送,缓存命中能再打骨折,8月起高峰时段要多留个心眼别踩坑。想精确到分钱级别的账,还是直接上platform.deepseek.com看官方最新价格页最靠谱,毕竟这类价格政策调整起来比想象中要频繁。
 AI 速览