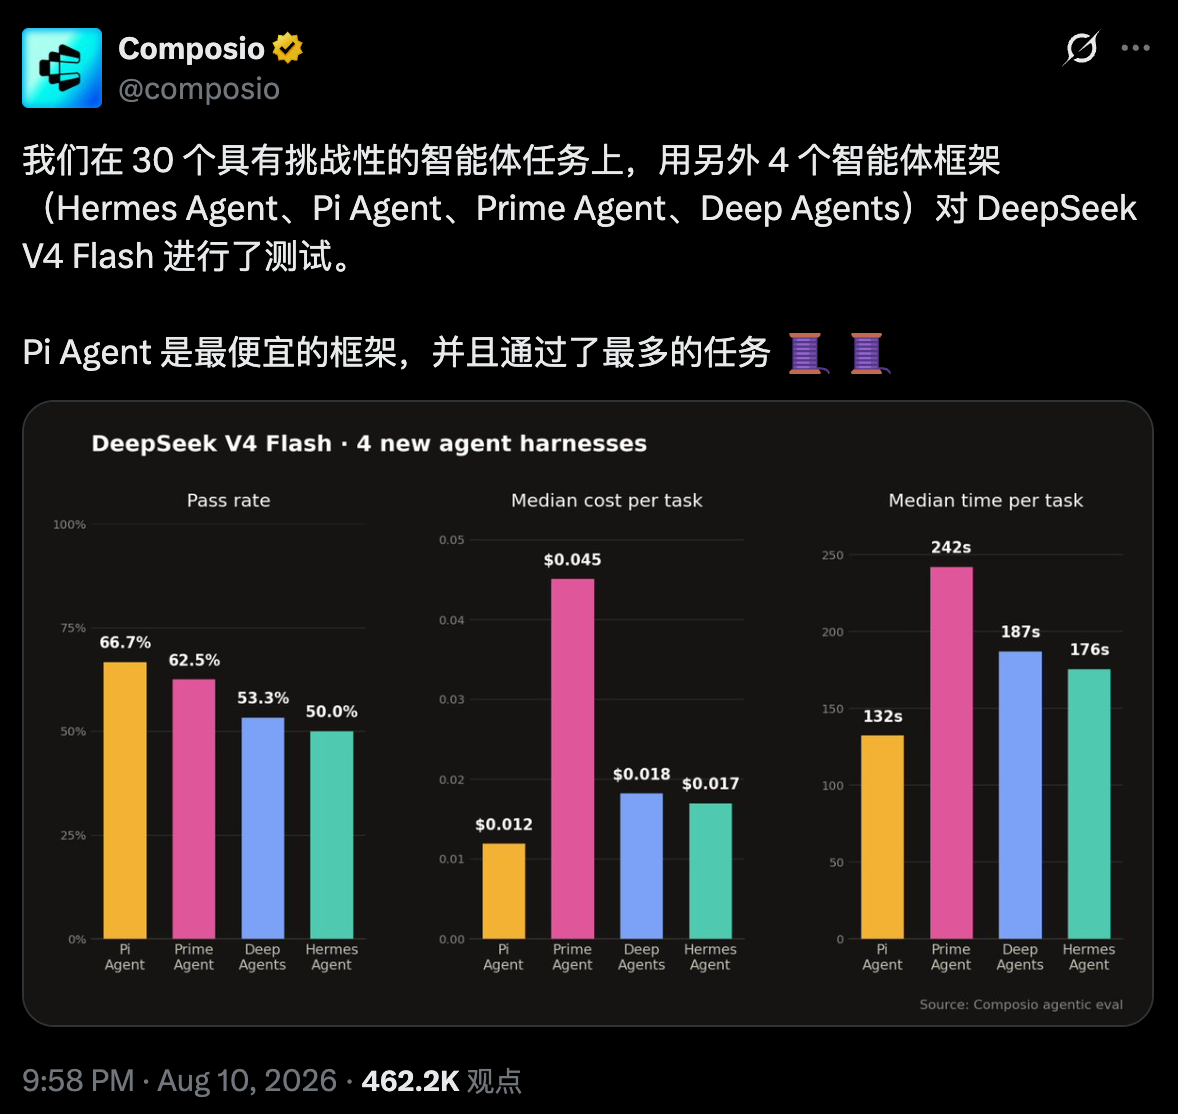
Agent 工具平台 Composio 发布评测:用同一个 DeepSeek V4 Flash 模型,在 8 个 agent 工具链(harness)上运行 30 个真实多步任务,任务成功率从 47% 到 67%,每成功任务成本从 0.028 美元到 0.195 美元,中位完成时间从 122.7 秒到 272.4 秒。结论是:同一模型在不同工具链下差异巨大,选型应该基准测试模型与工具链的组合,而不是孤立评估模型。 评测怎么做的:30 个真实任务,8 个工具链
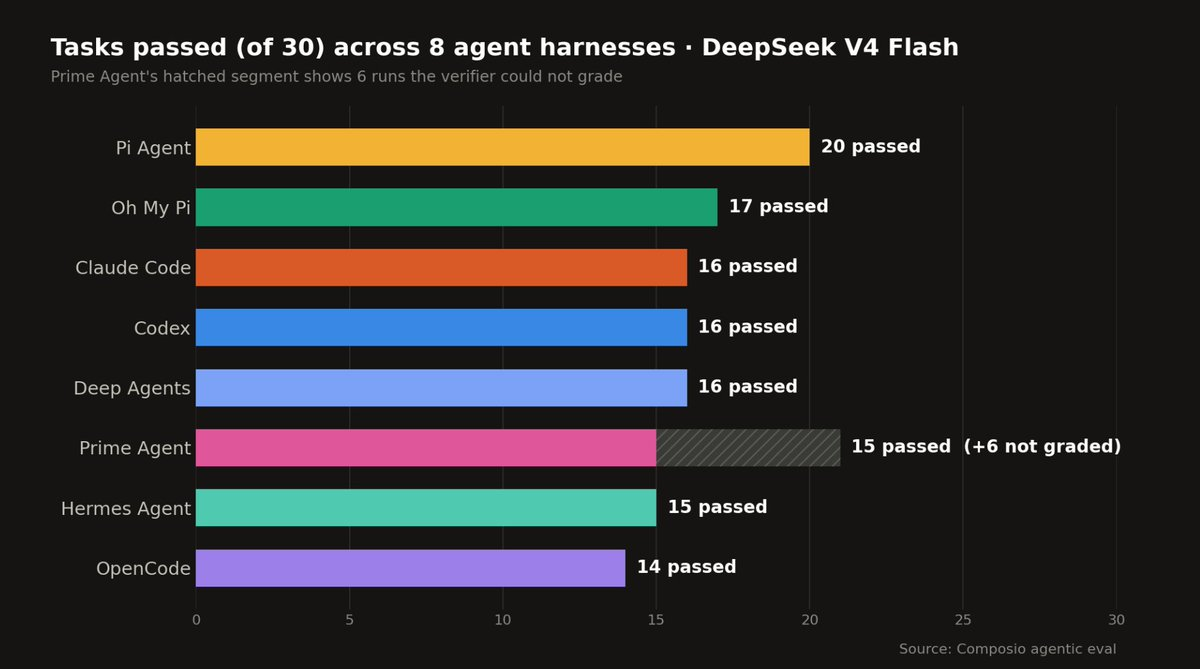
Composio 用 DeepSeek V4 Flash 跑了 30 个具有挑战性的 agentic 任务,任务使用真实工具(Gmail、GitHub、Slack、Notion 以及表格、日历、值班系统等),只有全部自动化状态检查通过才算成功。工具链分两批测试:第一批是 Claude Code、Codex、OpenCode、Oh My Pi(8月6日),第二批补充了 Hermes Agent、Pi Agent、Prime Agent 与 LangChain 的 Deep Agents(8月10日),合并为 8 个工具链的完整对比。 测试中的样本处理也做了说明:Prime Agent 排除了 6 个无法评分的运行,其中 2 个因 verifier 超时(单会话高达 3.5M tokens、33 次工具调用),4 个未记录;它产生了全部 8 个工具链中最重的会话。
结果:通过率、成本、速度分开看
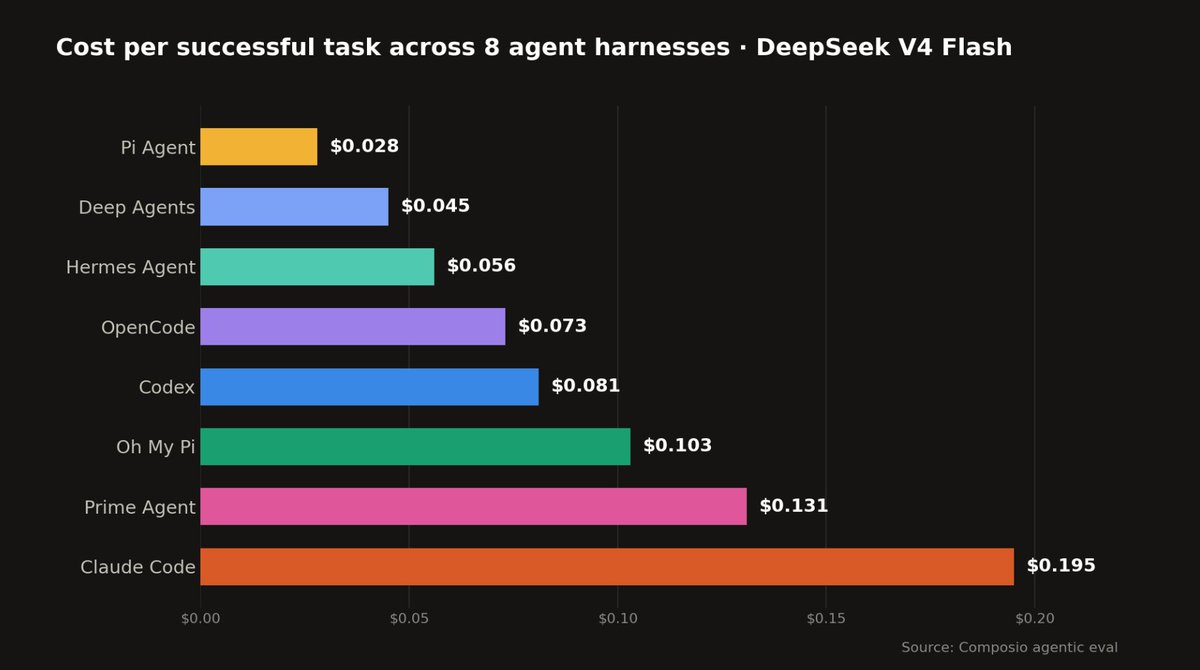
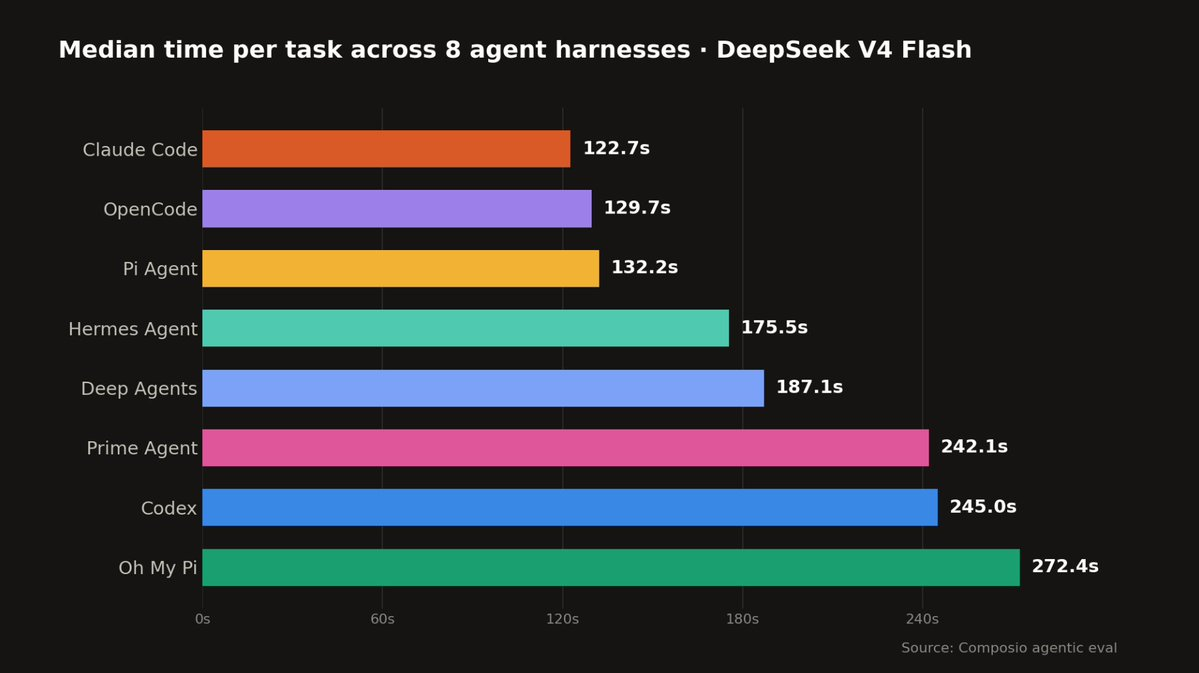
任务通过率。 8 个工具链完成 30 个任务的通过数从 14 到 20 个,对应成功率 47% 到 67%。Pi Agent 通过 20 个最高,Oh My Pi 17 个,Claude Code、Codex、Deep Agents 各 16 个,Prime Agent 与 Hermes Agent 各 15 个,OpenCode 14 个最低。 每成功任务成本。 按当前 API 费率估算,Pi Agent 为 0.028 美元最低,Deep Agents 0.045 美元,Hermes Agent 0.056 美元,OpenCode 0.073 美元,Codex 0.081 美元,Oh My Pi 0.103 美元,Prime Agent 0.131 美元,Claude Code 0.195 美元最高,首尾相差约 7 倍。 中位完成时间。 Claude Code 122.7 秒最快,OpenCode 129.7 秒,Pi Agent 132.2 秒,Hermes Agent 175.5 秒,Deep Agents 187.1 秒,Prime Agent 242.1 秒,Codex 245.0 秒,Oh My Pi 272.4 秒最慢。
三个维度没有同一个最优解:Pi Agent 通过最多且单成功任务最便宜,Claude Code 最快但最贵,OpenCode 通过最少。
为什么差异这么大:工具链本身驱动成本
Composio 与社区给出的解释指向工具链的工程细节。Pi Agent 是刻意极简的设计,默认只有 4 个工具(读写、编辑、执行),工具定义少意味着上下文占用少;它原生支持 DeepSeek 模型,且上下文采用只追加方式保持稳定,最大化 DeepSeek 前缀缓存的命中,开发者实测命中率约 99.93%,重复上下文基本被复用而不是重算。这是成本差距的主要来源。
反例是 Claude Code:它是 8 个工具链中最贵的,但工具调用次数和输出 token 数都最少。这说明成本不由 token 量单一决定,工具链如何管理上下文、如何与模型提供方的缓存机制配合,直接反映在账单上。
启示与边界
对选型团队,这次评测的实际启示是:决定成本的变量在工具链层,选模型之外还要选工具链,并且要按自己的任务集实测组合效果。数据层面需要注意边界:这是 Composio 单方测试,样本是 30 个任务,完整 prompts 未公开;成本按当前 API 费率估算,而 DeepSeek 已于 8 月 6 日宣布上调 API 定价,绝对美元数字具有时效性;Prime Agent 的 6 个未评分运行也会影响排名口径。它适合作为选型起点,不宜当作跨场景的权威结论。
结论:按用户类型选,并守住边界
按这次评测的数据,选型建议可以按用户类型拆开。
- 成本敏感的用户,Pi Agent 是首选:它在 8 个工具链中通过任务最多、每成功任务成本最低,两个维度同时占优。不建议初学者使用,因为没有内置的权限控制相关的组件,如果AI能力不强或者语义有问题可能会导致一些不可逆的后果。
- 速度敏感的用户,Claude Code 中位耗时最短,但它是成本最高的选项,约是 Pi Agent 的 7 倍,需要在速度与成本之间做取舍。
- 折中的平衡选项是 Deep Agents,通过率、成本与速度都处于中位区间。
- OpenCode 是一个反向提醒:它便宜且较快,但通过率垫底,说明低成本与高效率的组合,也要先过成功率这一关。
决定成本的变量在工具链层:选模型之外还要选工具链,并按自己的任务集实测组合效果。数据层面需要注意边界:这是 Composio 单方测试,样本是 30 个任务,完整 prompts 未公开;成本按当前 API 费率估算,而 DeepSeek 已于 8 月 6 日宣布上调 API 定价,绝对美元数字具有时效性;Prime Agent 的 6 个未评分运行也会影响排名口径。这些结论适合作为选型起点,不宜当作跨场景的权威结论。
 AI 速览