在 DeepSeek 涨价预期下,各类宣称大幅削减 Token 消耗的 Skill 工具集中涌现,65% 降幅、节省 70 倍等宣传数据极具吸引力。 为验证真实效果,有人针对 Caveman、Ponytail、Headroom 等六款主流省 Token Skill 开展全量实测,结果显示这类工具的省钱效果高度依赖场景,简单规则类任务确有实效,但复杂创意任务中,额外的推理开销反而会让总成本不降反升。
一、六款工具核心逻辑:路径不同,宣传降幅悬殊
六款 Skill 的优化方向差异极大,覆盖输入压缩、输出精简、缓存复用、知识图谱等多个维度,宣称的节省幅度从 50% 到 70 倍不等。
- Caveman:精简模型输出话术,删除寒暄、铺垫、重复总结,仅保留结论与代码,宣称输出 Token 减少 65%。
- Ponytail:编码前优先复用标准库、原生能力与已有依赖,避免重复造轮子,宣称代码行数可减少 92%-94%。
- Headroom:选择性压缩上下文,冗余日志、重复代码本地暂存,按需调取,宣称可省 60%-95% 输入 Token。
- Graphify:提前将代码仓库解析为本地知识图谱,后续查询直接读图谱,宣称单查询可省 70 倍 Token。
- Codex Token Skills:将固定规则前置,命中上下文缓存降低输入单价,宣称节省 60%-80%。
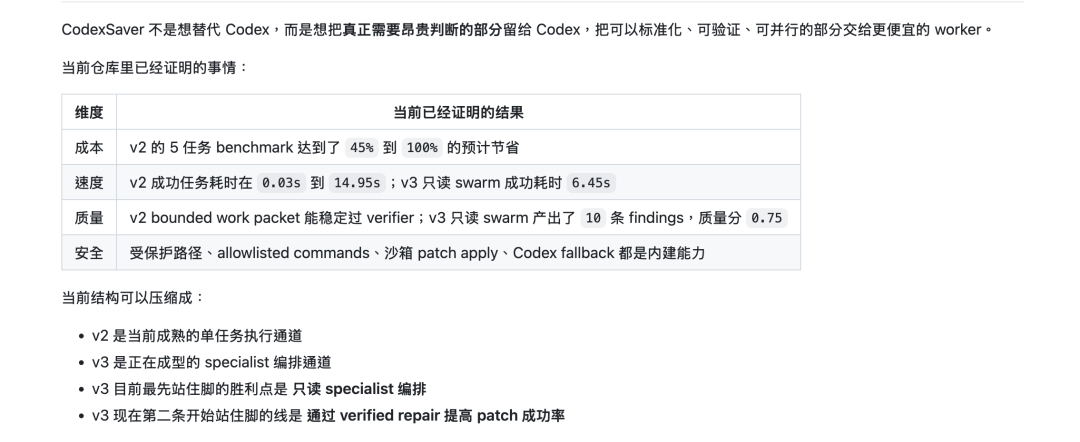
- Codex Token Saver:极致精简输出,非必要不读文件、不测试、不重试,宣称节省 50%-80%。
二、分场景实测:简单任务有效,实际效果与宣传存偏差
单独场景测试显示,匹配对应需求时,部分工具确实能降低 Token 消耗,但多数达不到宣传幅度,甚至出现反向效果。
在长日志、冗余代码等输入臃肿的场景中,Headroom表现最优,可将 1.6 万 Token 的输入压缩至 8500 左右,降幅约 48%,同时还能提升答案完整度;但输入本身简洁时则完全无效。
在代码开发场景中,Ponytail可减少约 30% 的代码量,砍掉冗余函数与重复样式,功能不受影响;但其宣传的 94% 降幅为代码行数指标,并非 Token 降幅,存在概念混淆。
Caveman在创意类任务中反而增加了 15% 以上的 Token,因为自身规则就要占用上千输入 Token,且无多余话术可删;但意外提升了输出稳定性与画面还原度。
Graphify的 70 倍降幅为特定旧项目单查询数据,实测 79 文件仓库中仅能省 3.56 倍,且建图需消耗 3 万 Token,累计查询 36 次以上才能回本,一次性项目反而更贵。
Codex Token Saver压缩率最高可达 70%,但会牺牲细节质量,比如将独立设计的角色合并为通用模板,只保留基础交互。
三、统一场景验证:复杂任务全量增费,推理 Token 成核心开销
为公平对比,测试统一使用电影感世界杯网页制作题目,由 GPT 与 Claude 盲评质量,结果出乎意料:六款 Skill 无一省钱,成本最低增加 33.5%,最高增加 222.8%;但输出质量全部持平或提升,无一款出现效果下降。 成本上涨的核心原因是推理 Token(thinking)开销激增。无 Skill 时推理 Token 占比约 40%,加装 Codex Token Skills 后升至 65%,新增开销中 96% 都来自模型的思考过程。每条约束规则都会让模型额外花费算力协调规则与目标,规则越复杂,思考成本越高,输入输出端节省的 Token 会被推理成本完全吞噬,甚至超额溢出。
这也揭示了这类工具的本质:它们并非单纯的省钱工具,而是输出约束与质量管控工具,精简输出、规范逻辑的同时,会推高推理侧的成本。
四、选型建议:按需匹配,勿迷信宣传数字
省 Token Skill 并非万能,是否加装完全取决于使用场景,不能一概而论。
日常规则明确、对创意要求低的重复性任务,推荐保留Ponytail与Headroom,前者减少无效代码,后者压缩冗余输入,确实能降低综合成本;
长期高频查询的大型代码仓库,Graphify 可逐步摊薄建图成本,适合长期维护的项目。
创意类、复杂设计类、高要求的开发任务,不建议为了省钱加装过多省 Token 工具,不仅难以降本,还可能因规则约束偏离需求。
对这类场景而言,输出质量与稳定性的提升,才是这类工具的真正价值。 整体来看,随着推理模型普及,AI 成本重心正在从输出侧转向思考侧,单纯压缩输出已无法主导总成本,正确认知成本结构,才能真正实现效率与成本的平衡。
 AI 速览