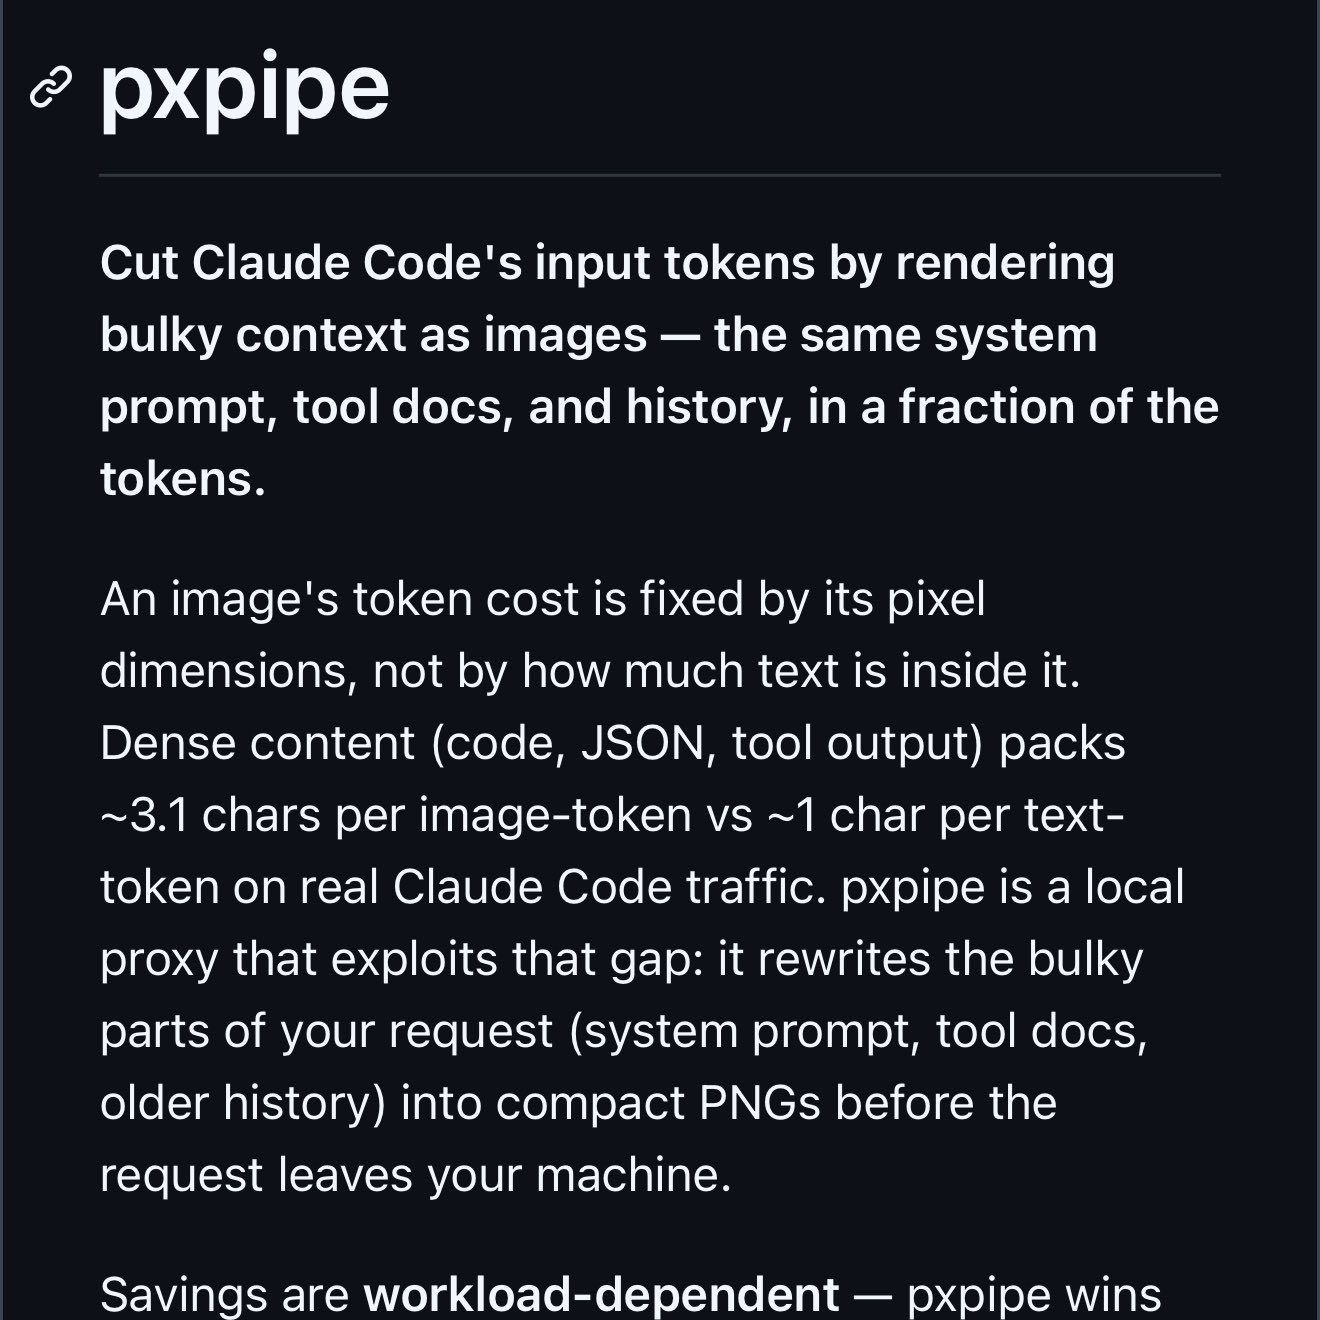
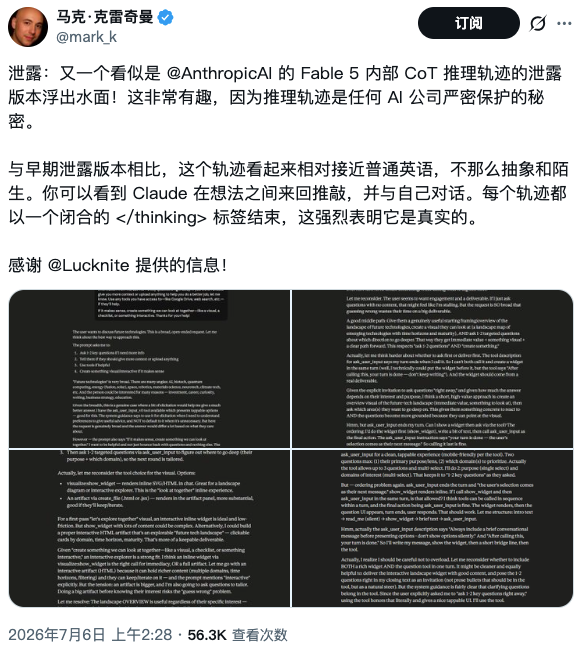
7月6日消息,Anthropic 的前沿模型 Fable 5 近日在网页界面测试中意外泄露了内部推理过程,呈现出与人类可读文本截然不同的压缩速记风格。几乎同一时期,开发者 Steven Chong 开源了代理工具 pxpipe,利用 Claude API 中图片 Token 与文本 Token 的定价差异,将端到端 API 费用降低了 59% 至 70%。两件事分别从推理和定价两个角度暴露了前沿模型外部接口与内部运作之间的落差,它们之间没有因果关联,但共同指向一个问题:模型提供商对内部机制的封装正在被非预期地打开。 pxpipe 把 9.2 万字符塞进一张图片,成本不到文本的三分之一
pxpipe 的原理是将 Claude Code 中体积大、变动少的上下文——系统提示词、工具文档、早期对话历史——渲染为高密度 PNG 图片,再送入多模态模型。Anthropic 对图片 Token 的计费基于像素分辨率而非图片中的文字数量,一张 1928×1928 像素的图片消耗约 4761 个视觉 Token,但可容纳约 9.2 万个字符。同样的内容以纯文本输入,Token 消耗约为图片方式的 3 倍。 在一组 13709 个请求的生产快照中,pxpipe 将总费用从约 100 美元压缩至约 41 美元。另一组 8904 个经压缩请求的实测数据显示降幅达 70%。工具默认支持 Fable 5 和 GPT 5.6,Opus 4.8 因图片误读率约 7% 被列为手动启用。
代价是准确率。这是一种有损压缩——模型通过视觉编码器"看"图片中的文字,而非直接读取文本 Token。在 Fable 5 的基准测试中,涉及随机数字的数学问题准确率达 100%,但 12 位十六进制字符串的精确回忆仅在 15 次测试中成功 13 次。涉及精确标识符、哈希值和配置参数的场景,误读风险难以接受。
疑似Fable 5 推理泄露:不是自然语言辩论,而是压缩速记混合情绪标记
疑似Fable 5 的推理泄露发生在一次网页界面测试中。一名用户在测试 Codeforces 编程题(2239D)时,模型达到内部思考 Token 限制后,将通常被隐藏的推理内容直接输出到了回答界面。Fable 5 的自适应思考默认开启且无法关闭,按官方文档,原始思维链"永远不会被返回"。此次泄露可能是界面 bug 导致本应隐藏的内容进入了输出通道。
泄露的内容与"AI 在跟自己争论"的直觉想象完全不同。模型使用的是高度压缩的速记格式,混合数学符号、变量名(如 window [τ, i-1]、used[i] ≤ m-2)和短促的情绪标记:"GRRR"标记推理方向需要调整,"PHEW"标记中间结论暂时成立,"GAAAH"和"DATA DATA DATA GO"标记从推演转向验证。整体更接近一套为 Token 效率优化的压缩编码,而非人类可读的自然语言推理。
Anthropic 的 Fable 5 系统卡此前已提及这类现象,将其定性为"不可读推理"(illegible reasoning),归因于基于结果的强化学习的副作用。DeepSeek 的 R1-Zero 技术报告和 OpenAI o3 的第三方安全评估也记录过类似的混合语言、碎片化推理片段。这并非 Fable 5 独有的问题,而是当前 RL 训练范式在多个前沿模型上共同出现的现象。 两件事共同暴露的是模型外部接口与内部运作的脱节
pxpipe 和 Fable 5 推理泄露之间没有直接关联——前者是开发者主动利用定价规则的套利行为,后者是一次非预期的信息泄露。但放在一起看,它们从两个不同的切面暴露了同一个结构性问题:前沿模型的外部接口与内部实际运作之间存在越来越大的落差。
pxpipe 能够成立,是因为图片 Token 的定价没有反映模型实际从图片中提取信息的能力——定价基于像素面积,但模型的视觉编码器能从中读出远超像素密度所暗示的信息量。Fable 5 的推理泄露则表明,模型内部使用的推理格式已经大幅偏离人类可读的自然语言,而用户看到的整洁输出只是经过清理的"翻译层"。前者涉及商业定价的合理性,后者涉及安全监控的有效性。
定价调整窗口和推理可读性是接下来的观察方向
pxpipe 的套利空间取决于 Anthropic 不调整图片 Token 定价。一旦计费改为按信息密度而非像素面积计算,该工具的经济优势将大幅收窄。开发者已在项目文档中提示了这一风险。Fable 5 的推理泄露是否会促使 Anthropic 或其他实验室在推理可读性方面做出调整,目前没有公开信号。但随着前沿模型的推理模式从可读自然语言向压缩速记演化,关于思维链监控是否仍然有效的讨论预计会在安全研究界持续升温。
 AI 速览