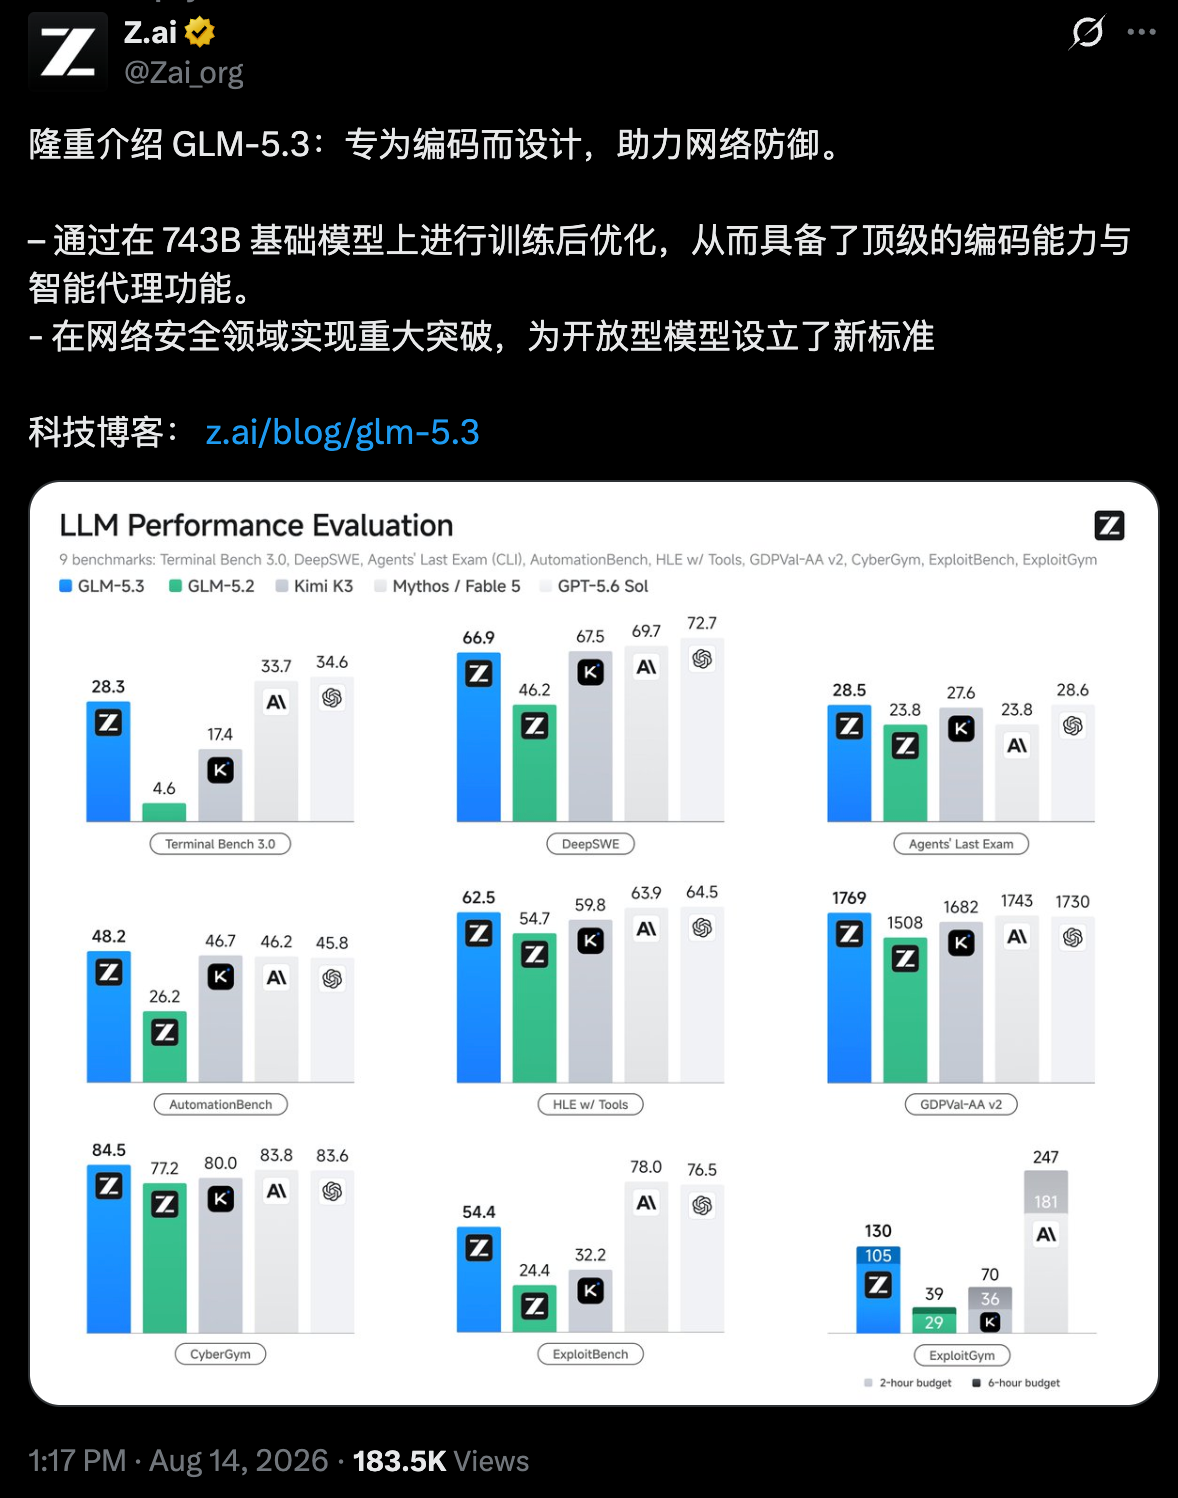
8月14日消息,智谱 AI(Z.ai)发布 GLM-5.3。官方博客称,GLM-5.3 的基座模型与 GLM-5.2 完全相同(743B 参数),全部能力提升来自极致的后训练 Scaling——数十倍的长程任务环境、更丰富的环境类型与超长的后训练时间。官方表示,模型权重将在发布两周后开放,此前需完成安全评估与模型加固。 编程能力:公开基准开源第一,接近 Claude Fable 5
GLM-5.3 的编程能力是本次发布的主线。官方称其"是编程能力最强的开源模型",在内部自建评测中较 GLM-5.2 提升 50%。在公开基准上,Terminal-Bench 3.0 从 4.6 升至 28.3,DeepSWE v1.1(长程软件工程)从 46.2 升至 66.9,Agents' Last Exam 从 23.8 升至 28.5,GDPval-AA v2 得分为 1769。官方称其编程与智能体能力接近 Claude Fable 5,编程体感超过其他国产模型。
在自研的 Z.ai Code Bench 评测中,模型被置于复杂本地开发环境执行端到端任务。High 档位下 GLM-5.3 达到 31.4% 的准确率,超过 Claude Opus 4.8 最高档位的 29.5%;每项任务平均输出约 5 万 tokens,而 Opus 4.8 需要约 12 万 tokens。需要说明的是,Code Bench 为智谱自研评测,非第三方基准。
涌现的网络安全能力:前段领先,后段仍落后闭源
网络安全是 GLM-5.3 区别于前代的新能力。官方将安全能力描述为"约束严格的编程能力"的自然延伸,从 2025年9月开始投入研究,与国内多家头部安全实验室合作构建长程任务环境。三个基准呈现一致趋势:越接近漏洞利用链的前端,GLM-5.3 相对 5.2 的提升越明显;越深入完整利用,与闭源前沿模型的差距越大。
在 CyberGym(从白盒源码触发程序故障识别漏洞)上,GLM-5.3 得分为 84.5%,高于 GLM-5.2 的 77.2%,也略高于 Mythos 5 的 83.8% 与 GPT-5.6 Sol 的 83.6%。在更考验深度推理的 ExploitBench(理解漏洞成因并完成利用)上,GLM-5.3 得分为 54.4%,是 GLM-5.2(24.4%)的两倍多,但仍低于 Mythos 5 的 78.0% 与 GPT-5.6 Sol 的 76.5%。官方将这一能力定位为面向网络安全防御场景,同时承认"进步最快的方向,正是当前仍需要重点追赶的方向"。
安全评估与"开源的盾"计划
围绕安全能力,智谱披露了配套的安全评估与开源计划。官方称,自 GLM-5.2 发布以来,联合清华大学、南开大学及云起无垠、绿盟科技、赛博昆仑、DARKNAVY、腾讯玄武等多家安全团队开展红队测试,累计发现漏洞 2,436 个(其中 1,097 个中高危),覆盖 269 个项目,部分漏洞最早可追溯至约 45 年前;参考全球漏洞交易与赏金市场公开报价,这些漏洞创造的经济价值约 3,000 万元。相关漏洞已陆续提交 CNNVD/CNVD 国家漏洞库,并建立 Z.ai 安全披露账本。
智谱同步启动"开源的盾"计划:对重点开源项目开展持续安全审计、向开源社区免费提供模型额度与防御入口、在 ZCode 中提供代码审计功能。官方在博客中引用 Hugging Face 安全事件作为背景,主张"当最强的矛被锁在少数人手里,最好的盾必须属于所有人"——Anthropic 向约 150 家大型机构提供 Mythos 模型及安全服务,而更广泛的企业和开源项目难以获得同等水平的安全能力支持。
分层风险审查与受信访问
针对开源权重场景,智谱为 GLM-5.3 构建了分层风险审查系统:外层分类器标记并拦截大规模滥用请求,推理监控器在推理过程中实时审查任务意图,深度安全对齐让模型自主识别并拒绝攻击性请求。官方称,系统以意图为中心而非关键词为中心进行审查,因为网络安全场景中攻击与防御任务在字面上高度相似,真正区分二者的是意图与语境。
审查系统按风险分级处理:安全知识问答、蓝队防御、CTF 题目、漏洞挖掘与修复等低风险任务正常支持,漏洞利用、渗透测试、真实入侵等高风险任务被拦截。模型最敏感的能力仅通过"网络安全受信访问"计划保留给经过验证的用户。官方称,DARKNAVY 团队评估认为该模型在风险防护与能力释放之间取得良好平衡。
可用性与开源时间
GLM-5.3 即日起上线智谱官方编程工具 ZCode、效率工具 AutoClaw,并向 GLM Coding Plan 全量用户开放订阅;TraeWork/TraeCode、扣子、WorkBuddy/CodeBuddy、Qoder/QwenWork、CatPaw、JoyCode、OpenCode 等编码平台开放抢先体验。API 很快上线,完整模型权重将在两周内开源,此前需完成必要的安全加固,以尽可能限制其潜在攻击能力、保留其防御价值。今天 13:00,GLM Coding Plan 全员额度重置。 观察:后训练路线与开源安全叙事的双重验证
GLM-5.3 最值得注意的一点,是它证明了后训练 Scaling 的路径:基座模型与 GLM-5.2 完全相同,所有能力提升来自后训练。智谱用更低的成本(不重新预训练)实现了编程能力的代际提升,也为"充分的后训练能涌现超出预期的能力"提供了例证。
安全能力则是另一个叙事层面。智谱把网络安全能力定义为防御导向,并用 2,436 个漏洞、3,000 万元经济价值的安全评估数据支撑"开源之盾"的主张——这既是对 Anthropic Mythos 闭源安全服务模式的直接回应,也是开源模型在安全能力上的差异化尝试。但边界仍然清楚:漏洞利用链的后段(ExploitBench 54.4% vs Mythos 5 的 78.0%)仍与闭源有明确差距,权重也尚未开放,官方自测基准仍需第三方复测。GLM-5.3 是编程最强的开源模型、安全能力有真实进展,还是"全面超越闭源",两者不能混为一谈。
 AI 速览