传统搜索引擎的逻辑,是帮你找"网页",可你真正想要的,往往是"过去30天里,真实用户到底在讨论什么"。这中间的落差,就是last30days-skill存在的理由。让 AI Agent 替你同时"刷"遍全网,按真实互动数据排序,生成一份带来源的研究摘要。
last30days-skill 到底是什么
这是 GitHub 上一个开源项目,作者是 Matt Van Horn(此前参与创立过 Lyft 前身公司,以及自动做饭机器人项目 June)。截至目前,仓库星标已经接近 6 万,fork 数超过 5 千,由 51 位贡献者共同维护,采用 MIT 协议——比它今年三月刚登上 GitHub Trending 榜首时的数据翻了好几倍,说明这东西不是昙花一现的玩具项目。
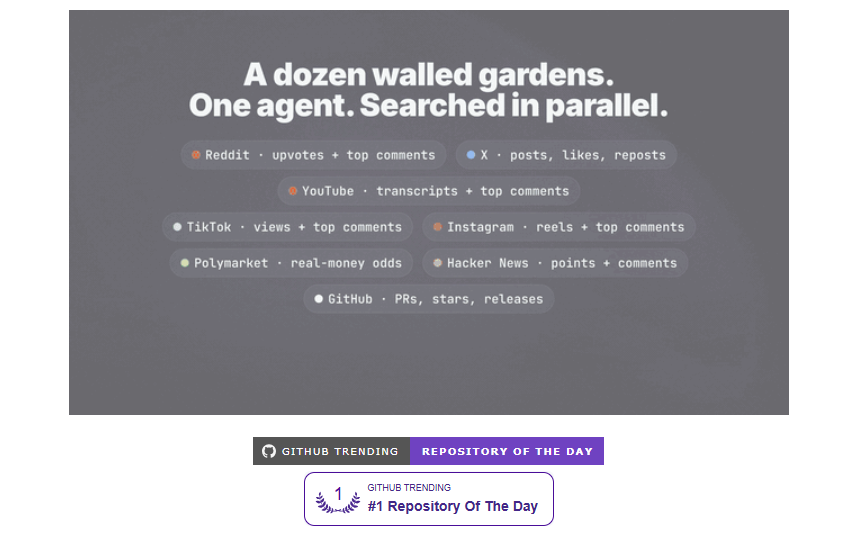
它本质上是一个 AI Agent Skill(技能插件)。给它一个主题,比如"Cursor IDE"或者"AI video tools",它会同时跑去这些地方抓过去30天的讨论:
- X(Twitter)——行业大V和开发者的即时反应
- Hacker News——硅谷技术圈相对硬核的讨论
- Polymarket——预测市场赔率,某种程度上反映的是市场共识
- 再加上 TikTok、Instagram、Bluesky、Truth Social 等新兴平台和普通网页
抓回来之后不是按编辑推荐排序,而是按 Reddit 点赞数、X 的 likes、YouTube 播放量、Polymarket 赔率这些真实互动数据来排,谁热度高谁靠前。
和传统搜索的差别在哪
传统搜索按"相关性"排序,但这个相关性是搜索引擎自己定义的,不是你定义的。举个例子,你想了解"OpenClaw"这个框架,普通搜索会甩给你官网、文档、几年前的采访稿——可你其实想知道的是,最近开发者在 Reddit 和 X 上怎么吐槽它、HN 上有没有人踩过坑、YouTube 上是不是出了新教程。
这个项目聪明的地方在于智能查询扩展。你输进去"OpenClaw",它不会只搜这一个词,而是自动去推断关联信息——创始人是谁、主仓库叫什么、对应哪个 Reddit 版块、官方 X 账号是什么——统统纳入搜索范围。所以哪怕有人发帖时只写了创始人的名字,没提产品名,这条讨论也不会被漏掉。
last30days怎么安装
前提是你已经有 OpenClaw 框架,或者 Claude Code、Cursor 这类支持 Skill 的 AI 环境。最省心的方式是用 Claude Code 的插件市场,能自动更新: 想强制检查更新,跑 claude plugin update last30days@last30days-skill 就行。也可以走通用的 skills 安装路径: | |
|---|
| npx skills add mvanhorn/last30days-skill -g |
| npx skills add mvanhorn/last30days-skill -g -a codex |
| npx skills add mvanhorn/last30days-skill -g -a codex -a cursor |
| npx skills update last30days -g |
| |
| npx skills remove last30days -g |
嫌麻烦的话,直接把 GitHub 链接甩给你的 Agent,说"帮我装好这个项目",它会自己搞定安装,遇到问题也会自己排查解决。装完之后在对话里直接用:
能拿来干什么
技术选型上,与其去 Google 搜"best AI video tools 2026"被一堆 SEO 软文轰炸,不如直接 /last30days AI video tools,它会去 Reddit 的 r/VideoEditing、X 上的 #AIVideo 话题、YouTube 最新评测、HN 讨论里综合真实反馈——比如"Runway 最近口碑下滑""HeyGen 的 lip-sync 被吐槽最多"这类具体信息,而不是笼统的推荐列表。
竞品监控也很顺手。不用每周手动刷一遍对手的社交媒体,设个定时任务周一早上自动跑 /last30days 竞品名,直接出一份过去七天的动态摘要,用户吐槽、新功能反馈、市场情绪变化都在里面。
投资研究是另一个方向。Polymarket 赔率反映的是市场共识,配合 Reddit 和 X 的情绪分析,能看到比单纯看K线更立体的画面,比如查 /last30days bitcoin ETF approval sentiment。
提示词参考:
中文用户怎么办
适合什么人用也挺明确:需要频繁做技术调研的开发者和产品经理,关注行业趋势的创业者投资人,做竞品分析的市场人员,还有单纯不想被信息噪音淹没的效率控。反过来,如果你只想快速得到一个简单答案,传统搜索反而更快;而且它需要申请 Reddit、X 等平台的 API 密钥,数据本身也有一两个小时的缓存,对实时性要求极高的场景不太适合。
信息分散在太多平台、手动收集成本太高,是个具体又普遍的问题。这个项目没去做新的搜索引擎,而是让 AI Agent 同时"看"十几个平台,按真实互动数据排序生成摘要——这种跨平台情报整合的思路,往后大概率会越来越常见。
 AI 速览