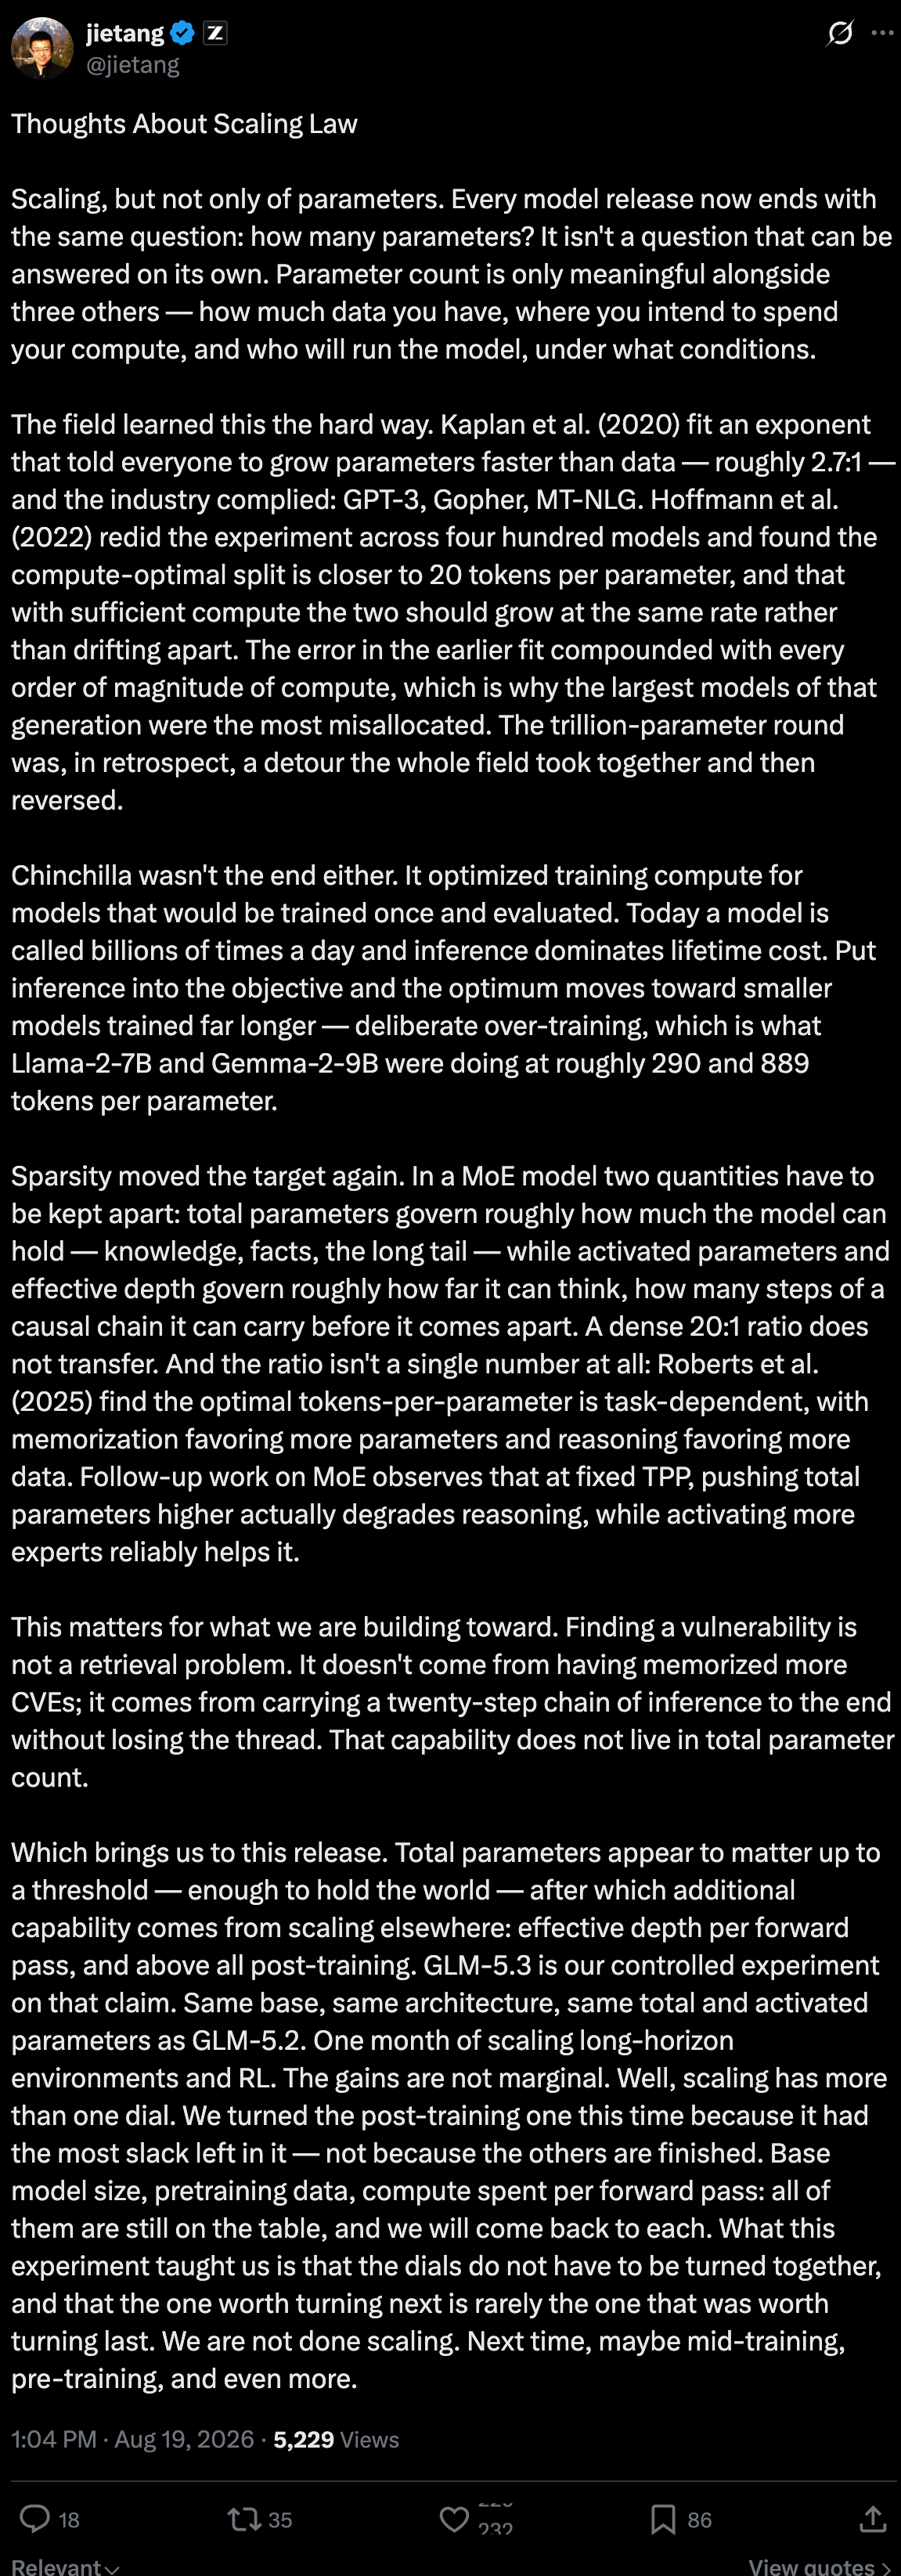
8月19日消息,智谱 AI 创始人唐杰今日在社交平台发表长文《关于 Scaling Law 的思考》,系统回顾了大模型 Scaling Law 五年来的认知演变,并透露 GLM-5.3 已在基础架构、总参数量及激活参数量与 GLM-5.2 完全一致的前提下完成更新,仅通过一个月的长时序场景与 RL 优化实现能力提升。这一"参数不动、训练优化"的路径,被视为对大模型"参数军备竞赛"路线的公开反思。
从 2.7:1 到 20:1:参数增长神话的两次修正
唐杰在文中指出,模型发布面临的核心问题从来不是孤立的参数规模,而是"参数量、数据量、计算投入、运行条件"三者的匹配。他回顾称,Kaplan 等人(2020 年)曾提出参数增速应快于数据增速约 2.7:1 的指数关系,GPT-3、Gopher、MT-NLG 等一代模型均按此标准开发;而 Hoffmann 等人(2022 年)对 400 个模型的重新测试发现,最理想的参数与 token 比例约为 20:1——早期模型的参数规模被严重高估,"万亿参数那一轮的尝试,回过头看其实是整个领域共同走过、又一起回头修正的一段弯路"。
推理成本倒逼"过度训练",MoE 稀疏度改写规则
文章进一步指出,如今模型每天被调用数十亿次,推理过程占据了整个生命周期的大部分成本,最优方案已从"训大模型"转向"选更小的模型、进行更长时间的训练",Llama-2-7B 与 Gemma-2-9B 即为这一策略的代表,每个参数对应的 token 数分别高达 290 和 889。
在 MoE(混合专家)架构上,唐杰强调参数稀疏度再次改变了模型表现逻辑:总参数量决定模型能存储多少知识,而激活参数量与有效深度决定推理能走多深。他援引 Roberts 等人(2025 年)的发现称,20:1 并非固定数值——记忆类任务需要更多参数,推理类任务则需要更多数据;MoE 后续研究还表明,在 token 与参数比固定的情况下,一味推高总参数量反而会损害推理能力,而激活更多专家节点则能可靠地提升推理性能。
GLM-5.3:一次"参数不变"的实验
这一思考直接指向实际业务目标。唐杰表示,发现漏洞并非简单的检索任务——不是记住更多 CVE 信息,而是需要通过二十步的推理过程完整推导且不失思路,这种能力与参数总数量并无直接关联。
基于此,GLM-5.3 成为这一观点的实验载体:基础架构、总参数量与激活参数量均与 GLM-5.2 相同,团队用一个月时间针对长时序场景及 RL 相关功能进行优化。唐杰强调,此次提升"并不微小"(The gains are not marginal),选择优化训练后参数是因为这部分仍有最大优化空间,而并非其他方向已经完成——基础模型规模、预训练数据量、每次前向传播的计算资源等因素仍在考虑范围内,后续将逐一调整。
"并非所有参数都需要同时调整,而且接下来需要调整的参数,往往并非上次就应该调整的那些。"唐杰在文末写道,团队下一步或将在训练过程中、甚至预训练阶段进行调整,"我们的优化工作还远未完成。"
行业观察:参数不变、能力进化将成为行业常态
chooseAI认为头部大模型公司对标度律的理解正从"规模崇拜"转向"结构优化"。当推理成本取代训练成本成为主要负担、推理深度取代知识容量成为竞争焦点,"参数不变、能力进化"或将成为下一代模型迭代的常态,而非例外。
 AI 速览