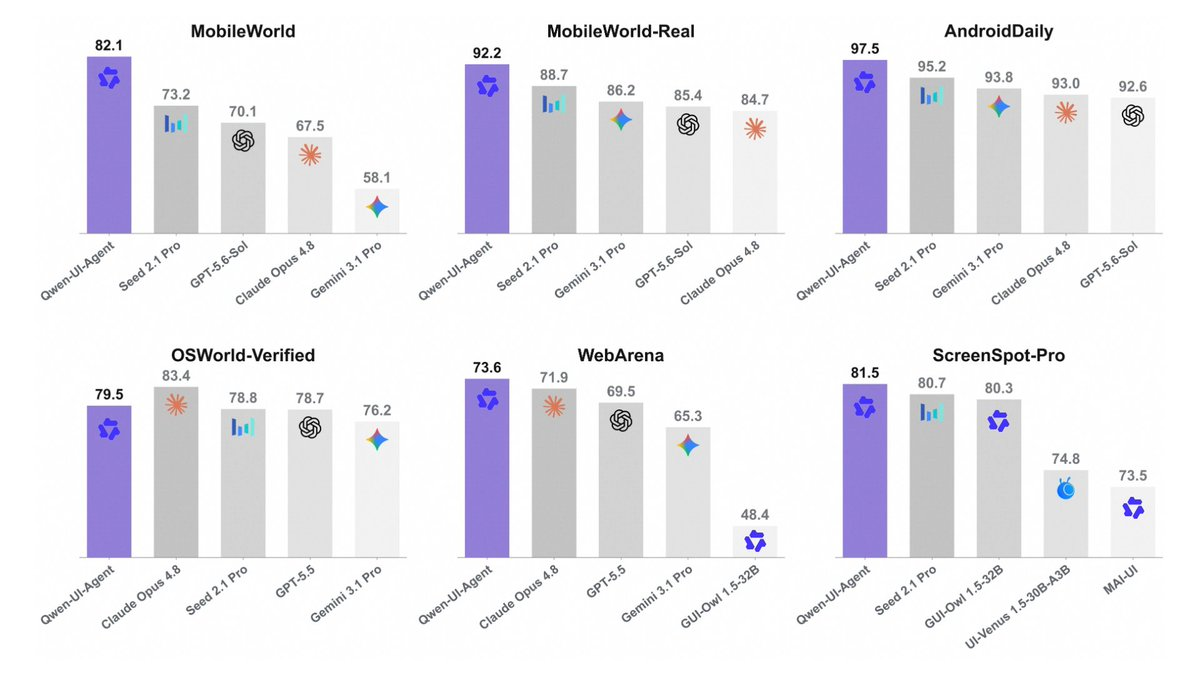
8月20日消息,通义千问发布 GUI 代理基础模型 Qwen-UI-Agent,以真实世界为中心,覆盖移动端、电脑端、网页端与深度搜索(DeepSearch)环境。官方称,GUI 依然是数字世界最广泛、最通用的交互入口,只要界面存在,智能体就能上手操作。公开成绩中,MobileWorld-Real 达 92.2%(超 Gemini 3.1 Pro 的 86.2),WebArena 73.6%(对比模型第一),OSWorld-Verified 79.5%(领先 GPT-5.5 的 76.2,该榜最高分为 Claude Opus 4.8 的 83.4)。 成绩:从移动端到网页的分层领先
按官方技术报告与发布公告,Qwen-UI-Agent 的成绩按场景分层。移动端:MobileWorld 82.1%,分别领先 GPT-5.6 Sol、Claude Opus 4.8、Seed 2.1 Pro 12.0、14.6、8.9 个百分点;真机基准 MobileWorld-Real 92.2%,超越 Gemini 3.1 Pro、Claude Opus 4.8、GPT-5.6 Sol 与 Seed 2.1 Pro;AndroidDaily 97.5%,接近满分。 电脑端:OSWorld-Verified 79.5%,超越 GPT-5.5、Gemini 3.1 Pro、Seed 2.1 Pro(该榜 Claude Opus 4.8 为 83.4,仍高于本模型);OSWorld-v2 部分分为 40.0%,相比基线节省 58% 执行步数。
浏览器与 DeepSearch:WebArena 73.6%,位列所有对比模型第一;BrowseComp-ZH 75.0%。GUI 定位(Grounding):ScreenSpot-Pro 81.5%,其余 4 个 grounding 评测基准全部刷新 SOTA。官方称,模型在通用与 Agentic 能力上保持或超越训练基座,并在这两类任务上大幅领先 GUI 专用模型。
这些成绩为厂商自测或自建基准口径,尚缺第三方独立评测。
安全边界:知道何时停手
官方把安全设计作为模型能力的一部分:面对违法或高风险请求,模型不执行任何界面操作,直接拒绝并终止任务;面对支付、数据删除、隐私授权等敏感场景,则在关键步骤主动停手,向用户说明情况,待获得明确确认后再继续。危险请求不执行,敏感操作不擅自决定。
训练与能力设计:真机、长程 RL、GUI+CLI、数据飞轮
四个技术选择构成模型的底座。其一,真机训练与评测:搭建覆盖 100 多台真实手机、150 多个应用的真机环境,自建 MobileWorld-Real 真机基准(400 多个任务、100 多个应用),打通从模拟到真实的最后一公里。其二,长程在线强化学习:支持 100 步以上的超长轨迹训练,约 1 万个并发环境同时 rollout,配合模型自适应课程学习;官方演示的调研任务总步数达 170 步。其三,GUI+CLI 混合动作空间:除界面操作外,模型直接执行命令行,并支持单次决策批量输出多个动作——电脑任务中 CLI 动作占比近半,约 40% 的动作以批量形式输出。其四,数据飞轮:任务设计、环境构建、验证器开发、数据整理、模型训练、评估与错误分析构成 AI 驱动的迭代闭环,人类从亲自执行转为高层监督与关键节点干预。
从执行器到主动服务
把这次发布放进 Agent 竞争的语境里:GUI 智能体想成为现有数字设备上的通用执行器——只要有界面,就能操作。Qwen-UI-Agent 的官方愿景列出了七种能力:真实设备可靠运行、严守安全边界、跨手机电脑执行个人工作流、GUI 与 CLI 结合、稳定完成长程任务、主动提供个性化服务、在较少人工参与下由 AI 驱动迭代。
前几项能力对应落地最实际的问题:真机训练解决环境真实性,长程强化学习解决任务漂移,GUI+CLI 混合解决执行效率,安全边界解决合规。真正拉开形态差异的是后两项:主动服务(官方演示中,航班取消时模型主动识别受影响的行程、检索备选方案并经确认后执行)把智能体从"等待指令的执行器"变成"主动发现问题的协作者";数据飞轮则让模型能力迭代由 AI 驱动——这与开源社区里"自我改进训练"的路线形成呼应,GUI 代理也在走向自动迭代。
这些判断基于官方公布的数据、训练说明与演示。benchmark 为官方口径,实际表现有待第三方评测与开发者实测;演示场景也不能代表全部真实环境的表现。
 AI 速览