4月2日消息,Liquid AI 近日发布 LFM2.5-350M。这款 3.5 亿参数的模型在完成 28 万亿 Token 的额外预训练后,首次在小规模下实现了智能体循环(Agentic Loops)——包括可靠的数据提取、结构化输出和工具调用,而这些能力在同等参数规模的模型中通常被认为难以实现。量化后模型体积不到 500MB,可在手机、树莓派等边缘设备上流畅运行。
训练策略:数据量提至 2.8 倍,再加 RL
LFM2.5-350M 基于 Liquid 此前的 LIV 混合架构(LIV 卷积 + GQA 注意力),训练路径分为两步。
第一步是将预训练 Token 总量从 LFM2 的 10 万亿提升至 28 万亿。参数不变,数据量翻了近三倍。对于小模型来说,增加预训练数据比增大参数更能提升基础能力——这是近年小模型研究的一个共识。
第二步是大规模强化学习(RL)。这一步专门针对工具调用、指令遵循和数据提取等结构化任务进行了优化,使模型在特定能力上超越了参数规模 2~3 倍的对手。官方明确指出,LFM2.5-350M 不推荐用于知识密集型任务或编程——它不是通用小模型,而是有明确能力边端的专用工具调用和数据结构化引擎。
基准测试:不是所有维度都领先
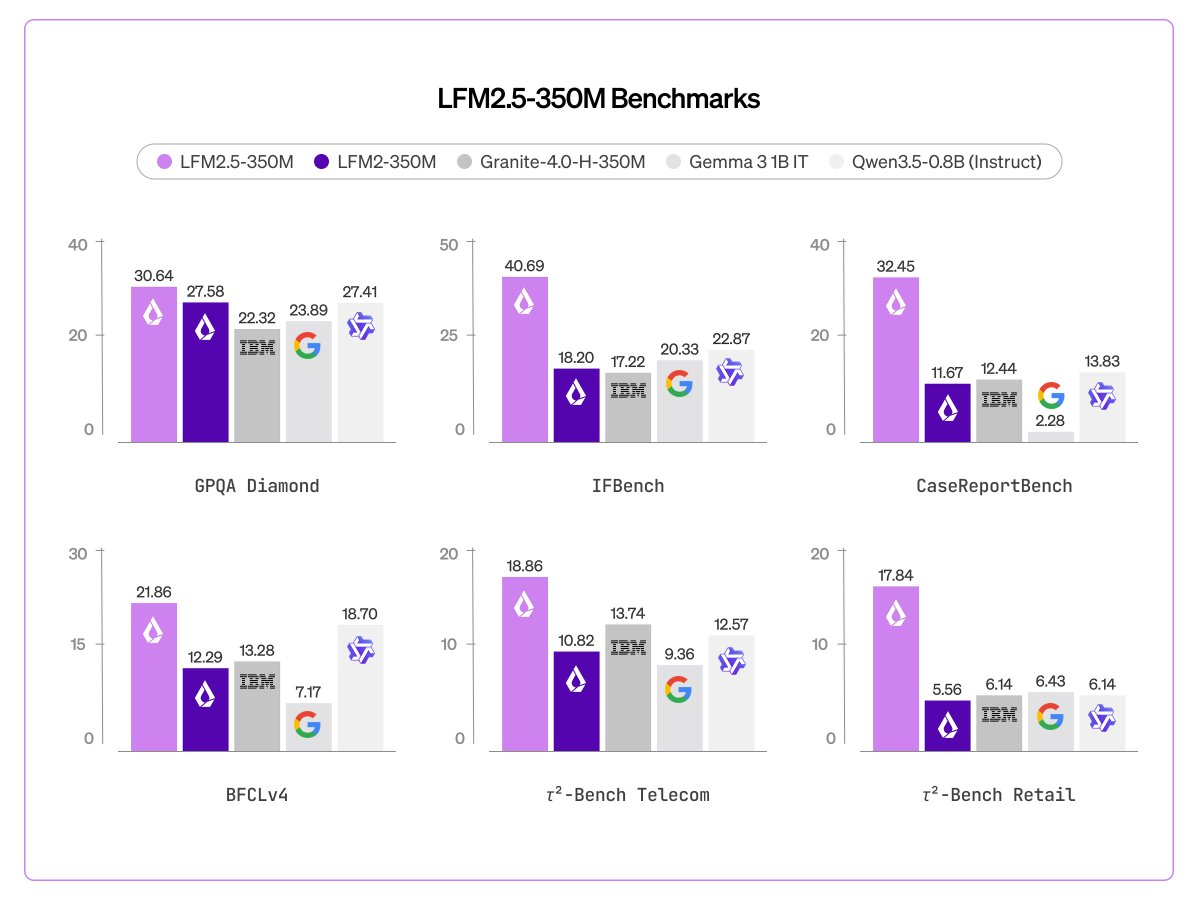
官方公布的 10 个基准测试中,LFM2.5-350M 的核心优势集中在三个方面。
LFM2-350M 在 IFBench 上从上一代的约 13 分提升至 40.69,这是全篇中最显著的单点提升。GPQA Diamond 30.64 分对于 3.5 亿参数模型来说是一个不错的成绩——作为参照,很多 1B 以下模型的 GPQA 成绩在 20~25 区间——但距离 7B+ 模型的 50~70 分仍有巨大差距。
官方对比的基准维度集中在工具调用、指令遵循和数据提取,未公开通用对话、多模态、长文本等维度的成绩。
端侧推理:Snapdragon NPU 上 169MB 内存即可运行
量化版本(GGUF 等)的推理性能是 LFM2.5-350M 最值得关注的卖点之一。
169MB 意味着什么?当前主流旗舰手机的可用内存多在 4~8GB,一个 169MB 的模型可以在不占用显著系统资源的情况下常驻运行——这对于"始终在线"的本地代理场景有实际意义。相比之下,7B 模型即使量化到 Q4 也需要 3~4GB 内存,根本无法在移动端持续运行。
模型在骁龙 8 Elite 上运行于 NPU(而非 CPU),说明 Liquid 与高通在端侧部署方面已有合作。不过解码速度在这款芯片上未公布,Ryzen AI 上的 313 tok/s 则是一个不错的表现。
下载与支持格式
LFM2.5-350M 已在 Hugging Face 开放权重,包括基础版(Base)和指令微调版(Instruct)。支持 llama.cpp、LM Studio、MLX、vLLM、Unsloth 微调等框架,量化格式覆盖 GGUF、ONNX、OpenVINO 及 Apple MLX。
| |
| llama.cpp、LM Studio 等 CPU 推理 |
| Windows/Cross-platform 推理 |
| |
| |
小模型赛道正在变热。Qwen2.5-0.5B、SmolLM2 的 135M~360M、Phi-3-mini 的 3.8B 都在各自的规模区间探索能力上限。LFM2.5-350M 的独特之处在于它明确放弃了"通用小模型"路线——不拼知识、不拼编程,专注工具调用和数据结构化。这意味着 Liquid 看好一个具体场景:端侧智能体(Edge Agent),即不需要联网、不上传数据到云端就能执行工具调用的本地代理。
需要注意的是,350M 参数的能力上限仍然远低于 7B+ 级别,复杂多步推理、需要广泛背景知识的任务不在其射程范围内。官方自己也标注了"不推荐用于知识密集任务和编程"。
 AI 速览