2026 年 8 月 21 日,DeepSeek 正式上线旗下首个多模态 API 模型deepseek-v4-flash-vision-exp,为 V4-Flash 系列补上了视觉感知能力。 不同于行业普遍的多模态单独加价策略,该模型沿用纯文本版定价,单张图片最高仅消耗 384Token,千张图输入成本低至 1 元出头,同时文本与 Agent 能力不降反升,配合同步升级的开发工具链,快速跑通了多模态 Agent 的完整落地链路。
一、能力升级:加视觉不加价 文本表现同步提升
本次推出的多模态实验版模型,核心定位是 “带眼睛的 V4-Flash”,在保留原有 Agent 推理、知识储备等全部文本能力的基础上,新增图像语义理解。
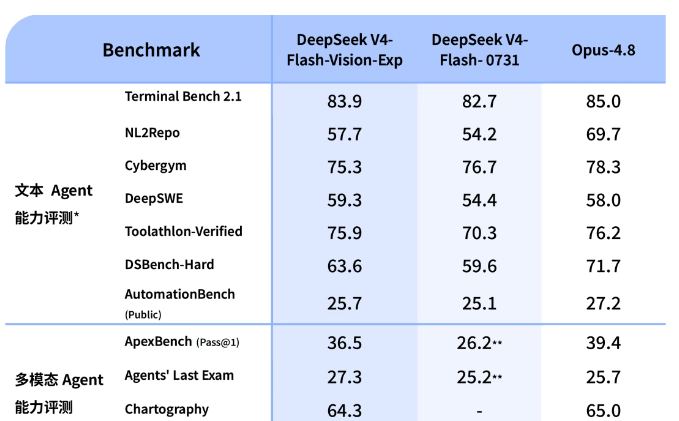
实测数据显示,新增视觉模块后,模型在七项主流 Agent 评测中有六项超越此前的纯文本版本,多模态 Agent 综合表现接近 Opus-4.8 水平,打破了 “多模态会稀释文本能力” 的行业常规认知。
定价策略是本次更新最具冲击力的一点:行业内多模态能力普遍单独计费,图片消耗 Token 数远高于同长度文本;而 DeepSeek 直接将视觉能力纳入原有计费体系,与纯文本 V4-Flash 执行完全相同的价格标准,单张 1024×1024 图片 Token 消耗封顶 384,相当于把多模态能力作为附赠功能开放,大幅降低了开发者的试用门槛。
二、实测验证:不止能识图 更能交付完整成品
实测验证,该模型并非只能做简单的文字识别与元素标注,而是能基于视觉信息完成从理解到产出的全链路任务。
网页 1:1 复刻场景:上传 OpenAI 官网截图,要求输出单文件可运行 HTML,同步完成布局结构分析、色值提取、交互效果还原、响应式适配。模型先逐块拆解页面布局、字体、配色与间距,再生成对应代码,最终成品视觉还原度极高,实现了 “截图转代码” 的端到端交付,省去了人工标注参数的环节。
B 端提案生成场景:输入模糊的业务需求,包含产品定位、风格调性、受众特征等非结构化描述,模型可输出 11 页完整的 B 端合作 PPT。核心信息点无遗漏,风格分寸感精准适配专业受众,没有堆砌行业黑话,成品可直接发给客户,实现了 “一句需求出可落地方案” 的效果。
三、成本碾压:千图成本仅 1 元 重构多模态使用逻辑
成本优势是本次更新的核心竞争力。横向对比来看,同尺寸 1024×1024 的图片,头部模型单图消耗 Token 从 258 到 1334 不等,千图成本折合人民币最高接近 29 元;而 DeepSeek 单图封顶 384Token,配合百万输入 Token3 元的基础定价,千张图的输入成本仅约 1.15 元,低谷时段半价后不到 6 毛钱,成本差距最高可达 50 倍。
成本量级的变化,直接改变了多模态的使用逻辑:高价模式下开发者需要谨慎判断 “这一步要不要看图”,而低成本下 Agent 可以每执行一步就截屏校验,全程通过视觉感知任务进度,大幅提升复杂任务的成功率。此外平台同步开放免费的 Files API,图片一次上传后可通过 file_id 重复引用,无需每次重复计费,进一步降低了设计稿、报表等高频复用场景的成本。
四、生态打通:8 天跑通多模态 Agent 完整链路
本次更新并非孤立的模型上线,而是配合开发工具链完成了全链路补齐。
8 月 13 日 DeepSeek Harness 开源,搭好了 Agent 运行时底座;8 月 21 日多模态模型上线,补齐视觉输入能力;同日 Harness 同步更新 0.1.1 版本,开箱即支持新模型,开发者无需额外修改适配代码。 图片输入支持 base64 内联、外部 URL、Files API 三种方式,覆盖不同开发场景需求。短短 8 天时间,从运行框架到多模态输入的完整链路全部打通,开发者可以快速搭建具备屏幕感知、物料识别能力的 Agent 应用,让 AI 真正具备看懂真实界面、处理视觉信息的能力。
整体而言,DeepSeek 本次更新不止是新增了一项模型能力,更是通过极致的定价与完善的工具链,大幅拉低了多模态 Agent 的落地门槛,推动视觉能力从 “按需调用的增值功能” 走向 “Agent 默认标配的基础能力”。
 AI 速览