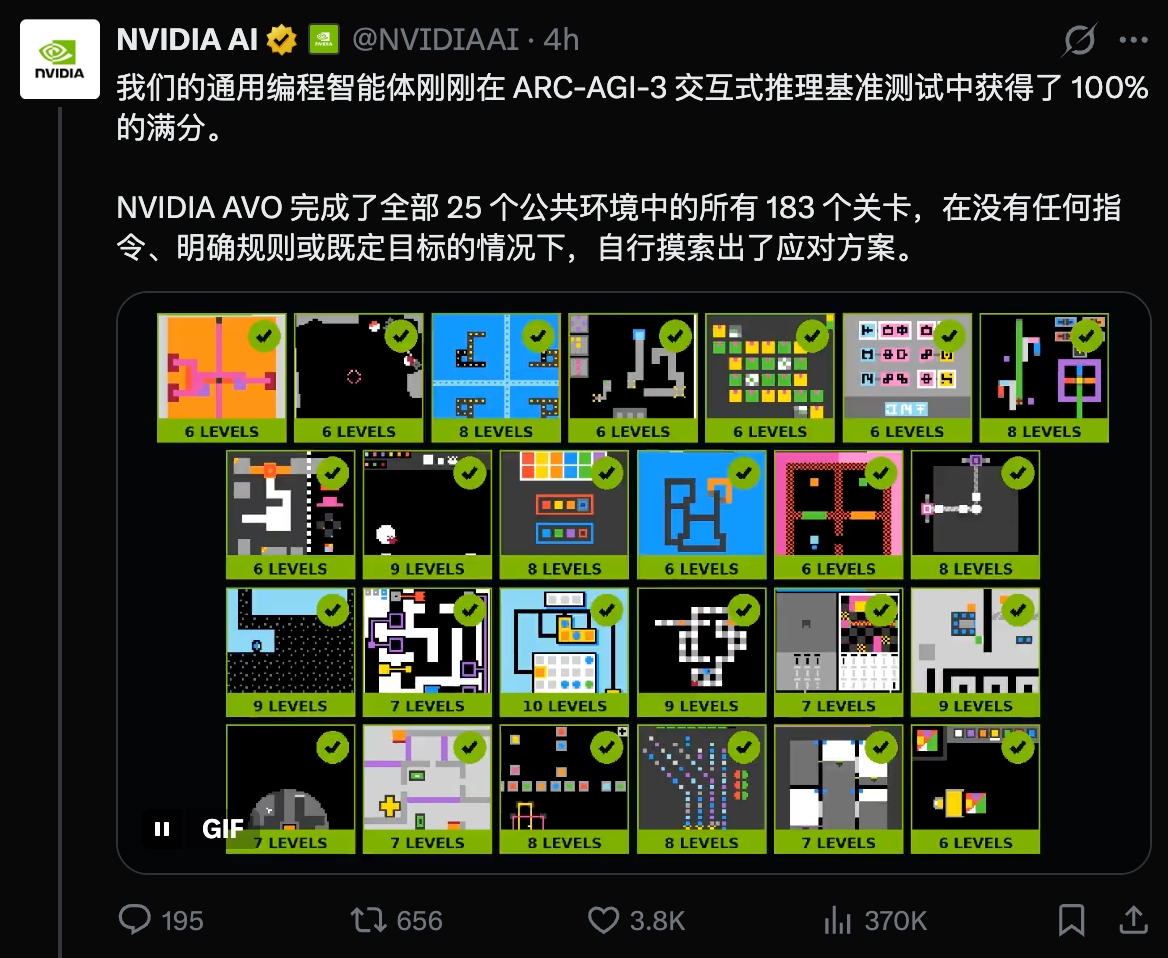
8月22日消息,NVIDIA 发布博客称,其通用智能体架构 AVO(Agentic Variation Operators)在交互式推理基准 ARC-AGI-3 的公共集上取得 100.00 RHAE 满分,完成全部 25 个环境、183 个关卡。底层模型为 Anthropic 的 Claude Opus 5,该模型在此前 ARC Prize 的单独评测中得分约 30%。NVIDIA 强调,把 30% 拉到满分的是系统设计而非模型本身,同时明确这批结果仅覆盖公共集,不代表私有竞赛集的表现。 从优化 GPU 内核长出来的架构
AVO 是 NVIDIA 开发的通用编码智能体系统,此前的主要战场是 GPU 内核优化:在一次注意力内核研究中连续自主运行 7 天,探索超过 500 个优化方向,提交 40 个内核版本,在 DGX B200 上最高比 FlashAttention-4 快 10.5%、比 cuDNN 快 3.5%,随后又用约 30 分钟把演化出的内核自适应到分组查询注意力。
支撑长时程运行的是三组机制:持久记忆把此前的实现、评测结果和推理结论带过单次上下文的边界;监督模块监控整体轨迹,在停滞或无效循环出现时重定向主智能体;主循环则反复执行检查、规划、实现、评估四个步骤,靠工具调用和执行反馈落地。迁移到 ARC-AGI-3 时,这套架构没有重写,只更换了任务接口。
满分的含金量边界
ARC-AGI-3 要求智能体在没有指令、没有规则说明、没有目标提示的情况下进入陌生环境,通过交互推断规则并逐关推进,计分结合完成率与相对人类首次通关的动作效率。AVO 用 6,624 次环境动作完成全部关卡;同样使用 Claude Opus 5 的 VISTA 系统完成相同关卡用了 7,542 次,AVO 少约 12%。但 NVIDIA 自己指出,这不是受控对比——两套系统在后端、观察表示(VISTA 用图像输入,AVO 只接收 64×64 的文本网格)、记忆和上下文管理上都不一样,记忆机制的独立贡献也没有做消融实验。
更关键的限定在基准本身:这批成绩仅覆盖公共集,未触及半私有和完全私有的竞赛集。按 ARC Prize 的规则,公共集成绩不计入官方排行榜,原因在于无法排除系统曾用公共环境做开发调优。NVIDIA 在博客中同样写明,30% 与 100% 这两个数字来自不同的推理设置和评测设置,不应被解读为 AVO 贡献的直接测量。
评估模型不等于评估智能体
NVIDIA 把这次结果的核心归结为一个方法论论点:模型能力巨大地重要,但决定能力能否转化为持续自主进展的,是围绕模型的整套系统。GPU 内核优化和 ARC-AGI-3 表面上毫无交集,底层的计算模式却相同——从不完整的证据形成假设、通过外部接口行动、观察后果、保留有效状态、修正错误认知。领域变了,反馈通道变了,循环没变。迁移过来的不是领域知识,而是让进展可以跨上下文累积的机制。
这个论点对 Agent 开发者是直接的背书:记忆、监督、执行反馈这些 harness 层的设计,正在成为与底层模型同量级的竞争维度。NVIDIA 还用 GPT-5.6 Sol 做了小规模配对测试,发现不同 frontier 模型在 AVO 上呈现互补的运行特征,系统性对比留待后续。含金量的最终检验在私有集——那才是 ARC Prize 排行榜说话的地方。
 AI 速览