5 月 29 日,Anthropic 火速推出Claude Opus 4.8旗舰大模型,距离 Opus 4.7 发布仅相隔 42 天,创下品牌最短迭代周期。同期官方宣布完成650 亿美元 H 轮融资,投后估值高达 9650 亿美元,年化收入突破 470 亿美元,坐稳全球顶级 AI 独角兽地位。 本次 Opus 4.8 基于 4.7 基模微调,定价不变却实现功能、推理、诚实度多重进阶,也是实测中首个几乎不会偷懒的大模型。
一、模型基础与行业基准表现
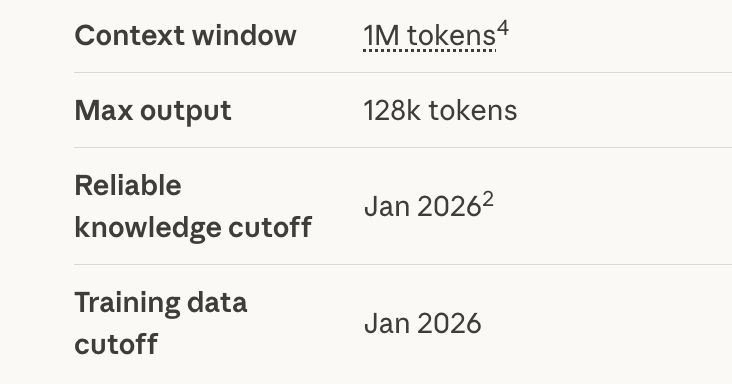
Opus 4.8 在上下文长度、知识库时间等基础参数上与 4.7 保持一致,收费标准仍为输入 5 美元 / 百万 token、输出 25 美元 / 百万 token。
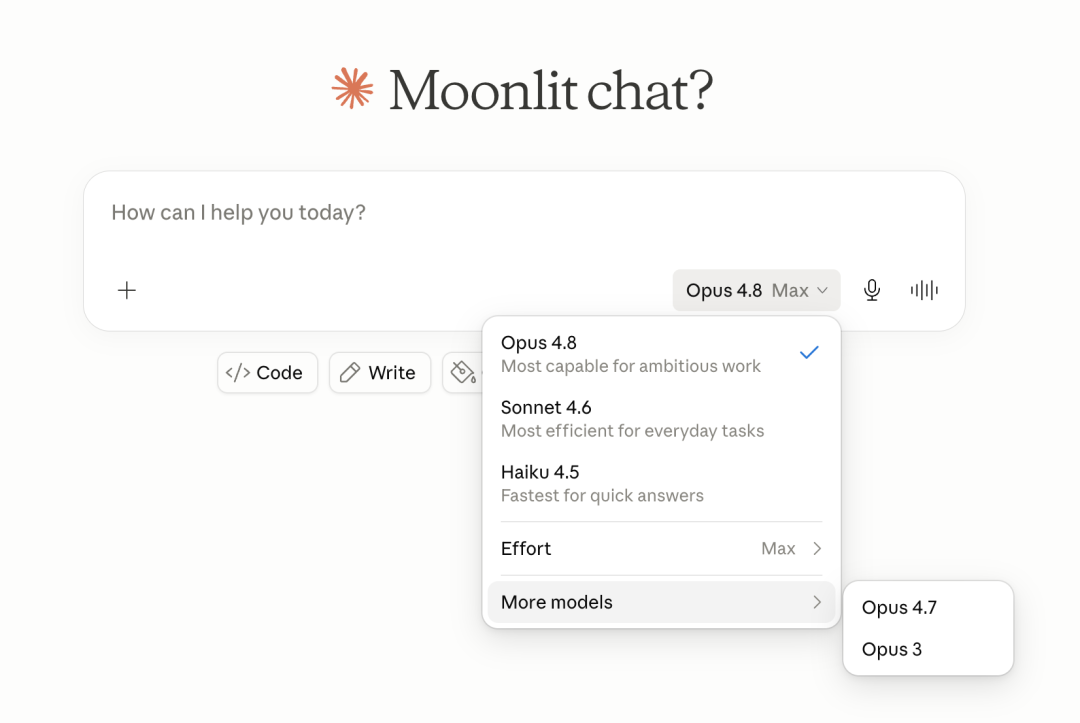
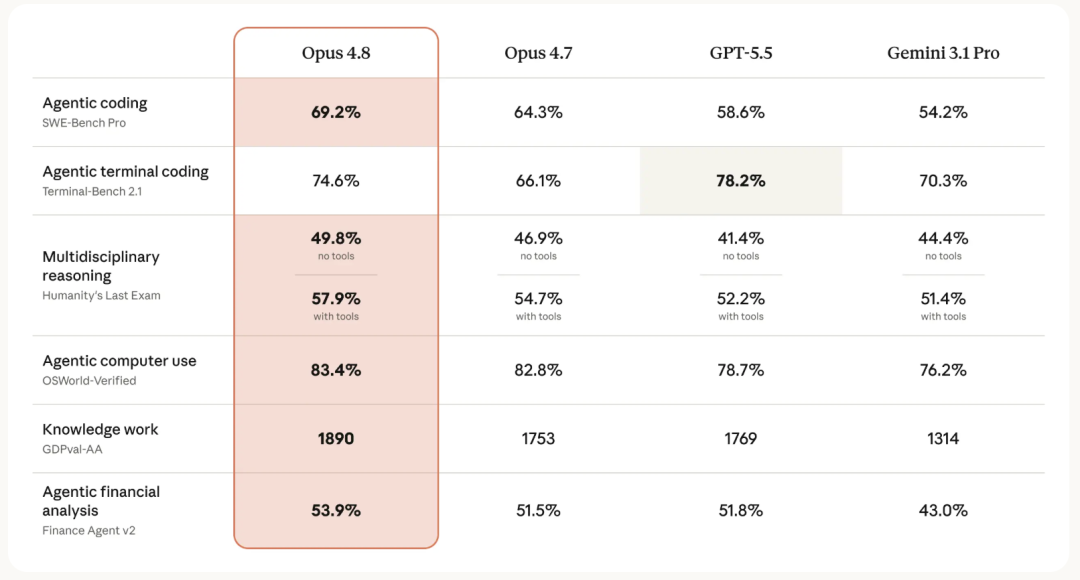
按照 Claude 仅保留两代模型的惯例,深受内容创作者喜爱的 Opus 4.6 正式被下架,引发不少老用户遗憾。在专业跑分测试中,Opus 4.8 各项数据均小幅上涨,综合能力实现常规升级。唯独Terminal-Bench 2.1智能体终端任务赛道未能超越 GPT-5.5,该基准侧重模型在命令行环境自主查文件、敲代码、排报错的能力,也凸显了 GPT-5.5 在智能体开发领域的领先优势。
二、四大核心功能重磅更新
本次迭代聚焦实用体验优化,带来四项用户感知极强的新特性。
首先,思考强度全员开放。
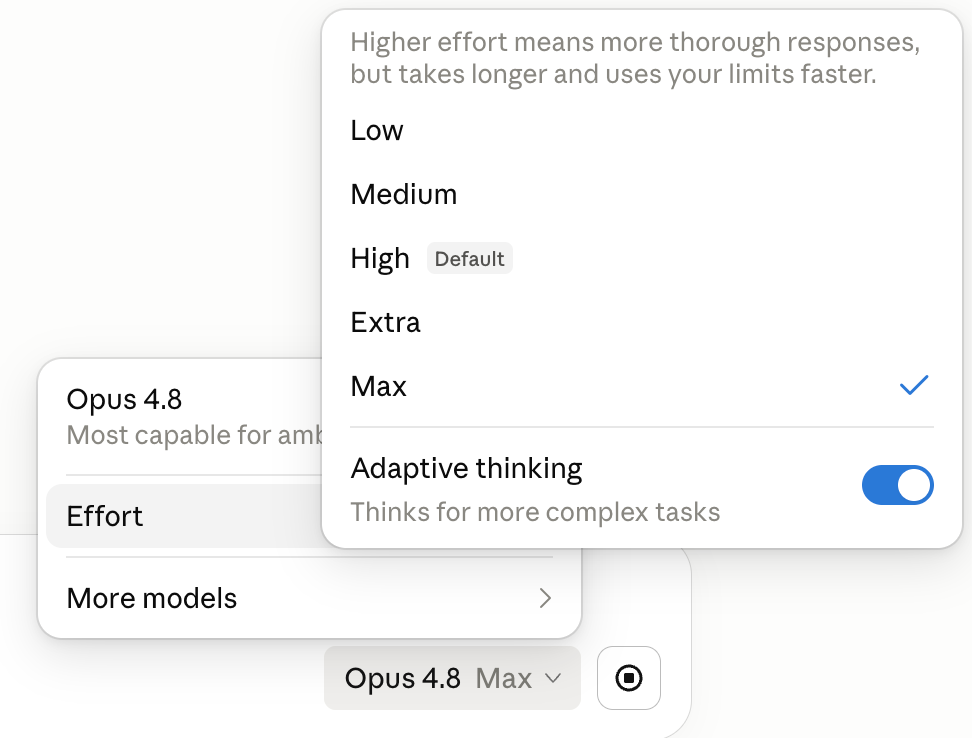
免费及全套餐用户均可手动调节模型努力等级,从 Low 到 Max 多档位可选,搭配自适应思考模式,日常任务默认 Extra 档位,复杂开发任务可拉满 Max 强度,弥补了 4.7 思考模式单一的短板。
其次,精准度提升但主动性弱化。
模型指令遵循能力大幅增强,做到指哪打哪,幻觉率与错误率显著降低。但弊端也随之显现,仅严格执行指定任务,不会主动延伸关联需求,过往自动联动线上服务器、预判潜在需求的特性消失,对用户精准表达需求的能力要求更高。
再者,诚实度跨越式优化。
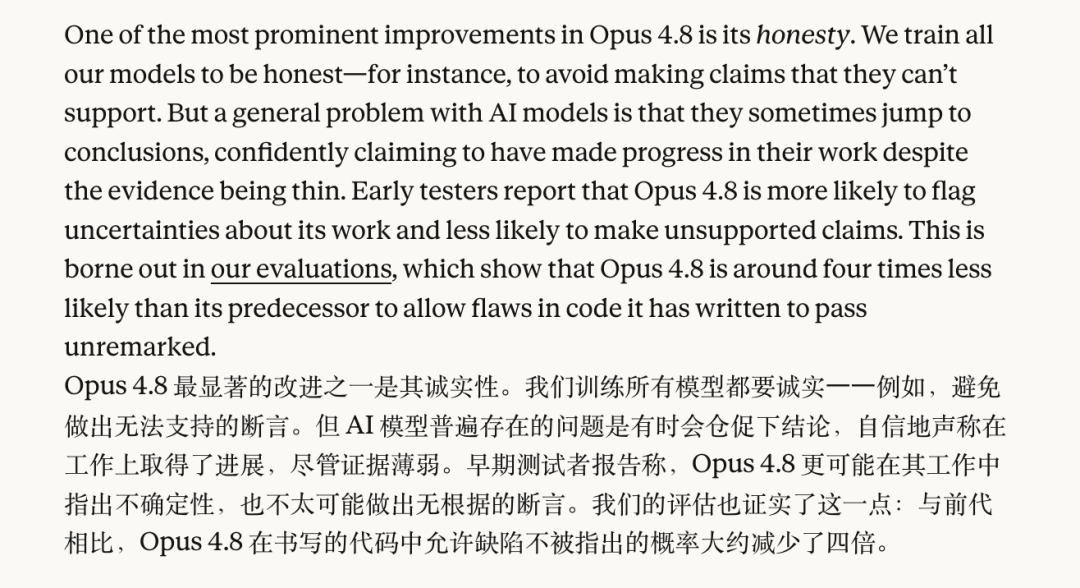
作为本次核心亮点,Opus 4.8 代码瑕疵蒙混过关概率比上代降低 4 倍,偷懒不良率降至 0% 。一改过往 AI 盲目自信、敷衍搪塞问题的通病,会深度排查代码漏洞、如实标注不确定问题,细致打磨每一项任务细节。
最后,Fast 快速模式性价比暴涨。
保留标准版 2.5 倍运行速度,价格降至原先三分之一,输入 10 美元、输出 50 美元,从标准版 6 倍溢价降至 2 倍,大幅降低实时交互、高频调用场景的使用成本。
三、开发与创作能力实测反差
Opus 4.8 呈现明显的偏开发、弱创作特质。
在编程领域提升显著,可轻松承接十万行级代码迁移、跨服务故障排查等硬核任务,动态工作流能批量拉起上百个子智能体并行作业,自主核验结果后交付,极大解放专业开发者效率。而内容创作层面表现平平,虽优于 Opus 4.7,但依旧不及 4.6 巅峰水准。
实测中存在句式刻意规避、比喻生硬、无意义排比等浓重 AI 味,故事续写、文案创作刻板固化,原有适配 4.6 的写作 Prompt 和技能模板,均需重新调试适配。
四、未来布局:高阶模型 Mythos 即将上线
除 Opus 4.8 外,Anthropic 埋下重磅伏笔,代号Mythos的超高端模型已研发就绪,预计数周内向全量客户开放,智能层级将全面超越现有 Opus 系列。
整体来看,Claude Opus 4.8 是一次偏向专业开发者的精准升级,以零偷懒、高精准、高诚实为核心优势,牺牲了部分创作质感与主动交互性。
随着 Anthropic 逼近万亿估值,叠加新模型储备落地,AI 大模型行业内卷将进一步加剧,而用户也需适配新模型特性,调整 Prompt 使用逻辑与协作方式。
 AI 速览