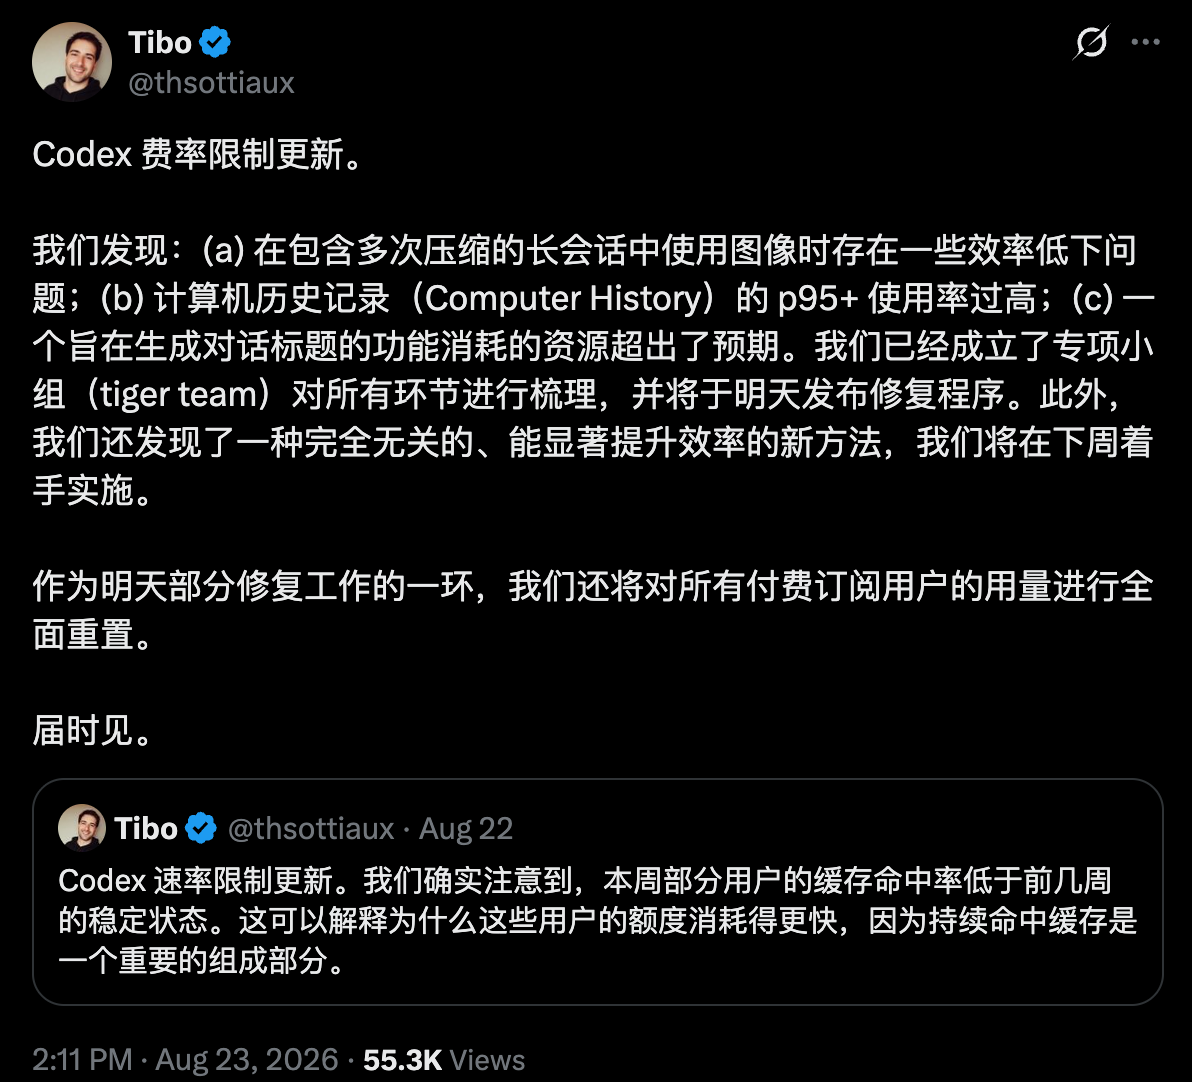
8月23日消息,OpenAI Codex 负责人 Tibo Sottiaux 在最新发帖中承认,团队发现了三个导致配额异常消耗的具体来源:多次压缩的长会话中图像处理存在低效、计算机历史(Computer History)功能在重度用户(p95 以上)中使用率过高、对话标题生成功能消耗的资源超出预期。OpenAI 已成立专项小组梳理所有环节,将在次日发布修复程序,并同步对所有付费订阅用户的用量进行全面重置。这一表态发布仅数小时,目前尚无其他媒体转述;修复与重置均为承诺,尚未落地。
官方承认了什么
三项被点名的功能里,有两项属于用户没有主动请求的后台消耗。计算机历史会记录会话中的结构化活动,包括应用与窗口切换、焦点、标题、元数据和键鼠事件,用于保持工作连续性。对话标题生成则完全在用户视野之外运行。Tibo 的表述是这些环节“消耗的资源超出了预期”,但没有披露具体幅度。除此之外,他还提到团队发现了一种与此无关、能显著提升效率的新方法,将在下周实施。
这与那篇爆料的关系
就在上午,一名 ChatGPT Pro 用户发布的审计在开发者社区流传:他检查了自己账户约 40 小时内的计算机历史原始数据,称产生约 9240 万字符,按分词器计算相当于约 3490 万个 Token,并据此指控这一后台功能是每周配额神秘耗尽的根源。
官方的最新表态与这一指控的方向一致,但不能画等号。OpenAI 确认的是计算机历史在重度用户中“使用率过高”,属于消耗异常来源之一;这名用户审计的具体数字——数千万 Token 的量级——并未获得官方背书。同一时期官方还给出过其他解释:本周部分用户的缓存命中率低于前几周的稳定状态,会推高同样上下文的计费;此前一天 Tibo 还将大量配额投诉归因于不被支持的 sub2api 共享用法。对大多数用户来说,配额消耗加快更可能是多个因素叠加,而不是某一项功能单独造成。
承诺的可信度问题
这不是 OpenAI 本周第一次对配额问题做出承诺,而上一次的承诺没有按时兑现。8月21日,Tibo 宣布为庆祝 Codex 与 ChatGPT Work 突破 2000 万活跃用户,向所有付费用户发放可自行安排时间的 banked reset,随后又把到账时间明确为太平洋时间当晚 8 点。期限过后,大量用户报告账户中并未出现这一重置。记者 Ed Zitron 公开批评称,OpenAI 一边否认配额收紧、一边承诺的补偿却没有到账。
这一次的承诺更具体——有明确的修复对象和时间点,也比上一次更容易验证:次日之内,修复是否发布、付费用户的用量是否被重置,每个订阅用户都能在自己的使用页面上直接看到。在那之前,这两条承诺都只能按“官方表态”对待。
 AI 速览