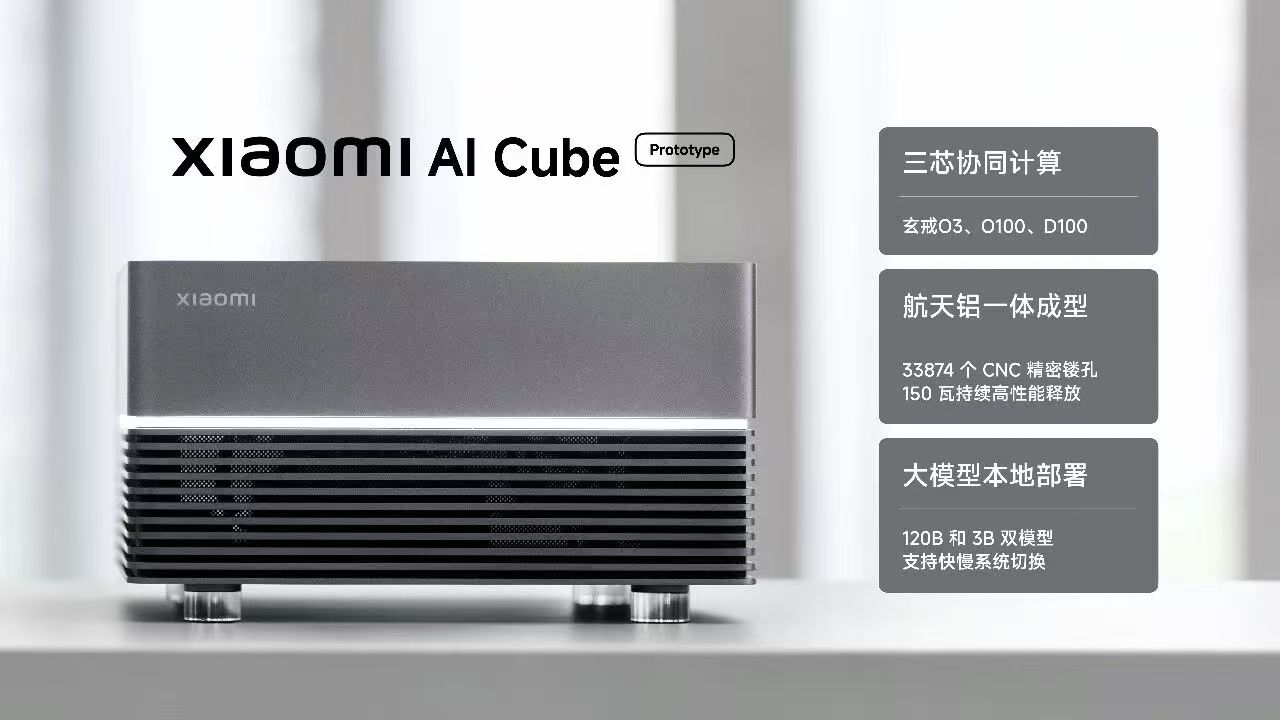
8月24日消息,小米今日举办玄戒芯片技术沟通会,一次发布三款自研芯片:AI 旗舰 SoC 玄戒 O3、端侧大模型高带宽 AI 加速芯片玄戒 O100、智驾高算力 AI 芯片玄戒 D100。同场亮相的还有一台名为 Xiaomi AI Cube 的本地 AI 主机原型,由这三款芯片协同驱动,支持 120B 参数大模型的本地部署。三款芯片的进度并不相同:O3 已规模量产,O100 和 D100 已完成全部验证、明年商用,AI Cube 则只是工程版原型,上市时间和售价均未公布。
三款芯片:一颗量产,两颗明年商用
玄戒 O3 是其中唯一已经量产的芯片。据雷军公布的官方信息,这款历时 459 天研发的 AI 旗舰 SoC 采用 3nm 工艺,集成 240 亿个晶体管,芯片面积 133mm²,晶体管数量较玄戒 O1 增加 26%;安兔兔跑分达 522 万分,是首个突破 500 万分的旗舰 SoC。CPU 采用十核全大核设计,由 6 颗超大核与 4 颗大核组成,最高主频 4.35GHz,Geekbench 6.5 单核 3945 分、多核突破 15000 分,官方称单核提升 31%、多核提升 60%。GPU 首发 16 核 G2-Ultra NX,官方给出的 GFXBench Aztec Ruins 1440P 提升 94%,3DMark SolarBay Extreme 光追测试提升 182%,GPU 功耗较 O1 降低 64%。
内存与 AI 是 O3 的重头。它是行业首款支持 LPDDR6 的移动 SoC,带宽 113.8GB/s,较 O1 提升 48%,访存时延压到 82ns。NPU 架构全面重构,拥有 200TOPS 张量算力和 3.13TFLOPS 向量算力;小米芯片团队与模型团队还联合为 O3 定制了 5 值量化的 MiMo 端侧模型,配合硬件无损压缩,官方称推理效果与传统 INT4 相当、内存带宽节省 30%。落到端侧 AI 的整体表现上,官方数据是首词速度提升 40%、推理速度提升 45%、运行功耗降低 26%。上述跑分与提升幅度均为官方口径,尚无第三方实测。根据沟通会公布的搭载规划,小米 18 Fold 将于9月首发搭载玄戒 O3,小米平板 9 Pro Max 也将同步搭载。
玄戒 O100 面向的是另一个问题:端侧大模型的带宽瓶颈。官方称它是全球首款 6nm 3D 晶圆级堆叠的 AI 加速芯片:两层 AI 专用高速 DRAM 晶圆与一层高性能 NPU 晶圆垂直堆叠,以 Hybrid Bonding 混合键合工艺实现 1.4 微米的键合间距,再用 Face to Face 金属直连缩短 DRAM 与计算层的物理距离。芯片内置 14 颗高算力 NPU,通过自研矩阵总线互联,在 Prefill 和 Decode 阶段分别切换环形与广播拓扑。最终带宽达到 1.22TB/s,是主流旗舰手机 LPDDR5X 内存 76.8GB/s 的约 16 倍。官方称相关技术已申请 15 项专利,其中 4 项发明专利获批。为展示实际效果,小米还展示了一台 O3 加 O100 双芯协同、带风冷主动散热的原型机,运行 MiMo 端侧模型的本地推理速度最高约 330 Tokens/s。该芯片已完成全部验证,计划明年正式商用。
玄戒 D100 则把玄戒带进了汽车。官方称这是国内首款 3nm 智驾高算力 AI 芯片,由 20 核 CPU 与 16 核 NPU 组成,最高支持 160GB 统一内存,可在本地部署 200B 参数量的模型。它同样已完成所有验证,明年正式商用。
AI Cube:一台还买不到的原型机
把三款芯片装进同一台机器,是这次沟通会最有画面感的部分。据 IT之家现场报道,Xiaomi AI Cube 是一台迷你主机形态的工程版产品,内部由玄戒 O3、O100、D100 组成三芯阵容,支持大模型本地部署。机身采用航天铝一体成型工艺,CNC 精密镂空出 33874 个蜂窝散热孔,持续性能释放可达 150W。
功能上,这台原型机支持 120B 和 3B 双模型的本地部署,并支持官方所称的"快慢系统切换"。两个系统如何分工,官方没有展开说明。小米也尚未公布它的上市时间、售价和具体配置,它目前能证明的是三芯协同在工程上可行,还不是一个可以购买的产品。
从一颗手机 SoC 到三条芯片线
2025年5月22日,小米发布玄戒 O1,官方称其为"中国大陆首款 3nm 先进制程 SoC",当时的核心叙事是"小米也能做旗舰芯片";同期还有标志基带自研能力的玄戒 T1。雷军今天披露,小米重启大芯片研发已五年多,累计研发投入超过 210 亿元,芯片团队接近 3000 人。15 个月后,玄戒从一颗芯片变成了三条产品线:手机平板用的旗舰 SoC、端侧大模型用的高带宽加速器、汽车智驾用的高算力芯片,再加上一台把三者拼起来的主机原型。对小米的"人车家"生态来说,自有芯片、自有的 MiMo 大模型和自有终端正在拼成一个更完整的端侧 AI 闭环——手机、汽车和本地主机可以共享同一套芯片与模型能力。
AI Cube 所在的品类也不是孤例。英伟达的 DGX Spark 已于2025年10月开售,128GB 统一内存、3999 美元的定价,瞄准的同样是"在本地跑大模型"的需求,并由此带出了宏碁、华硕、戴尔等一批跟随产品。小米是第一家以手机厂商身份进入这个品类的公司,它的差异在于芯片、模型和终端全部自研自持。
不过,发布和兑现之间还有明确的距离:三款芯片里只有 O3 到了消费者能见到的阶段,O100 和 D100 要等明年,AI Cube 连上市承诺都还没有;官方公布的跑分和提升倍数也还没有第三方实测可以对照。这次沟通会能确认的,是小米自研芯片从单点突破变成了三条线的矩阵,矩阵的实际表现要等量产和商用之后才有答案。
 AI 速览