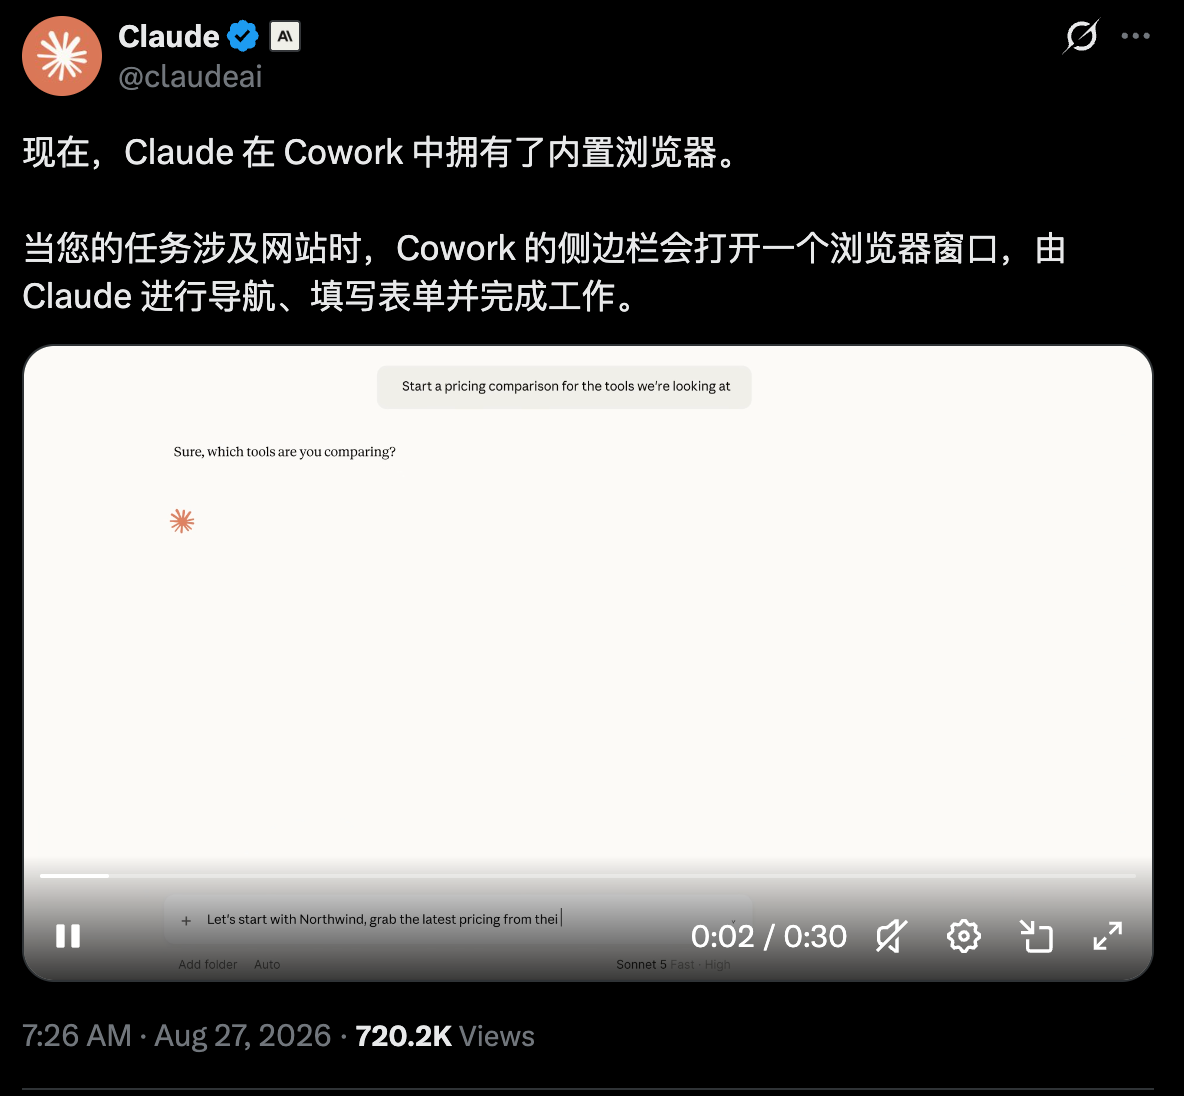
8月27日消息,Anthropic 对 Claude 发布了一轮更新,落在两条并行的线上:一条让 Claude 更能独立完成任务——Cowork 有了内置浏览器,Claude Code 会自己草拟问题反馈;另一条让它的行动更可被查看——组织管理接口 Admin API 接入 SDK 与 CLI,外部研究者首次获得脱敏后的真实使用数据。四件事同一天发生,指向的是同一个产品判断:Claude 正在变成一个独立的工作系统,而独立的前提是留下记录。 自主这一侧:Cowork 开了自己的浏览器,Code 会写自己的反馈
Cowork 的内置浏览器解决的是一个具体摩擦:任务涉及网站时,Claude 不再借用用户本机的浏览器,而是在 Cowork 侧边栏打开一个独立浏览器窗口,自己完成打开站点、读页面、填表单的全程。它与用户自己的浏览器、登录态和标签页完全隔离,每个会话只需登录一次;也可以从本机浏览器导入 Cookie 保持登录(macOS 上支持 Chrome、Edge、Firefox,Windows 和 Linux 上支持 Firefox)。该功能在 Pro、Max、Team 档位的 Cowork 桌面端可用,企业管理员在组织设置的 Cowork 面板里统一管理。
另一件在 Claude Code。2.1.247 版本新增了 SendFeedback 工具:当一次会话出错、Claude 发现自己出错、或用户指出问题时,它会自动草拟一份反馈报告,用户审阅、修改之后从 /feedback 命令发出。不想用这个行为,可以用 feedbackDrafts 设置关掉。「出了问题到形成一份可提交的反馈」这一步,从用户的手工活变成了 Claude 的默认动作。
被看见这一侧:Admin API 管组织,脱敏数据给外部
组织管理层,Claude Admin API 现已接入 SDK 与 ant CLI:组织成员、工作区、邀请和 API Key 都可以程序化管理,配套的 Usage and Cost API 与 Rate Limits API 能输出使用、成本与速率限制报告。认证需要 Admin API Key 或组织级 org:admin OAuth。同一版 Claude Code 的 /claude-api 技能也同步覆盖了这些管理能力。 外部审视层,Anthropic 公布了今年春季的一项试点结果:斯坦福 SALT 实验室、牛津大学 Human Information Processing Lab 和 METR 三家外部机构,通过 Anthropic 的隐私保护分析工具 Anthropic Insights(原名 Clio),各自独立分析了约 25 万段今年 4 至 5 月的 Claude 对话。研究者不接触原始对话,只看到聚合后的类别与占比;Anthropic 称这是外部研究者第一次在 AI 公司的真实使用数据上开展独立研究,各项目的聚合数据已同步公开,第三方隐私审计由帝国理工学院完成。
试点已经产出了第一批值得引用的发现。SALT 实验室发现,超过一半的对话中用户在把「高后果任务」(影响他人或难以撤销的工作)委托给 Claude,比例高于既往研究的预期;近四分之三的对话里,人仍然掌握方向和监督权,且协作中的摩擦往往有建设性——它推着用户澄清意图、改进产出。牛津团队研究使用情绪与 AI 行为的关联,METR 对编程智能体真实生产力提升的测算仍在进行中。Anthropic 同时开放了后续研究的意向申请。
一天四件事,其实是一套配套工程
把这四项更新拆开看,每一项都不大;放在一起,结构很清楚。自主这一侧回答的是 Claude 能做多少:替用户完成网页任务,替用户把失败整理成反馈。被看见这一侧回答的是 Claude 做了什么、谁能看到:组织通过管理 API 掌握成员与用量,外部研究者通过脱敏数据审视真实影响。Anthropic 在扩大 Claude 行动面的同时,给每一层都装了对应的查看口——自身层面的 Code 反馈、组织层面的 Admin API、外部层面的数据开放。
边界同样需要说清。这些能力和机制都来自 Anthropic 自己公布,实际表现还没有第三方验证;SALT 实验室「超半数对话在委托高后果任务」的发现虽然出自外部研究者之手,但数据和分析工具都来自 Anthropic 自己的平台。Claude 的自主性能做到什么程度、这套「留痕」机制是否真跟得上,要等企业部署和外部研究的后续结果来回答。
 AI 速览