- 腾讯混元、浙江大学、北京大学、清华大学团队发布《Diving into Reliable Self-Evolving Agents: A Survey》(OpenReview 预印本,2026),配套目录以 MIT 协议开源
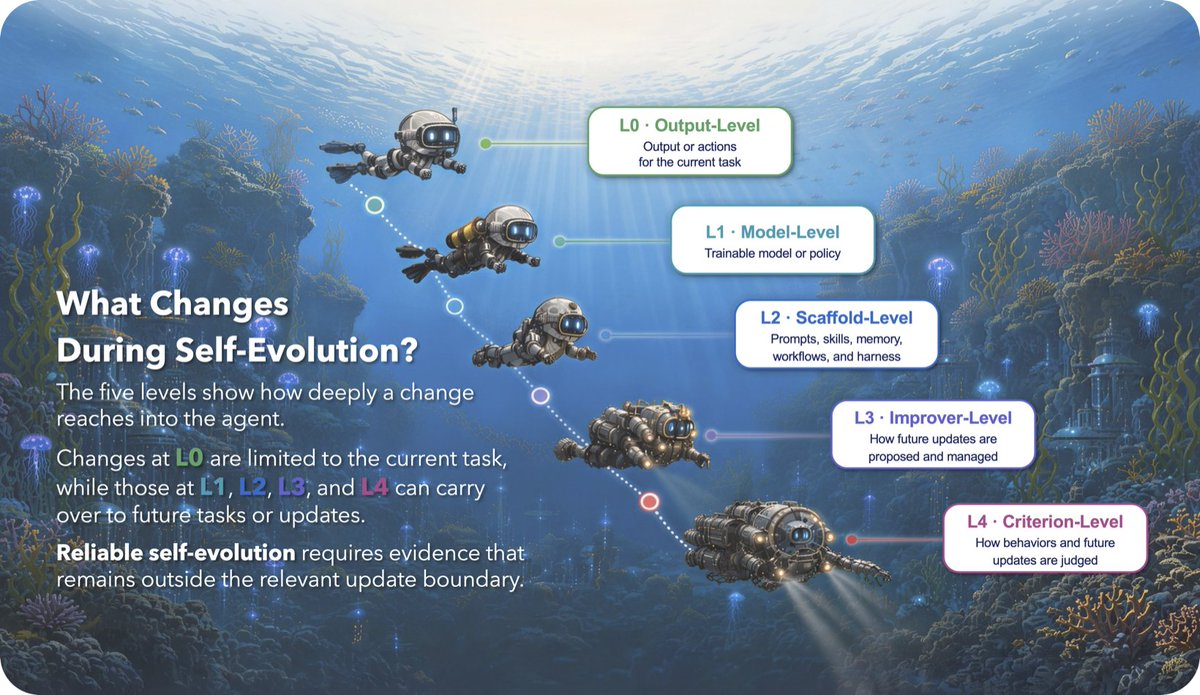
- 提出 L0–L4 五级自进化深度:输出级、模型级、脚手架级、改进器级、准则级,按「最深的主动演化目标」划分,不是按算法名或训练阶段
- 每一级配一个典型失败模式:自我确认、模型崩溃、脚手架过拟合、指标捕获、准则漂移
- 提出可靠性阶梯:逐级配对外部证据源与恢复控制,核心原则是更新不得控制验证自身的唯一证据
- 配套目录精选 549 篇文献,按 9 个分区组织,脚手架级(L2)257 篇占比最高
- 递归自我改进(RSI)从 L3 开始、L4 延伸;级别只描述改动深度,不表示能力或可靠性高低
这份综述是什么:一张「自进化深度」地图
《Diving into Reliable Self-Evolving Agents: A Survey》把「智能体用自己执行中产生的信息改进自己」这件事按改动触及的深度分成五级,并为每一级配上「该信什么证据、该设什么闸门」的清单。输入是 549 篇领域文献与代表性系统,输出是一张 L0–L4 分类图、一张可靠性阶梯和一份开放问题清单。
论文由腾讯混元、浙江大学、北京大学、清华大学的 13 位作者完成,通讯作者是浙江大学的 Hehe Fan。论文以 OpenReview 预印本形式发布,配套 GitHub 仓库以 MIT 协议托管完整目录、论文 PDF 与项目页。仓库目前约 22 stars(截至 2026 年 8 月 12 日),公开讨论还不多,本文事实以论文原文与仓库为准。
L0–L4 分级:你的 Agent 改动触及哪一层
分级依据是「最深的主动演化目标」,即一次改动在功能链条上真正触及的最深组件,而不是算法的名字、训练阶段或运行时组件。L0 是任务局部的,只改当前输出或轨迹;L1 到 L4 都要求「保留的改动」会影响后续独立任务或未来更新。
| | |
|---|
| | |
| | |
| | 脚手架过拟合(Scaffold overfitting) |
| | |
| | |
目录中的文献分布能看出研究重心:脚手架级 257 篇、模型级 137 篇、输出级 42 篇、准则级 30 篇、改进器级 21 篇。改动最浅的两级加起来不到总量的三分之一,说明当前自进化研究大部分发生在提示词、记忆、工具和工作流这一层,真正改模型参数或评价准则的工作是少数。
论文把递归自我改进(RSI)定义为「保留的改动触及改进器或准则」:L3 改变后续修改如何被提出、选择、提交或回滚,L4 进一步改变行为或候选状态如何被判断。这是结构定义,不代表 L3、L4 系统一定在改进,也不代表改进在加速。
可靠性阶梯:每一级该用哪种外部证据
一个贯穿所有级别的结构性问题:更新可以通过影响证据来提高测量分数,而不是在外部目标下真正改进。L0 里提议者和批评者可能共享同一个错误;L1 里带偏见的监督信号进入保留参数;L2 里脚手架过拟合基准、记忆与工作流的交互;L3 里改动提案或内部选择可以捕获固定指标;L4 里更新直接换掉了判断改进的标准。
论文的应对是一条硬原则:任何更新都不应控制用于验证自身的唯一证据。论文原文的表述是,一旦证据指导过候选生成或内部选择,它就不能再作为同一更新的唯一最终审计证据。机制上,证据源与验收闸门必须留在更新边界之外,让循环无法改写它们。
阶梯的上升方向是演化深度,不是可靠性排序。L1 更新如果配上硬性的执行结果测试,可能比 L0 用未校准的自评更可信;被反复查询的留出基准在任何级别都会退化成开发目标。真正该比较的是「更新控制什么」和「谁控制审计」两件事。
适用场景与边界:能帮你定位风险,不能替你证明改进
适用对象是做自我改进、技能库、记忆系统、自我奖励或自指改进器的团队:用这套框架给自己的系统定位风险等级,再对照阶梯补外部证据。写综述或找文献的研究者,可以用目录按级别定位相关工作。
边界需要写清楚。论文目前是 OpenReview 预印本,尚未经过同行评审;L0–L4 是作者提出的结构性约定,论文自己注明这不是领域通用标准;可靠性阶梯的配对是设计条件,不是改进的充分保证;仓库刚发布,社区使用反馈样本很少。把「深度」当「能力」、把「级别高」当「更可靠」,是这套框架最容易误用的两个方向。
快速上手:怎么用 549 篇文献目录
资源包括 GitHub 仓库(README 即完整目录)、项目页(含论文 PDF)与 OpenReview 论文页。
- 打开 GitHub 仓库,先看 README 顶部的五级分类表,确定你要找的系统或方法最深的演化目标落在哪一级
- 按 Contents 进入对应分区:L0 共 42 篇、L1 共 137 篇、L2 共 257 篇、L3 共 21 篇、L4 共 30 篇,另有 Surveys and Positioning 24 篇、Cross-Level Reliability 8 篇、Open Problems and Outlook 30 篇
- 在分区内用浏览器查找关键词,或按年份与 venue 筛选;每条记录附论文链接,部分附代码与项目页
- 想补充或修正条目,按 CONTRIBUTING.md 提 PR,README 顶部列有联系邮箱
成功验证的标准:你能说出自己的系统属于哪一级,并能从对应分区找出 3 到 5 篇直接相关论文。常见失败有两个:按算法名相同就把方法归为同级,分级看的是最深演化目标而不是方法名;把 L 级高低当能力排序,级别只表示深度,与能力、可靠性无关。
在自进化 Agent 生态中的定位
已有综述回答「怎么进化」:TMLR 2026 的《A Survey of Self-Evolving Agents》按 What、When、How、Where 组织方法,可对照 arXiv:2507.21046 查看。这篇综述补的是另一个问题「怎么证明改进是真的」,它把可靠性从一句口号拆成逐级可检查的审计清单,这是相对既有综述的增量。
读完之后可以做的三件事:把自己正在做的系统对号入座到 L0–L4,写下它最深能改动的组件;对照可靠性阶梯,标出当前证据里哪些指导过候选生成、哪些可以独立审计;把缺的那一级外部证据写进下一轮设计评审。
 AI 速览