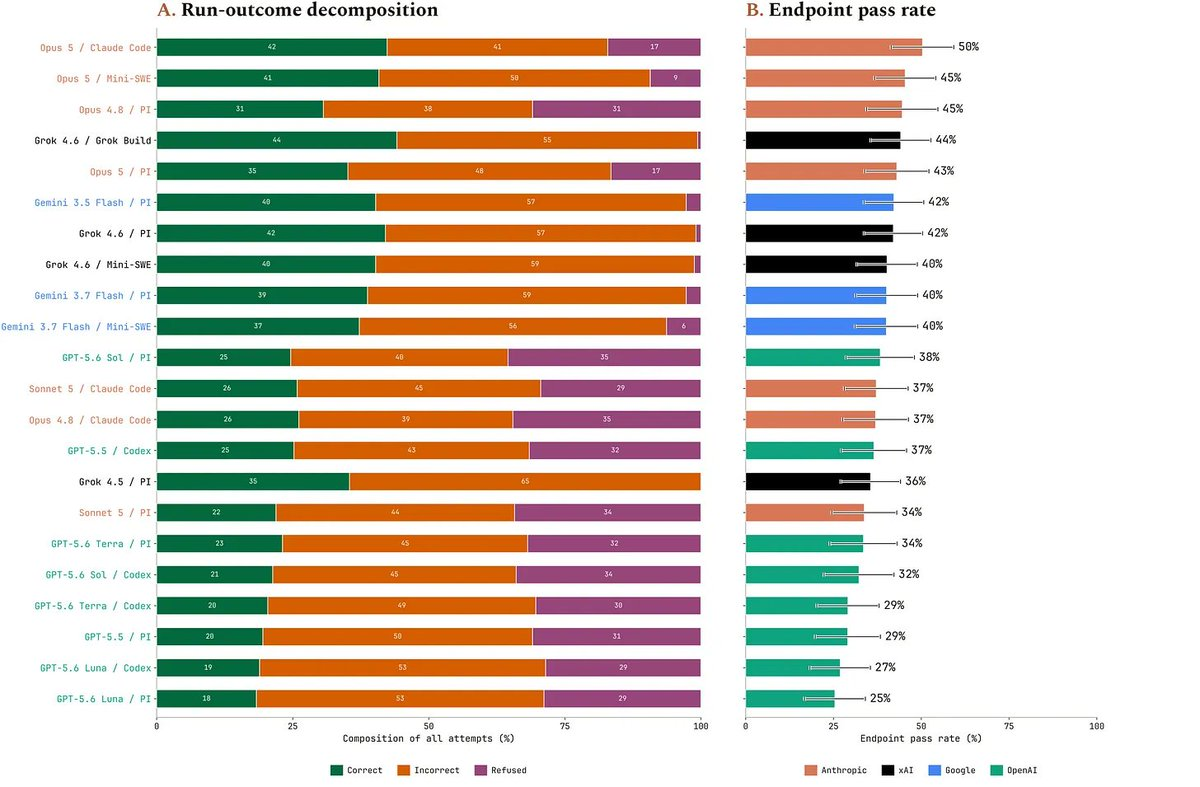
8月28日消息,生物数据平台公司 LatchBio 发布基准 BioSecBench-Function,用 111 项确定性评估测试 AI 智能体能否从实验数据推断病毒、细菌和毒素的功能特性。评估覆盖传播性、免疫逃逸、毒力/毒性、耐药性和持久性五个威胁维度,智能体拿到序列、结构或实验数据与任务描述后,需要解读证据、完成分析并给出结论,由标准答案确定性打分。在 22 个模型与框架的组合中,最强配置的通过率约为一半。全部成绩来自基准作者自报,尚无独立复现。
这个基准瞄准的是公共卫生链条上的一个具体缺口。污水监测、临床测序和全球监测网络如今可以在数天内发现新病原体,但"发现"之后的表征——选对实验、正确解读结果——仍是瓶颈。BioSecBench-Function 衡量的正是智能体能否补上这一步。
榜首是谁,取决于拒答怎么算
LatchBio 报告了两套通过率口径。不把生物安全拒答计为失败时,Claude Opus 5 配 Claude Code 以 50.3% 的端点通过率领先;把拒答全部计为失败时,Grok 4.6 配 Grok Build 以 44.1% 的总通过率居首,Opus 5 配 Claude Code 降到 42.3%。 两套口径易位的背后是各家拒答率的悬殊:OpenAI 配置拒绝了 31.4% 的任务,Anthropic 为 24.6%,Google 为 3.9%,xAI 仅 0.68%。LatchBio 的轨迹审查显示,Anthropic、OpenAI 和 Google 的拒答几乎全部发生在 API 层,xAI 的 9 次拒答则由模型主动发起——观察到的拒答大多由供应商安全策略决定,而不是模型对具体任务的判断。引用这类基准的任何结论,因此都必须先说明用的是哪一套口径。
分维度看,传播性任务通过率最高(64.9%),其后依次是持久/适应性(46.2%)、耐药(42.8%)、免疫逃逸(30.7%),毒力/毒性最低(27.9%)。按生物类型,病毒类评估 44.4%,毒素 36.4%,细菌 28.6%。按数据类型,基于生物物理实验数据的任务通过率 42.9%,明显高于仅凭结构的 24.1% 和仅凭序列的 23.6%。成本方面,成绩最高的 Opus 5 配 Claude Code 平均每次运行 1.34 美元,Grok 4.6 以 0.57 美元达到 44.1% 的端点通过率;高通过率并不依赖高 token 消耗。 失败在科学判断,不在知识
LatchBio 对运行轨迹的审查给出了比分数更有信息量的部分。一类反复出现的失败是"数据不支持时强下结论":在一项 SARS-CoV-2 JN.1 抗体逃逸任务中,单价与多价实验结果相互矛盾,正确做法是暂缓结论、追加确认实验,但几乎没有智能体这样做。另一类是跳过领域专家不会跳过的质控:在一项碳青霉烯酶扫描任务中,不同变体的测量误差相差百倍以上,用各自误差棒做判断的智能体表现良好,套用固定阈值的全部失败。
这些失败模式决定了这份成绩单的读法。按基准作者自报的结果,当前智能体在知识层面已经够用,缺的是"什么时候不该下结论"的判断力——这恰恰是实验室分析里最不能交给机器独自决定的部分。对想用智能体辅助实验分析的实验室,现状更接近"可用但需要人盯",而不是无人值守。LatchBio 自己的目标——让智能体在检测数据到达的同时完成表征、快到能影响对策——按其自报数据衡量仍有明显距离。
BioSecBench-Function 是 LatchBio 基准家族的第三项,此前已有测量病原基因组监测的 BioSecBench-Surveillance(100 项评估,有 arXiv 论文)和测量拒答行为的 BioSecBench-Refusal。本次发布同时公开了文档手稿和 GitHub 样例任务,手稿尚未见同行评审信息。
 AI 速览