作者简介
Dimension 是一家总部位于纽约和旧金山的多元阶段(multistage)、研究导向的风险投资机构,2022 年底由 Zavain Dar、Adam Goulburn 和 Nan Li 联合创立,三人此前均任职于 Lux Capital。该机构聚焦科技与生命科学的交叉地带,2024 年 12 月完成 5 亿美元二期基金募集,此前长期撰文关注中国在生物医药领域的进展。
文章概述
这是 Dimension 致有限合伙人的一封机密信。一个小团队上周访问了中国的头部 AI 实验室,并与当地投资人、创业者和技术人员交流,在此基础上总结出 13 条对中美 AI 竞争格局的判断。核心论点包括:出口管制反而逼出了中国实验室的全栈效率文化;中国开源权重模型已经渗入西方生产栈,拿下的是工作负载而不是收入;中国前沿阵营内部竞争激烈程度被西方低估;中美面临的约束正好相反——美国缺电、中国缺芯;双方收入差距接近两个数量级,但中国头部实验室的估值倍数反而比美国同行高五到十倍。信末给出了两个前瞻判断:美国前沿实验室可能关闭未来最强模型的 API 访问;以及除非可行的递归自我改进(tractable recursive self-improvement,RSI)出现,「谁在赢」这个问题本身没有意义,因为两个体系已经缠绕得太深。
正文翻译
各位合伙人:
Dimension 的一个小团队上周在中国拜访了头部实验室,并与当地投资人、创业者和技术人员交流。此行的主要目的是重温并修正我们 2025 年上海之行形成的先验判断。我们此前已经大量撰写和谈论过中国在生物医药领域日益提升的重要性,这封信则总结我们对当前跨太平洋 AI 棋局的观察。以下内容只是我们当下思考的一个切面,并提醒各位:这些观点在持续演化,可能因新的数据甚至新的辩论而改变。
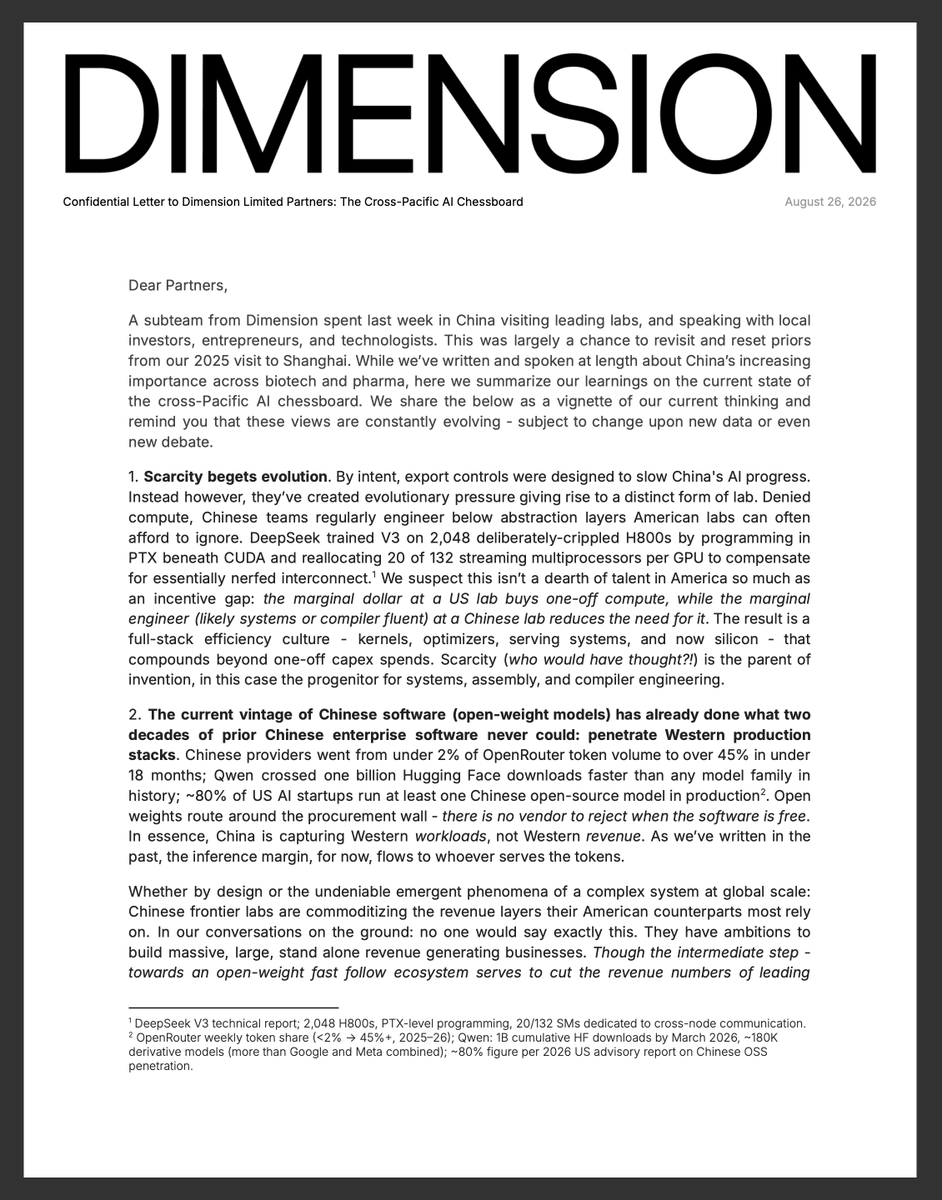
一、稀缺催生进化。 出口管制的本意是拖慢中国 AI 的进展。然而事与愿违,它制造了演化压力,催生出一种形态独特的实验室。得不到算力,中国团队经常在美国实验室往往可以忽略的抽象层之下做工程。DeepSeek 在 2,048 张被刻意削弱的 H800 上训练 V3,做法是绕过 CUDA 直接用 PTX 编程,并把每张 GPU 上 132 个流式多处理器中的 20 个重新分配,用来补偿实质上被削弱的互连。¹ 我们怀疑,这并非美国缺乏人才,而是激励结构的差异:美国实验室的边际一美元买来的是一次性的算力,而中国实验室的边际工程师(很可能精通系统或编译器)减少了对算力的需求。其结果是一种全栈效率文化——kernels、优化器、服务系统,现在还包括芯片——其复利效应超越一次性的资本开支。稀缺(谁能想到呢?!)是发明之母,在这个案例中,它是系统工程、汇编与编译器工程的始祖。 二、当前这一代中国软件(开源权重模型)已经做到了此前二十年中国企业软件从未做到的事:渗入西方的生产栈。 中国厂商在 OpenRouter 的 token 用量份额从不足 2% 涨到超过 45%,只用了不到 18 个月;Qwen 在 Hugging Face 的下载量突破十亿次,快过历史上任何模型家族;约 80% 的美国 AI 创业公司至少在生产环境中跑着一个中国开源模型。² 开源权重绕过了采购之墙——软件免费时,没有供应商可供拒绝。本质上,中国拿下的是西方的工作负载,而不是西方的收入。正如我们此前所写,推理环节的利润,至少目前,流向的是真正提供 token 服务的那一方。 无论是刻意设计,还是复杂系统在全球尺度下不可否认的涌现现象:中国前沿实验室正在把美国同行最依赖的收入层商品化。在实地的交流中,没有人会直接这么说——他们都有建立大规模、独立营收业务的雄心。不过,迈向开源权重快速跟随生态的中间步骤,客观上压低了美国头部实验室的收入数字,同时把推理收入推向超大规模云厂商(hyperscalers)和新兴云厂商(neoclouds)。除非当前棋局出现有意义的状态改变,否则我们看不到这个趋势放缓的理由。
三、中国前沿阵营内部的竞争激烈程度,超过西方惯常的认知。 我们的看法是:这个前沿阵营——DeepSeek、阿里巴巴(Qwen)、Moonshot(Kimi)、字节跳动(Doubao)和智谱(GLM)——彼此足够接近,排名每个季度都会重洗。(值得一提:腾讯尽管在生态中地位显赫,但已不在帕累托前沿上。)五家实验室比拼发布节奏和能力、同时都在开放权重,这与美国两家闭源实验室构成的竞争生态截然不同。我们本周的另一个收获是:阵营内部竞争对创新的驱动力,不亚于西方媒体头条聚焦的阵营间竞争。 四、今天,AI 能力要先横跨太平洋两个来回,才到达最终客户。 这个循环是:美国前沿实验室训练出性能最强的模型;中国实验室对它们做蒸馏³并开放权重;美国应用公司再基于中国权重微调,把产出卖回给美国企业。Cursor「自研」的 Composer 2 结果被证明构建在 Kimi K2.5 之上;Cognition 的 SWE-1.5 看起来是定制的 GLM。毫不夸张地说,就在我们乘高铁从上海到北京的途中,Harvey 发布了 Harvey Tenet——一个在 Kimi 开源权重 K3 之上后训练的专有模型。放在一年前,这些公司伸手去拿的会是 Llama,也许是 Mistral。美国垂直 AI 的基座如今是中国开源权重——内里潜伏着美国的前沿智能。
五、数据层似乎也在遵循类似的模式。 美国数据厂商——Mercor、AfterQuery、Turing——已被记录与蚂蚁、阿里巴巴和字节跳动存在商业关系。在实地,我们看到一批中国初创公司正在建设评估与验证基础设施,而不是标注服务。以 UniPat 为例:2025 年 12 月由一名曾在 Qwen、Moonshot 和腾讯实习的北大博士生创立,其发布的基准测试已被美国实验室在自己的模型报告中引用,并声称用基于自有评分细则(rubric)的监督信号训练的小模型取得了很强的结果。其底层思路——用监督质量替代算力——与我们在上文(见第一点)提到的资源(算力)受限环境下的自适应能力一脉相承。我们在北京和上海观察到这个类目下的好几个团队;大多成立不到 24 个月,其中几家正以极快的速度冲向 1 亿美元以上的收入。
六、美国和中国面对的是截然不同、方向相反的约束。 2024 年中国新增电力装机约 429 GW,美国约 51 GW。我们见过的大多数分析认为,到 2030 年中国还有远超 400 GW 的新增电力上线。而在美国,241 GW 的数据中心扩建计划正闲置排队,排在既有的并网需求之后,要等五年。
正如我们写过的,中国的约束来自算力基座的匮乏。举个例子:Moonshot 在 K3 发布两天内就因推理容量不足暂停了新用户注册。美国芯片充裕但日益受电力约束;中国电力充裕但受芯片约束。 我们的看法(我们大胆称之为行业共识)是:中期走向在很大程度上取决于哪一端的约束更快放松——是美国的发电与并网,还是中芯国际和华为的良率与封装曲线。
七、美国和中国 AI 的收入差距依然巨大:接近两个数量级。 Anthropic 的年化收入(run rate)7 月底突破 650 亿美元,OpenAI 8 月达到 400 亿美元⁴;中国最强的模型收入是字节跳动的视频模型,年化约 20–30 亿美元,纯模型实验室的收入在数亿美元量级,据报道 DeepSeek 的年化收入正接近 5 亿美元。消费端,豆包月活用户 3.45 亿,超过 Qwen 和 DeepSeek 之和,但每天收入不足 100 万元人民币,几乎全部来自电商佣金。中国消费者历史上不为软件付费,我们不是中国经济学家,但同样不认为中产阶层已经准备好改变。这种规模的分发最终找到变现路径是完全可能的——十年前中国消费互联网就是这样走过来的。或者,中国实验室最终会通过电商和广告变现,而美国实验室一直不愿意这么做。中国创业者身上有一种毫不掩饰的实用主义,不回避基于影响力或所谓耻感的商业模式——当我们走在香港市中心拥挤的市集街道上,听着 Ben Thompson 在 Patrick O'Shaughnessy 的《Invest Like the Best》里分析美国实验室对广告和电商的非理性回避时,这一点格外清晰。(注:如果你还没听过,Ben 是有史以来最好的分析师之一。) 八、当硬件在半导体层及以下脱钩时,软件和数据层的缠绕速度超出了两国政府的反应能力。 美国应用跑在中国权重之上;中国实验室在马来西亚和泰国租用 Nvidia 算力做训练⁵,蒸馏自美国模型的输出;专家数据双向流动。⁶ 我们发现「谁在赢」这个问题有点离题。现状是,两个体系相互依赖太深,修辞层面的国家霸权(nation-state supremacy)无从成立——除非某种不连续的东西(即可行的递归自我改进,RSI)真正改变当前棋局的结构。
九、我们发现,一些中国顶尖研究人员相信自己已经拥有弱形式的 RSI。 大体上被描述为受时间或算力约束的 RSI。对我们的描述是:RSI 的早期内核中,研究人员亲自介入,「手动辅助」模型加速走向它本来要去的方向,以节省算力或时间,或两者兼省。(附注:这个阶段的「起飞」可能最像 90 年代末到 2010 年代初的「半人马国际象棋」时代——机器加人在一起,强过任何单独的人或单独的机器。)
十、一个关键分岔: 假设自我改进在一阶近似上随算力扩展,那么「美国位置」看起来很强:两家实验室目前各自运行约 2 GW 算力,各自已签约超过 5 GW,2030 年目标是约 30 GW。理论上,有可观的收入和热情的资本市场输血,运行算力约束下的自催化「自我改进」循环,中国将没有硅片可以跟上。反之,如果约束最终被证明是验证质量(verification quality),或者时间线拖长到中国的底层优化和国产芯片达到够用水准之后,我们很可能会看到过去 18 个月那条贯穿线的延续甚至加速:美国前沿模型能力日益商品化,中国开源权重模型日益无处不在,以及一个正在浮现的机会——美国垂直 AI 公司在外国开源权重之上做微调,多余的量和利润流向推理服务商,至少目前是超大规模云厂商和新兴云厂商。这假设电力基础设施的中位预测成立。我们还应该指出,在我们看来,对中美双方的评估基础设施做一次严肃、冷静的分析,可能是剩下的分析工作中回报率最高的一项。
临别的一些想法:
十一、非常有这样一种未来:美国前沿实验室关闭未来几代最强模型的 API 访问。 实际上,现有状态对绝大多数程序化企业用例已经够用。未来的高端模型将按价值而非用量定价,这样做同时会限制中国从美国实验室蒸馏真正前沿能力的空间。实验室将用高增长的走量 API 收入,换取高价格、低用量的模型使用,作为回报,切断来自太平洋对岸的竞争与商品化威胁。至少,这会迫使中国进行严格的对标美国规模的预训练,给东方现有的算力卡点施加压力。据我们所知,在下一代前沿模型的科学、工程和数学能力上,这已经在发生。
十二、在我们看来,AI 已经把美国和中国的技术深深缠绕在一起,监管已无法简单地剪断这条跨太平洋的线。 此刻还假设或试图这样做,往好听了说也是天真的。中美两国的技术人员,某种意义上正通过蒸馏、开源权重、数据标注、推理,以及日益增长的软件 harness 和智能体搜索基础设施彼此对话。目前流传的那类简单粗暴的限制——实体清单、托管禁令、采购禁令——几乎肯定会扼杀美国创新,并在这些品类上让出领导地位,不可避免地招来快速跟随的中国竞争者。
十三、尽管西方对 AI 高估值议论纷纷,中国的氛围明显更加狂热。 考虑到更低的收入数字(见第七点),中国头部实验室的交易估值倍数比美国前沿实验室高五到十倍,而收入却小一到两个数量级: Moonshot 7 月底以 350 亿美元估值完成 35 亿美元私募轮——约为其约 3 亿美元 ARR 的 115 倍——并且已在香港 IPO 前酝酿 500 亿美元的投前估值新一轮,相比之下 Anthropic 约为 20 倍。早期上市的标的股价波动剧烈:智谱(在香港以「知识图谱科技」Knowledge Atlas Technology 上市,HKG:2513)市值 1 月从 130 亿美元起步,上市后超过 1000 亿美元,7 月底回落到约 700 亿美元;MiniMax(HKG:0100)则从 150 亿美元到 330 亿美元再回到 100 亿美元以下,走了一个来回。两只股票都在解禁期临近时大跌。我们的看法是,这在很大程度上源于一个不够成熟的公开市场:它习惯了二十年的消费软件投资,才刚刚开始围绕企业和开源框架建立金融承销的成熟度。这与我们在中国和香港两地公开指数的生物科技板块看到的情况并无二致。我们还要指出:如果中共哪天能打消跨界和专业科技及生物科技投资人对监管风险的顾虑,对合适的投资人来说,在中国和香港的早期公开市场上建立这些品类的领导地位,存在一个大机会。
你们的合伙人,
Nan、Adam、Zavain
脚注
¹ DeepSeek V3 技术报告;2,048 张 H800,PTX 级编程,132 个 SM 中的 20 个专门用于跨节点通信。
² OpenRouter 周度 token 份额(2025–26 年从 <2% 升至 45%+);Qwen:截至 2026 年 3 月 Hugging Face 累计下载量 10 亿次,约 18 万个衍生模型(超过 Google 和 Meta 之和);约 80% 的数字出自 2026 年一份美国关于中国开源软件渗透的咨询报告。
³ Anthropic 已正式指控 Moonshot、DeepSeek 和 MiniMax 抓取了数百万条 Claude 对话。我们在实地的交流中,此事被当作显而易见的事实佐证。 ⁴ 两家公司的 S-1 文件公开之前,我们暂不评论两者「年化收入口径」在会计处理上的差异。
⁵ 阿里巴巴和字节跳动在东南亚数据中心训练在 4 月 H20 限制后加速;接入方式是与泰国、马来西亚和日本非中资所有的设施签订租赁协议。白宫 OSTP 主任指称 Moonshot 为 K3 训练使用了位于泰国的 GB300 服务器。马来西亚、印度尼西亚和泰国规划中的 100MW+ 数据中心有 31 座,而目前运营的只有两座。出口管制目前管的是芯片所有权,而非远程访问。北京在 2026 年 3 月限制了国家机构使用美国智能体软件。
⁶ 两国政府目前都在试图通过对开源权重模型的潜在管制来应对这一点。已发布的权重无法召回,所以任何脱钩只适用于未来的流动。
 AI 速览